不用手工维护代码表
股票、ETF、基金、指数、货币、加密货币的代码与元数据(名称、国家、行业、板块、市值等)以 pandas DataFrame 一次性返回。省掉的是「从各处网页抄代码再校对」这类无法复现的工作。
JerBouma / 证券数据库
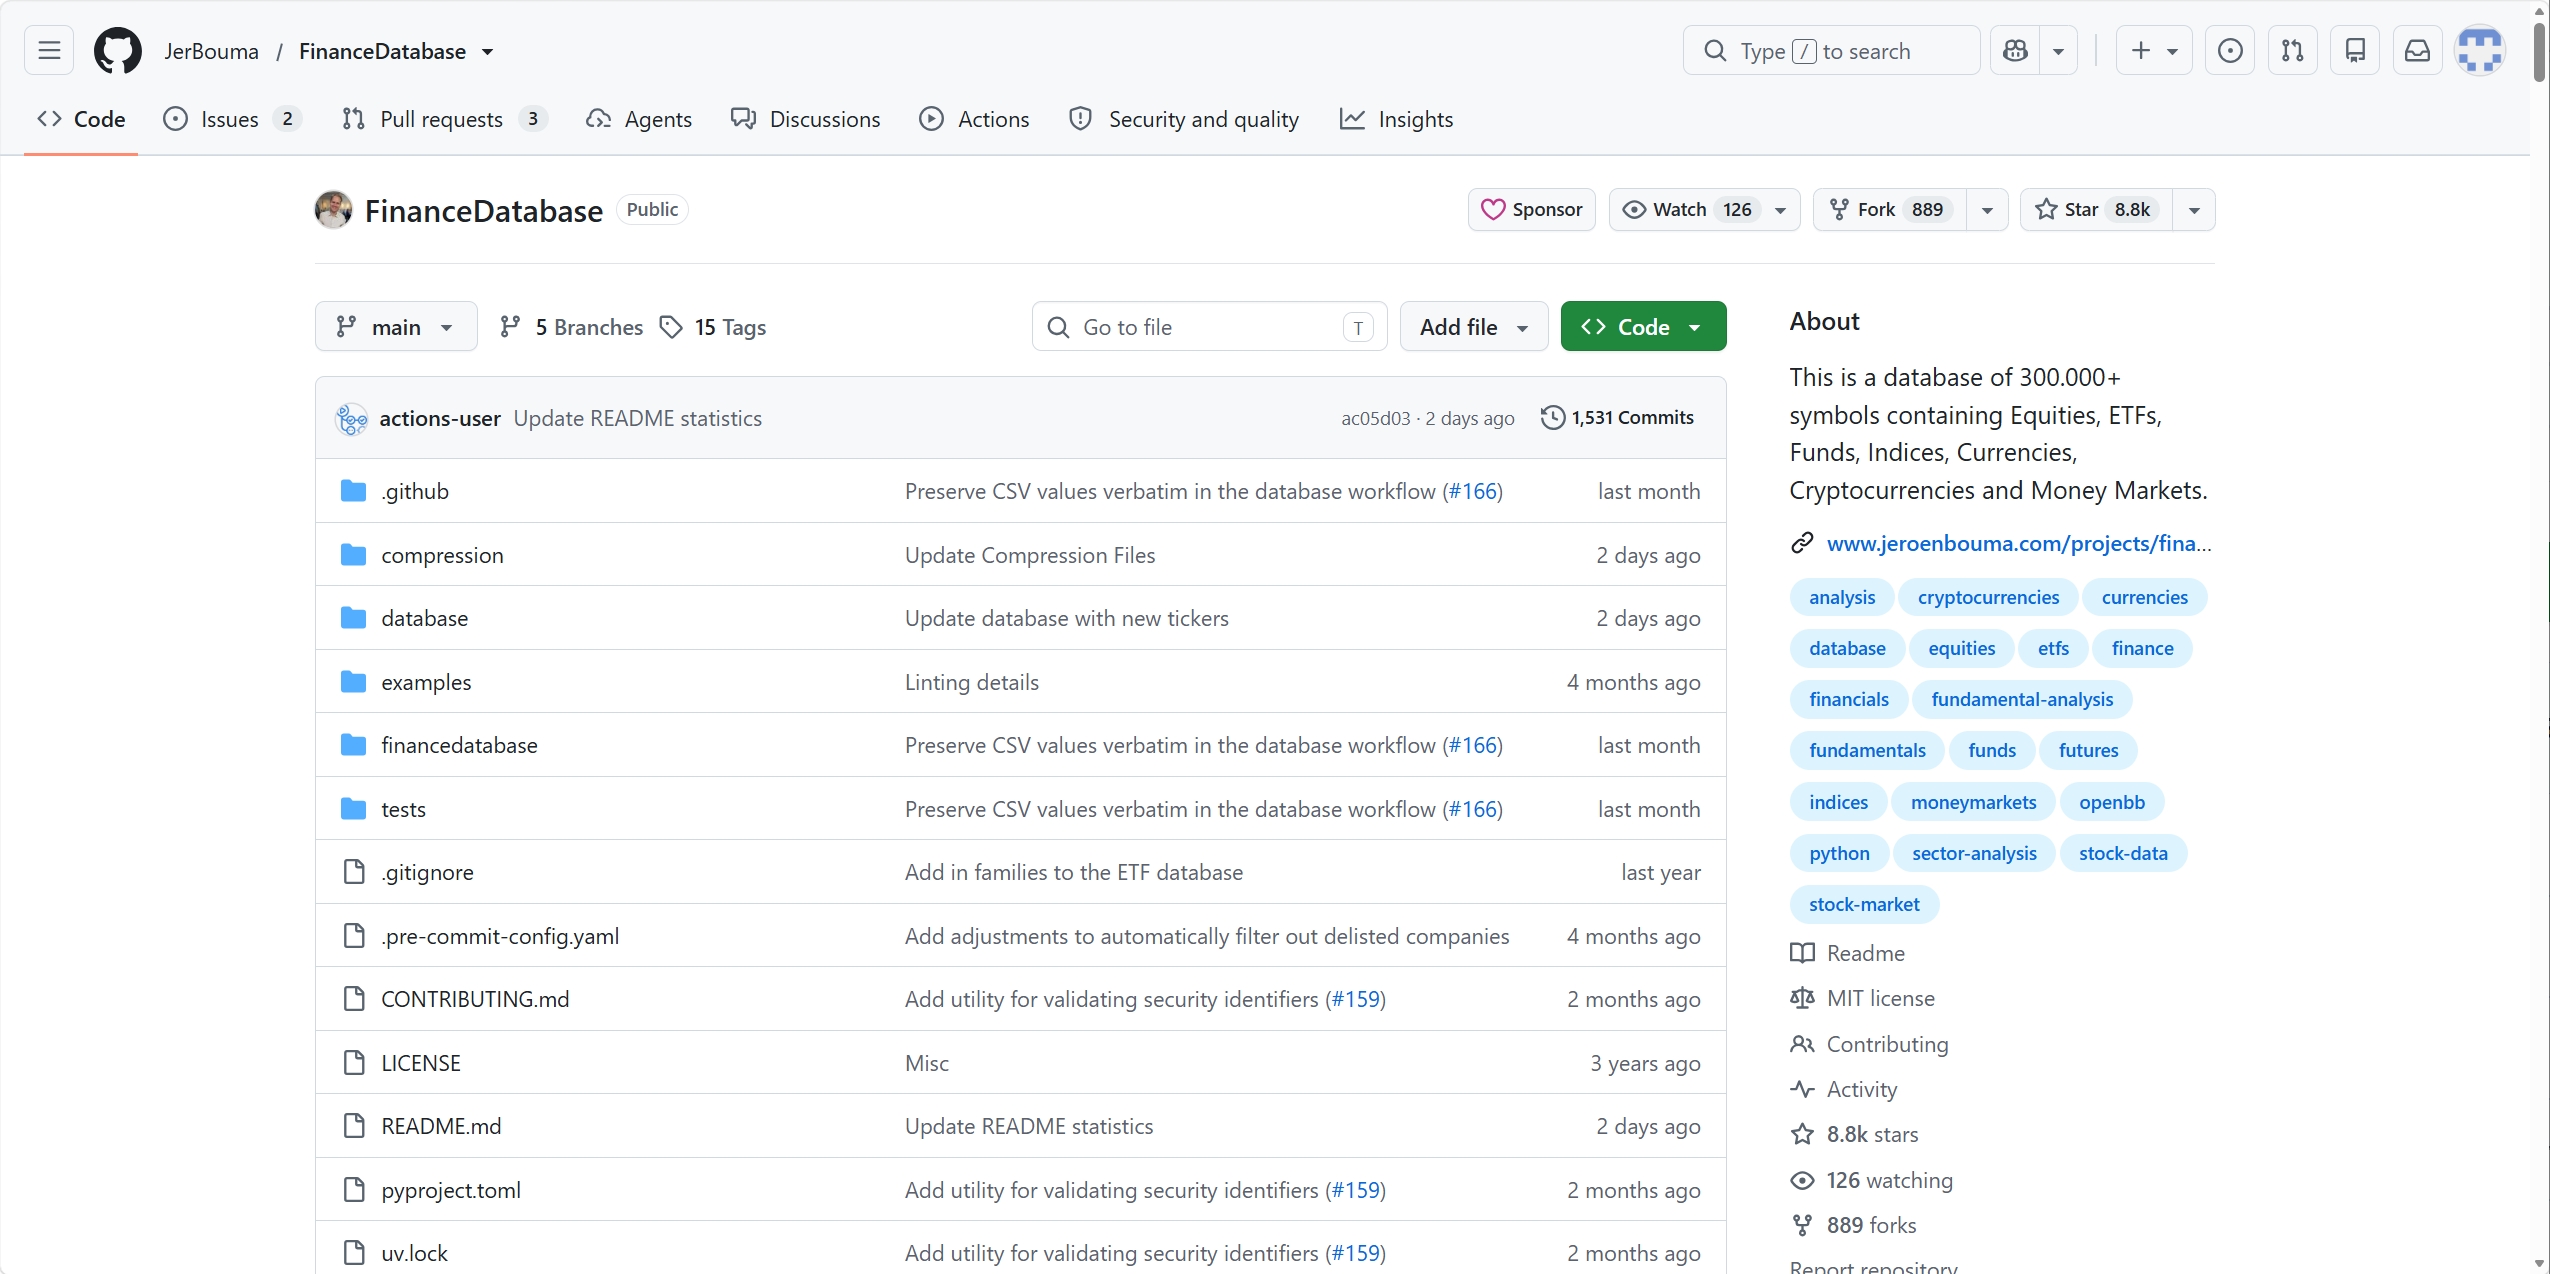
FinanceDatabase 是一个用 Python 查询金融证券的开源库,收录 30 万+ 证券(股票、ETF、基金、指数、货币、加密货币)的代码与元数据。它把「按国家/行业/市值筛选证券、按名称搜索证券」整理成一套简洁 API,适合量化研究者、金融数据工程师与想快速批量找股票代码的用户。
JerBouma/FinanceDatabase 仓库页面(MIT 许可,30 万+ 证券);star 数以页面实际显示为准,采集日期 2026-09-08。
 查看固定版本源码
事实核验卡(核验日期 2026-09-29)
以上数字来自本站 2026-09-29 在 Windows + Python 3.11.9 + financedatabase 2.4.0 下的真实运行输出,不是从文章里转抄的;数据文件由上游持续更新,行数会变,以官方 PyPI 与 GitHub Release 为准。采集时 GitHub star 约 9,374(2026-09-29)。
它把「找证券代码、按条件筛选证券、按名称搜索证券」整理成一条可复现的数据查询链路,让证券列表获取更轻量。下面先看它挡掉的三类重复劳动,再看具体任务该调哪个函数。
股票、ETF、基金、指数、货币、加密货币的代码与元数据(名称、国家、行业、板块、市值等)以 pandas DataFrame 一次性返回。省掉的是「从各处网页抄代码再校对」这类无法复现的工作。
按国家、行业、板块、市值筛选股票列表,条件写在调用参数里而不是手工勾选。同一段筛选逻辑可以在不同时间重跑,结论可追溯。
用 search() 按名称模糊搜索,不需要先背下精确代码。search() 是类方法,先在目标类上调用,结果就不会混入别的资产类别。
| 你要做的事 | 对应调用 | 返回什么 | 适用场景 | 注意点 |
|---|---|---|---|---|
| 一次性列出某类全部证券 | Equities().select() 等 无参数 select() | 该类证券列表(代码 + 元数据列) | 先看全貌、统计行业或国家分布 | 总量在 30 万+ 量级,整表拉取较慢,先筛选更实际 |
| 按国家筛股票 | Equities().select(country="...") | 该国股票列表 | 只看单一市场、做区域对比 | 国家名按官方文档的英文写法传参 |
| 按行业或板块筛 | Equities().select(sector=... / industry=...) | 同行业股票列表 | 行业轮动研究、同业对照 | 行业分类口径由上游数据决定,以官方数据为准 |
| 按市值分档筛 | Equities().select(market_cap=...) | 对应市值档位的股票列表 | 大盘 / 中小盘风格切分 | 市值字段可能滞后于当日行情,别当作实时值 |
| 按名称模糊搜索 | Equities().search(name="...") | 匹配到的证券列表 | 只记得名称、不记得代码 | 不加限定会跨类别匹配,建议配合 database= |
| 搭多资产标的池 | ETFs / Funds / Indices / Currencies / Cryptos 各类 | 各类证券的代码与元数据 | ETF、指数、外汇、加密一起做对照 | 各类之间不做去重,代码含义不完全通用 |
首页只保留跑通所需的主干;每步给出命令与预期看到的结果,细节见 API 手册与首次运行页。
通过 pip 安装后,用 import financedatabase as fd 导入。它声明的直接依赖只有一个(financetoolkit),但实测会连带装上 pandas 3.0、numpy 2.4、scikit-learn、yfinance 等 35 个包,所以务必装进虚拟环境。
先 Equities().select() 看一类证券的全貌,再用 Equities().select() 按国家、行业、板块、市值收窄范围。两步都在 Python 里完成;但要注意每次实例化资产类都会去 GitHub 取数据文件,实测 equities.bz2 单个文件就有 14.9 MB。
本库不提供价格。拿到代码后要另接行情数据源(同类开源项目或券商接口),这一步的成本常被低估,见下方对照表。
python -m venv .venv 建虚拟环境,激活后执行 pip install financedatabase。预期输出:pip 拉取 financedatabase 与 pandas 并提示安装成功。
python -c "import financedatabase as fd; print(fd.__file__)"。预期输出:打印出该包的安装路径;若报 ModuleNotFoundError,说明装到了另一个解释器环境。
equities = fd.Equities().select() 后 print(equities.shape)。预期输出:形如 (行数, 列数) 的形状元组,行数是该类证券条数。
fd.Equities().select(country="United States", sector="Technology")。预期输出:仅包含该国该行业股票的 DataFrame,列与 无参数 select()一致。
无参数 select() 负责「列出」,select 负责「按条件收窄」,search 负责「按名字找」。七类证券各有一套 show / select 函数,函数名以官方 README 为准。下表把「拿到什么结果」与「什么时候别用它」放在同一行,方便直接过滤掉不合适的选项。
| 证券类别 | 主要函数 | 覆盖内容 | 适用场景 | 注意点 |
|---|---|---|---|---|
| 股票 Equities | Equities().select() | 代码、名称、国家、行业、板块、市值等 | 选股池搭建、行业与地区分布研究 | 只有元数据,没有价格与成交量 |
| ETF | ETFs().select() | ETF 代码与元数据 | 被动投资标的池、与个股做对照 | ETF 与股票列表分开,不做跨类去重 |
| 基金 Funds | Funds().select() | 基金代码与元数据 | 基金筛选、同类基金横向列表 | 分类口径以官方数据为准 |
| 指数 Indices | Indices().select() | 指数代码与元数据 | 基准对照、指数清单维护 | 不含成分股名单与历史点位 |
| 货币 Currencies | Currencies().select() | 货币 / 外汇对代码 | 外汇标的清单、多币种记账 | 不含汇率报价 |
| 加密货币 Cryptocurrencies | Cryptos().select() | 加密货币代码与元数据 | 加密标的清单 | 不同交易所的代码差异以官方为准 |
| 货币市场 Moneymarkets | Moneymarkets().select() | 货币市场工具清单 | 现金管理与短端工具研究 | 覆盖范围以官方 README 为准 |
search(),不必先猜类别。API 参数的完整对照见「API 手册」页。同一个目标——拿到一份可用的证券清单与行情——两条路线的准备成本完全不同。两侧结构对称列出,便于直接比较。
灵活度最高:筛选逻辑、更新节奏、字段口径都在自己手里;代价是环境、依赖与行情源都要自己维护。
# 1. 安装与导入
pip install financedatabase
import financedatabase as fd

# 2. 展示一类证券
equities = fd.Equities().select()

# 3. 按国家 / 行业筛选
us_tech = fd.Equities().select(country="United States",
                             sector="Technology")

# 4. 拿代码去配行情源(本库不含价格)
print(us_tech[["name", "symbol", "sector"]])
前置条件:本机 Python 环境 + pip 可联网;行情环节需另外选定数据源并处理其访问限制。
这条路线的数据源、额度、网络与市场覆盖由各技能自身决定,彼此不同,也不代表本数据库已被集成。
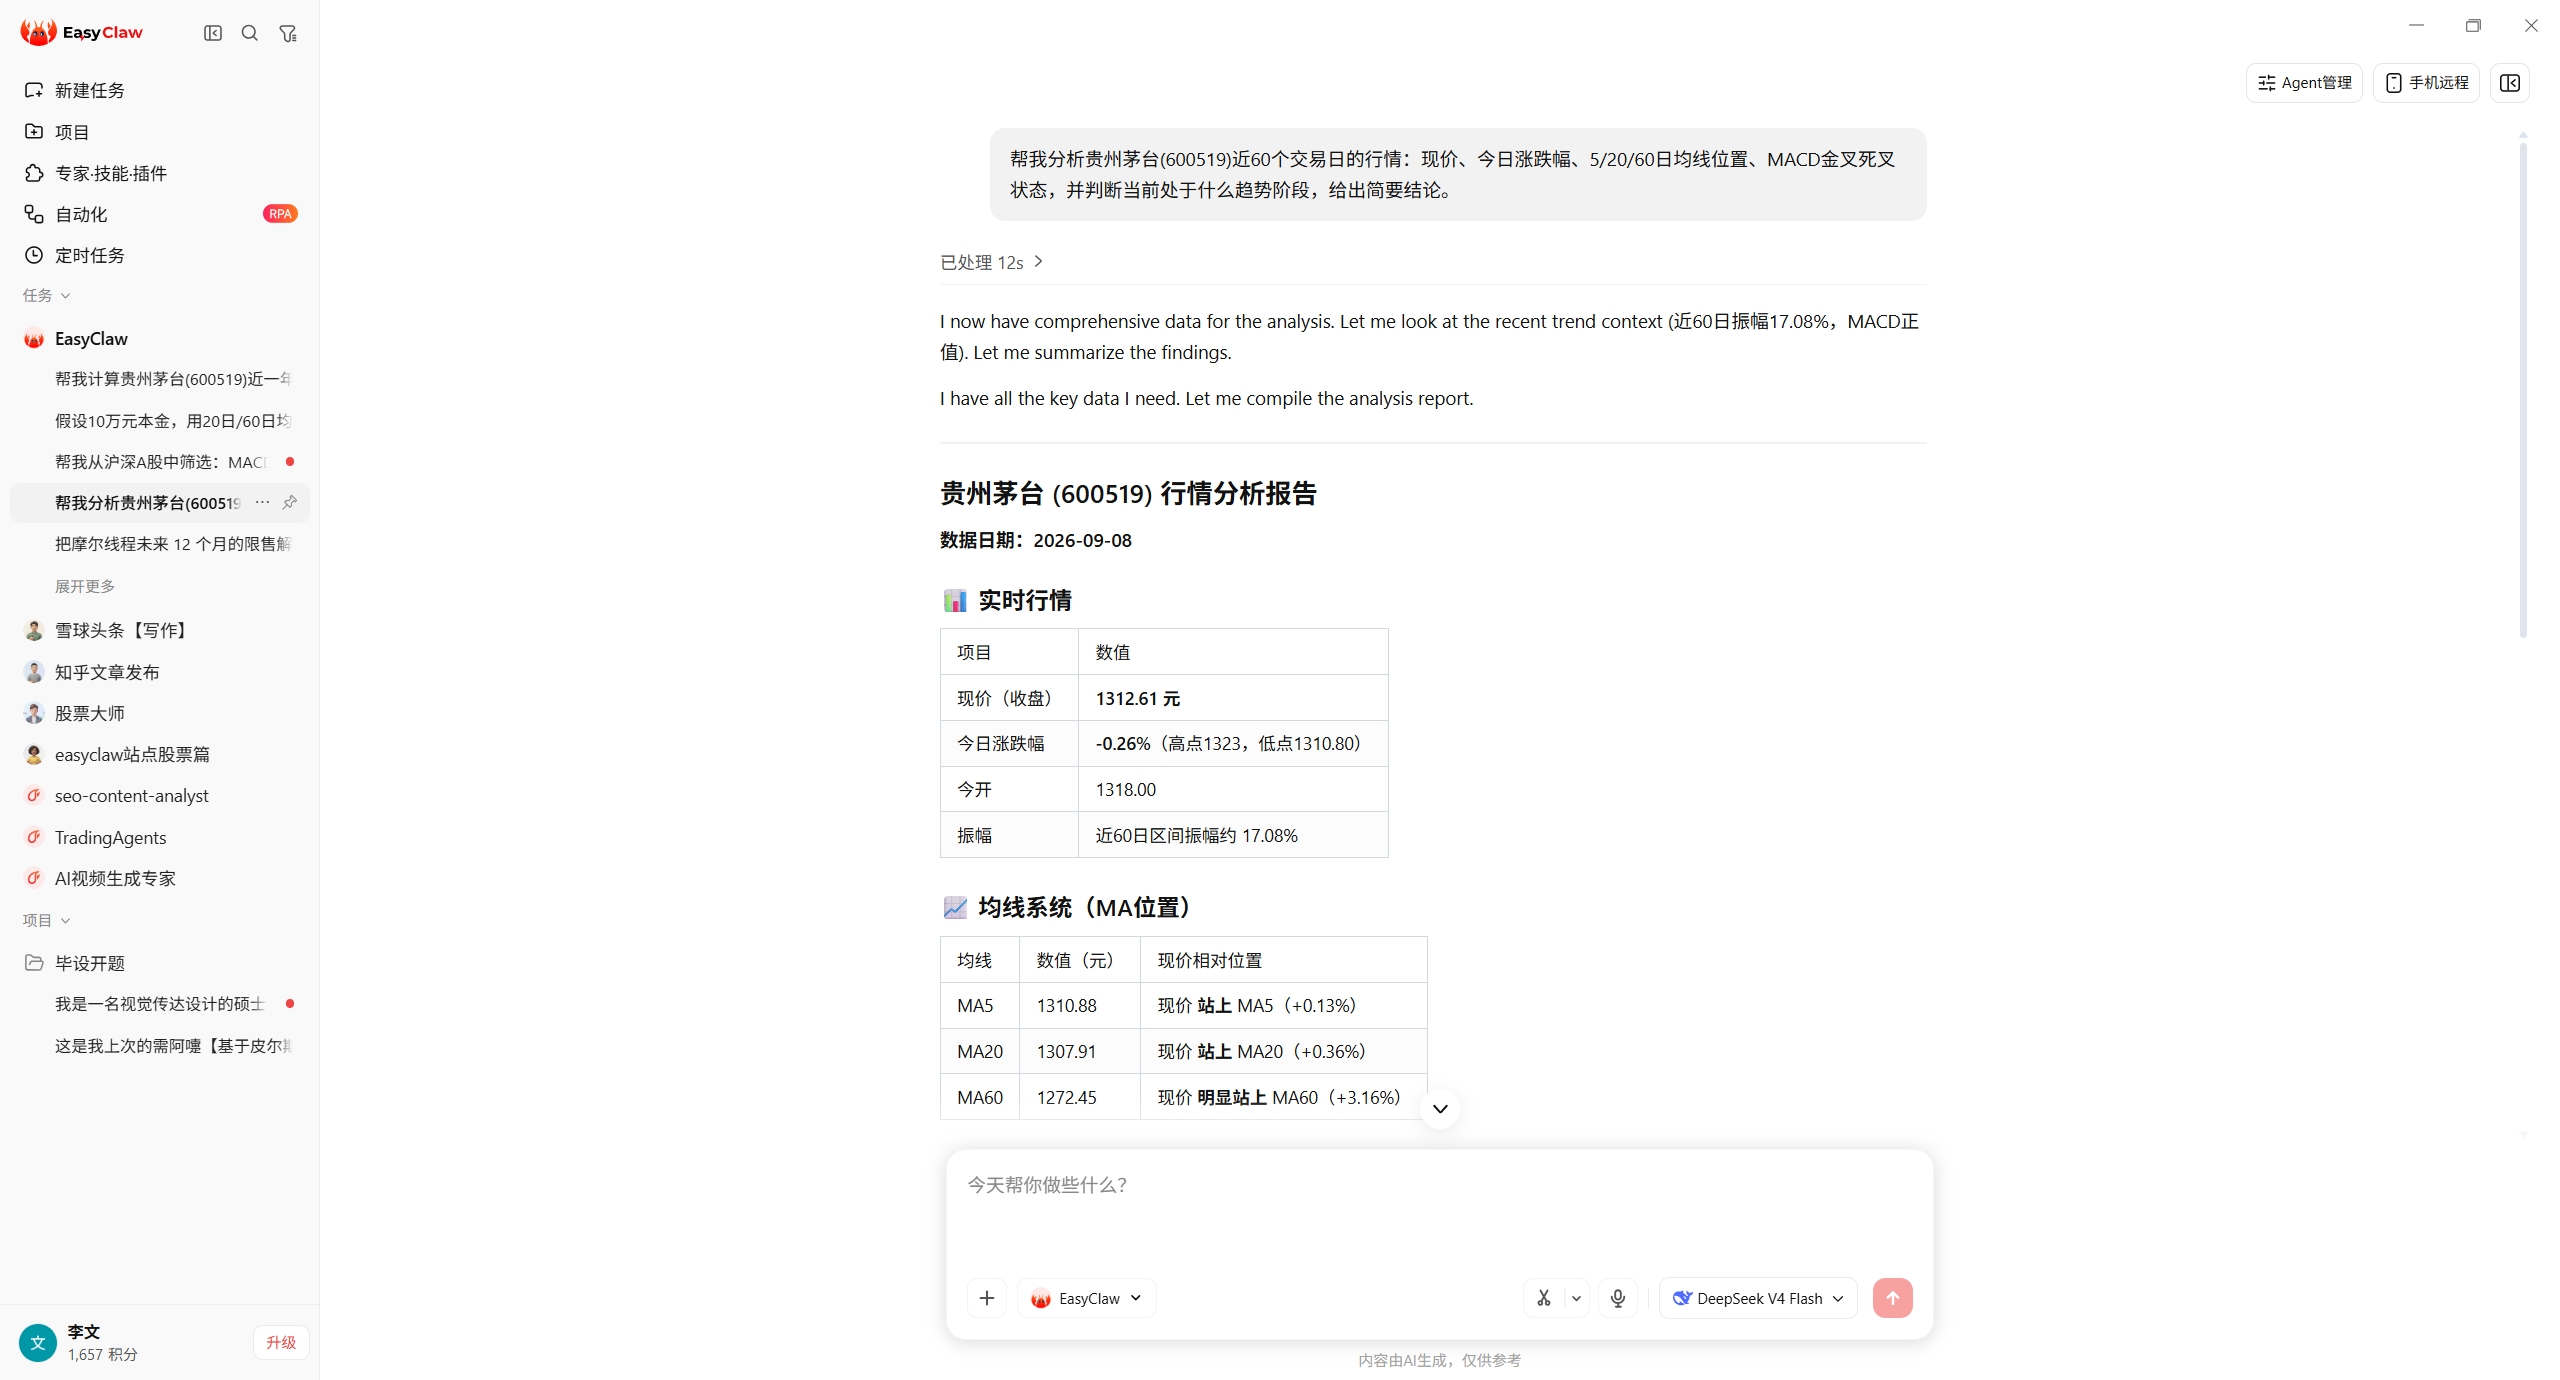
下面这张截图是本机对话的实拍:一句话发起任务,直接返回带数字的结果。它不是本数据库的运行结果,而是「免部署提问」这一类路线的准备成本参照;两者之间无已证实集成,仅供研究。
| 同一件事的环节 | 自建路线的动作 | 提问路线的动作 | 主要差异 | 什么时候必须自建 |
|---|---|---|---|---|
| 确定标的 | 写 search() 或 Equities().select() 拿到代码 | 直接在问题里写出名称或代码 | 自建结果可落库复用,提问结果随对话留存 | 标的需要每天批量刷新 |
| 取行情 | 另选数据源并写取数代码 | 由当次调用的技能负责取数 | 字段口径与可得性由各自数据源决定 | 需要固定字段口径与历史回溯 |
| 算指标 | 自己写均线、MACD、波动率等计算 | 在问题里要求算某个指标 | 自建可复现,提问依赖当次输出 | 指标定义需要与研究口径一致 |
| 批量执行 | 循环调用,结果可写入文件或数据库 | 通常按单次任务提问 | 规模差异明显,批量化是自建强项 | 标的数量在数百以上 |
| 结果留存 | 输出文件、入库、进版本管理 | 以对话记录形式留存 | 可审计性不同 | 结论需要被复核或对外引用 |
| 上手成本 | 环境 + 依赖 + 数据源三件事 | 装客户端后直接提问 | 前期成本与长期可控性互为代价 | 长期重复使用且要求稳定口径 |
这是 FinanceDatabase 最容易被误解的一点——它是标的清单,不是行情终端。下面把常被拿来搭配的几类数据源放在一起对照,帮助判断还要补哪一环。
| 行情来源类型 | 定位 | 通常能拿到 | 通常拿不到 | 适合场景 | 注意点 |
|---|---|---|---|---|---|
| 同类开源工具箱(如 FinanceToolkit 等) | 与证券清单配套的分析工具箱 | 财务指标、比率类数据与分析口径 | 不一定覆盖所有市场与全部频率 | 基本面研究、比率计算 | 能力边界以各项目官方文档为准 |
| 通用行情接口库(如 yfinance 等) | 面向公开行情接口的取数库 | 日线等历史行情与部分基本面字段 | 不保证实时性,接口可用性受上游影响 | 研究型回测、教学演示 | 上游服务条款与限流以官方为准 |
| 国内财经数据接口库(如 akshare 等) | 面向国内市场的接口集合 | 国内行情、宏观、基金等类别数据 | 字段口径与海外数据源不一致 | A 股与国内市场研究 | 接口可用性与字段变更以官方为准 |
| 综合数据平台(如 OpenBB 等) | 多数据源聚合的访问层 | 多源数据统一入口与多种调用方式 | 默认能力取决于所配数据源 | 需要多源切换与统一出口 | 数据源授权与配额以官方为准 |
| 券商 / 交易所接口 | 交易与行情的一手通道 | 权限内行情与交易能力 | 通常要求开户、鉴权与合规流程 | 实盘与准生产环境 | 接入门槛与费用以各家官方为准 |
| 自建数据仓库 | 自己落库的行情与元数据集 | 任意口径的历史数据,含复权与对齐处理 | 需要自己解决采集、清洗与更新 | 长期稳定复现的研究流程 | 维护成本会随时间上升 |
| 本机技能路线 | 免部署的提问式入口 | 按问题返回当次的数据结果 | 不提供可版本化的数据表 | 快速验证一个想法 | 与本数据库无已证实集成 |
这些问题官方 README 往往答得比较简略,下面给出一句可直接用的回答与需要继续确认的边界。
| 问题 | 一句话回答 | 需要继续确认的边界 | 细节页 |
|---|---|---|---|
| 免费吗? | 仓库以开源许可发布(以仓库 LICENSE 文件为准) | 许可只覆盖代码与数据文件本身;上游数据源的使用条款另算 | 边界页 |
| 有中文文档吗? | 官方资料以英文为主(以仓库文档为准) | 本站是中文导航,不等于官方中文文档,函数与参数请回到官方核对 | 下载部署页 |
| 能查 A 股吗? | 覆盖范围以官方数据为准,国内标的建议与国内数据源交叉确认 | 不要假定国内外市场全覆盖;先小范围试查再决定是否依赖 | 证券类别页 |
| 数据多久更新一次? | 以官方仓库的发布节奏为准,本库不承诺实时 | 元数据类字段(如市值)本身就可能滞后于当日行情 | 证券类别页 |
| 能取实时行情吗? | 不能。本库不含价格、成交与实时行情 | 需要行情必须另接数据源,见本页「拿到代码之后还差什么」 | 边界页 |
| 和国内行情接口库什么区别? | 定位不同:本库是标的清单与元数据,国内接口库偏行情与数据接口集合 | 两者可以组合使用:本库定标的,接口库取数 | 证券类别页 |
| 商用可以吗? | 以仓库许可与上游数据源条款为准 | 本站不构成法律意见;对外发布前请自行确认授权范围 | 边界页 |
| 一定要写代码吗? | 是。它是 Python 库,没有图形界面 | 只想出图或看结论,可先用提问式路线验证想法,再决定是否自建 | 首次运行页 |
边界比功能更需要先确认——选错工具的时间成本远高于读一段说明。
做行业分布统计、搭选股池、维护跨市场标的表,需要一份可重复执行的清单来源。把筛选条件写成代码后,下次直接重跑即可。
研究结论需要被复核,标的范围与筛选条件必须可追溯。代码化的筛选流程天然满足这一点,也便于进版本管理。
只关心价格走势与技术指标的话,本库帮不上忙——它不含行情。这种情况直接用行情接口或提问式路线更快。
官方资料以英文为主,库也没有图形界面。如果没有 Python 基础,前期学习成本会明显高于收益。
标的清单可以来自本库,但用于实盘判断的行情与财务数据,应来自具备授权与稳定性的正式数据源。
代码许可宽松,不代表上游数据可以任意分发。对外发布含数据的成果前,先确认上游条款,以官方说明为准。
同一套调用可以拿到不同国家与不同类别证券的列表,做地区或资产类别横向对照时,不需要为每个市场单独找一份代码表,字段也基本一致。
查询依赖访问上游数据源,内网隔离或代理策略严格的机器上可能长时间无返回。这类环境需要先确认网络出口,再谈能不能用。
不要一上手就拉全表。先用一个熟悉的行业或市场跑一次筛选,确认字段、返回体量与耗时都符合预期,再把这套流程扩到正式研究里。
下面这张表是本站 2026-09-29 用 pip 装到的 2.4.0 实跑出来的,不是从文档里转抄的。「远端首次加载」指没有本地缓存、需要先从 GitHub 取 .bz2 数据文件的那一次;「本地缓存加载」指把数据文件放进 site-packages/compression/ 之后。
| 数据类别 | 实测行数 × 列数 | 字段数 | 远端首次加载 | 本地缓存加载 | 主要用途 |
|---|---|---|---|---|---|
| 股票 Equities | 112,718 × 21 | 21 列 | 16.6 秒 | 2.9 秒 | 按国家/行业/市值建池、跨市场对照 |
| ETF ETFs | 36,481 × 9 | 9 列 | 3.3 秒 | 0.3 秒 | 被动标的口径、主题与行业暴露 |
| 基金 Funds | 57,853 × 8 | 8 列 | 4.1 秒 | 0.6 秒 | 主动型产品清单、与 ETF 分开看 |
| 指数 Indices | 91,181 × 7 | 7 列 | 3.4 秒 | 0.4 秒 | 找基准代码、做对照 |
| 货币 Currencies | 2,556 × 5 | 5 列 | 1.4 秒 | 0.0 秒 | 计价货币与外汇对识别 |
| 加密货币 Cryptos | 3,367 × 6 | 6 列 | 1.3 秒 | 0.0 秒 | 加密标的清单 |
| 货币市场 Moneymarkets | 1,367 × 5 | 5 列 | 1.2 秒 | 0.0 秒 | 现金管理与短端工具 |
.bz2 数据文件加起来约 19.2 MB,全部来自 raw.githubusercontent.com 的 compression/ 目录——也就是说,「装完就能离线用」并不成立,首次查询必须能连上这个地址。加载耗时随网络波动,上表是本站单次实测值,不代表你的机器。「能查到一份清单」只是第 0 步。真正决定结论对不对的,是字段口径、去重方式和能力边界——这三件事各有一页专门做实测,而不是停留在 API 说明。
实测 country="China" 命中 6,775 行,但这些标的分散在 34 个交易所里——country 表示公司所属国家,不是上市地。这一页给出 .SS/.SZ/.HK 与各数据源的代码映射、跨市场重复标的的识别方法,以及一个反直觉的实测结论:按主上市地去重不能用 only_primary_listing。
同一家公司会在多个交易所出现,ISIN 只有 9,406 个不同取值却覆盖 112,718 行,industry 缺失 35.54%,market_cap 是六档标签而不是市值数字。symbol 是索引不是列——用 search(symbol="TSLA") 会打印一句提示然后返回全部 112,718 行。
本库不提供行情、财报与实时数据。下游可以接 yfinance、AKShare、OpenBB 或回测框架;官方的衔接入口是 to_toolkit(),实测调用耗时 40.1 秒并返回 Toolkit 对象,且不带 FMP API Key 时只能用 Yahoo Finance 的 5 年基本面数据。
基于 Python 的开源金融证券数据库,通过 select / search / show_options 三类方法 查询股票、ETF、基金、指数、货币、加密货币等类别的代码与元数据,结果以 pandas DataFrame 返回。函数名与参数以官方 README 为准。
不提供。只有证券的代码与元数据(名称、国家、行业、板块、市值等),不含价格、成交量与实时行情;实际行情需另接数据源,来源对照见本页「拿到证券代码之后还差什么」。以官方 README 为准。
需要。它是库而不是软件,要用 Python 调用 API 查询证券,面向有 Python 基础或愿意先学一段的用户。如果只想直接看结论,可先用免部署的提问路线验证想法。
多数情况是装到了另一个解释器环境。先按首次运行页给出的导入自检命令确认包的安装路径;若报错,改用 python -m pip install 配合完整包名安装,保证装进同一个解释器。具体依赖版本约束以 PyPI 页面为准。
股票、ETF、基金、指数、货币(外汇)、加密货币、货币市场七类,每类有对应的 show / select 函数;各类之间不做跨类去重。完整清单以官方 README 为准。
不能单独完成。它只负责标的清单,回测还需要行情数据、回测框架与撮合/成本假设三块,按研究口径自行选择组合,以所用各组件的官方文档为准。
无已证实集成。本机技能目录覆盖财经数据、选股、技术分析与量化研究等方向,属于独立路线;本库与它之间没有官方集成证据,也没有互相替代的官方说明。