向量化回测
用 NumPy 二维数组一次运算多标的、多参数,避免 Python 逐事件循环的对象开销。代价是策略必须能用数组表达,强路径依赖的逻辑要改写成可由数组推导的规则。
vectorbt / polakowo · Python
本手册把 vectorbt 定位为批量策略研究工具:价格数据、信号、资产和参数先广播成矩阵,再交给 NumPy、Numba 或可选 Rust 路径计算,最后从 Portfolio 的 orders、trades、drawdowns 与统计结果复核。重点不是证明它跑得多快,而是说明何时适合向量化、成本和成交假设是什么,以及如何判断历史结果是否稳健。未标为实测的代码仅作官方文档导读,不宣称已在本站环境运行。
仓库页面显示约 9.0k Star / 1.2k Fork;该数字随社区活动变化,采集日期为 2026-09-07。
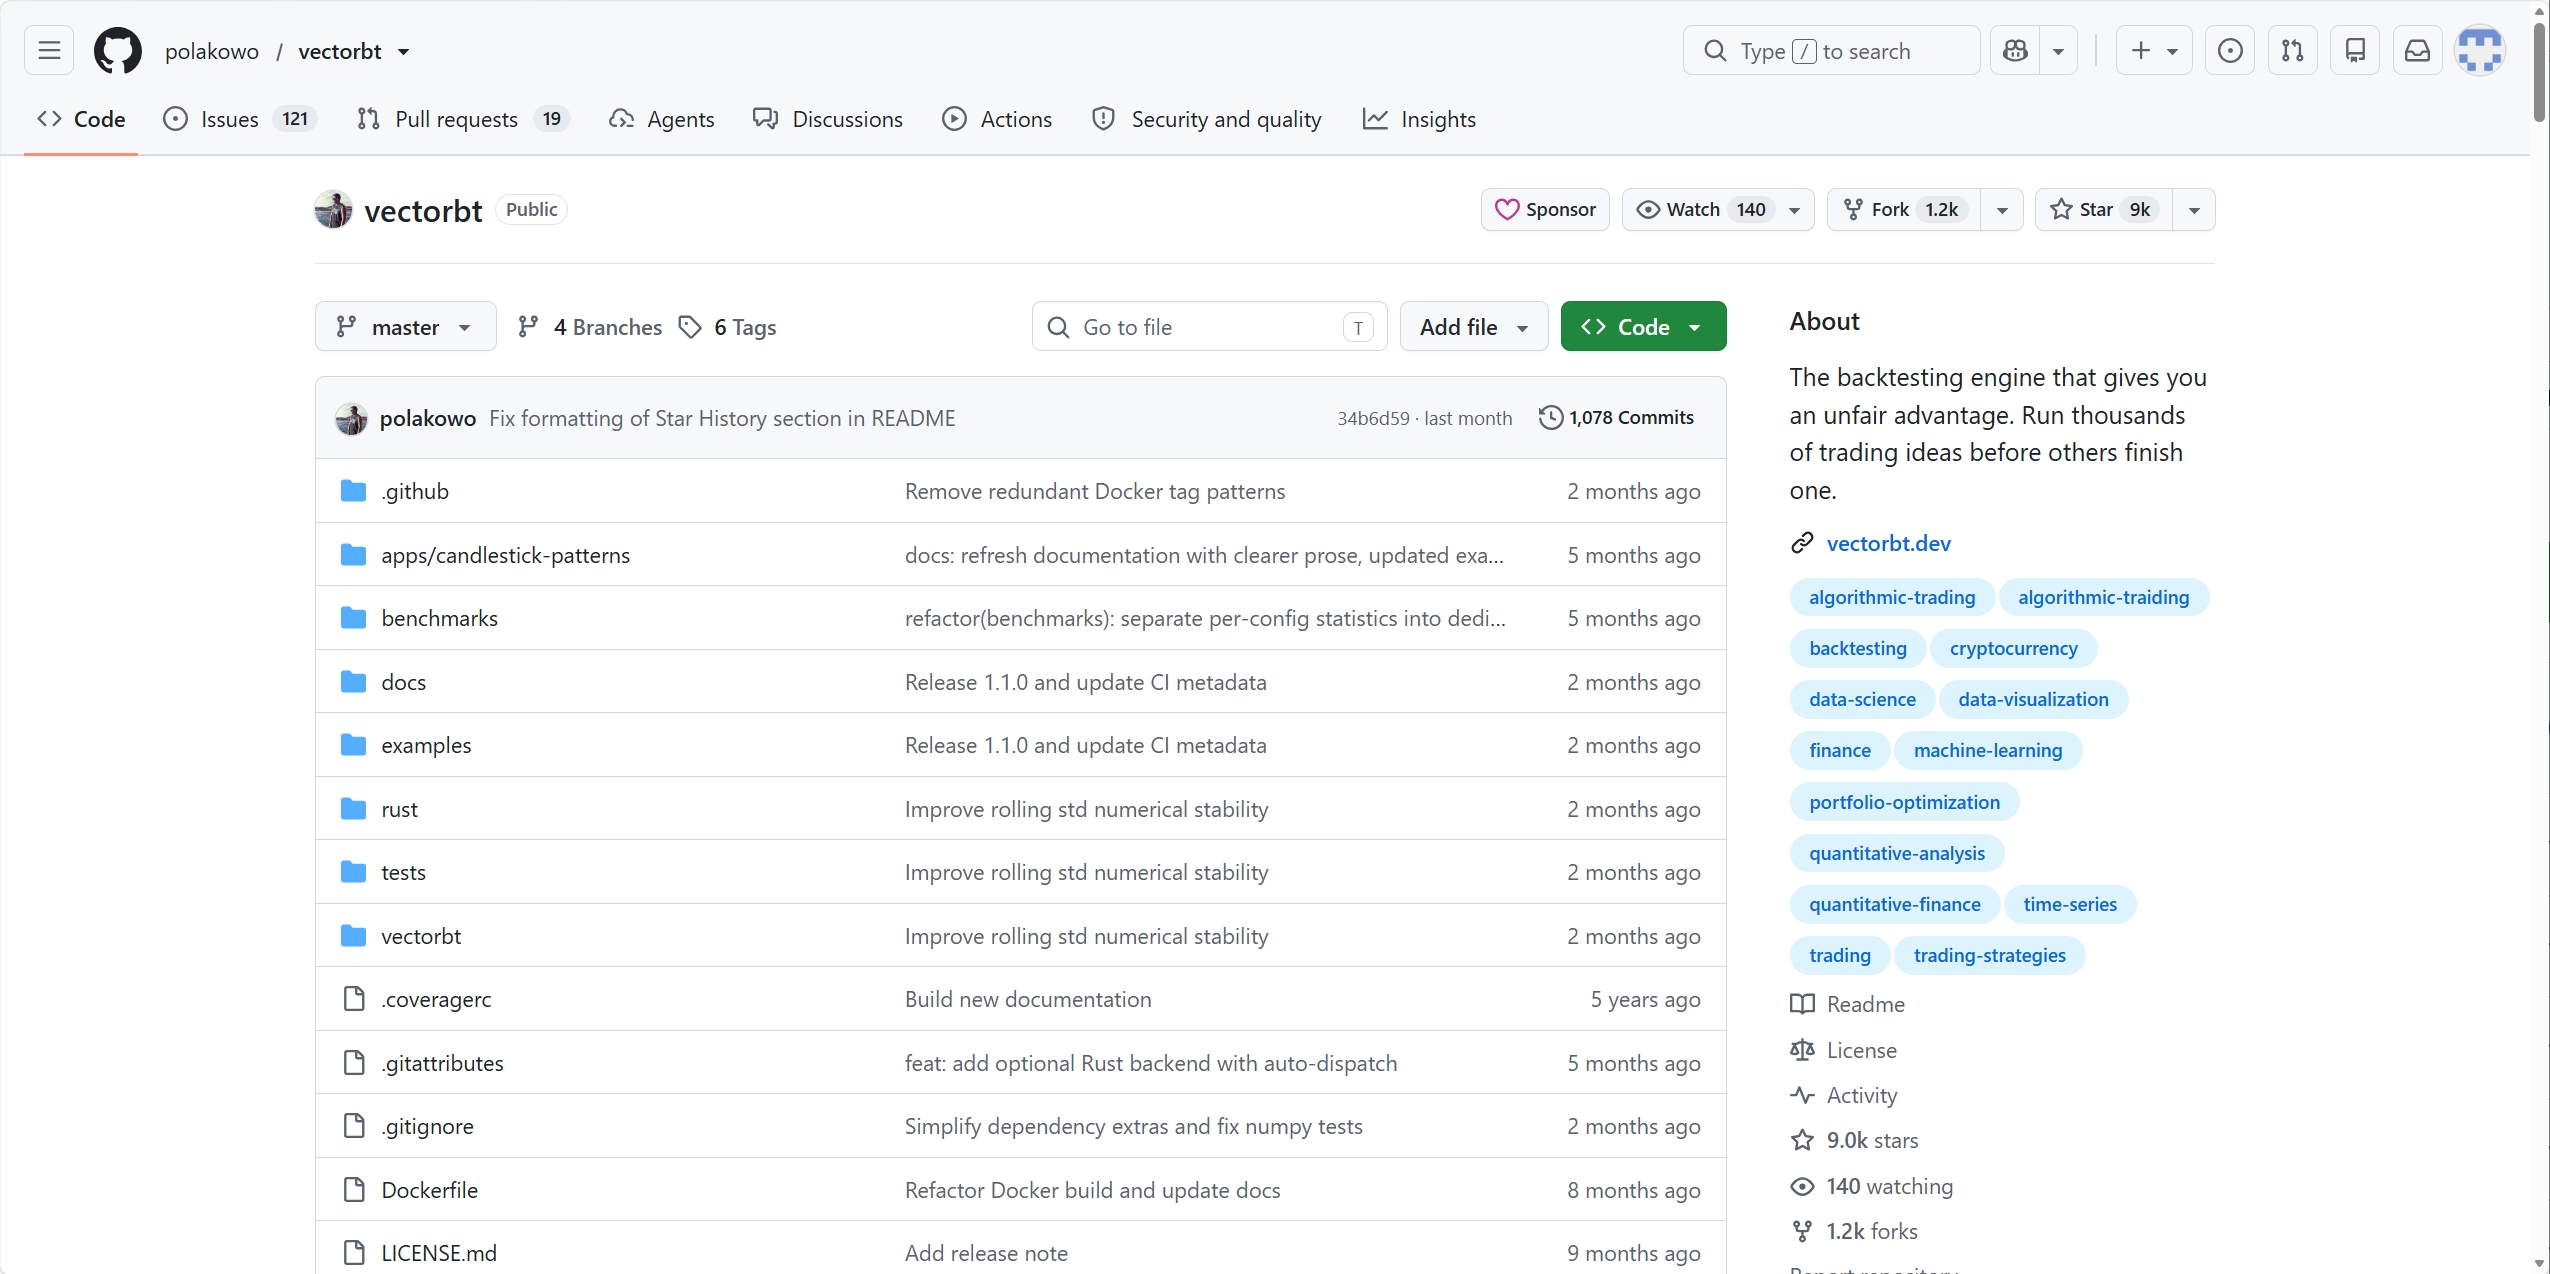 查看固定版本源码
价格数据、信号、资产与参数先广播为批量矩阵,经过向量化计算形成组合记录,再以统计、订单与风险视图复核。该流程服务于批量研究,不代表策略有效、可交易或可直接用于实盘。
用 NumPy 二维数组一次运算多标的、多参数,避免 Python 逐事件循环的对象开销。代价是策略必须能用数组表达,强路径依赖的逻辑要改写成可由数组推导的规则。
通过广播机制一次回测大量参数组合,配合热力图定位参数稳定区间,而不是盯单点最高收益。适合做参数敏感性检查,但结果仍要防过拟合。
内置移动均线、布林带等指标,可集成 TA-Lib / Pandas TA;组合回测可与 QuantStats 打通输出绩效统计,省去自己搭一套统计报表。
基于 Plotly 的交互式图表可直接在 Jupyter 里查看,官方还提供自动化运行与 Telegram 通知方向的能力,便于把批量回测挂到定时任务上。
首页只保留理解所需的六步,每一步的具体命令与参数见对应子页。
固定价格数据的行索引、资产列和参数维度,保留原始快照与字段说明。输入先做对齐和缺失检查,避免广播把错位数据扩成更大的错误结果。
信号、资产与参数沿维度组合,适合一次比较多个可解释的候选设定。组合数乘法增长,先估算内存并用小网格验证,不能把扫描量当成证据强度。
NumPy/Numba 承担主要数值路径,官方另有可选 Rust 安装路线。首次 JIT 编译与后续重复运行应分开计时;本站不引用未经同机复测的固定加速倍数。
从 orders、trades、positions 与 drawdowns 等记录检查触发、持仓变化和回撤区间。若只看总收益或热力图颜色,无法发现成交时点、成本和数据对齐问题。
确认 freq、样本区间、基准、手续费、滑点和成交价格后再比较年化收益与风险指标。任一口径变化都可能改变统计值,报告应保留这些假设。
比较邻近参数区域、样本外区间和滚动窗口,而非只挑一个最高点。连续的参数高地比孤立收益尖峰更可信,但不构成未来有效或可交易的保证。
按官方 README 与仓库模块结构整理,每一项都指向本站的具体页面。
| 研究环节 | 输入与输出 | 必须核对的问题 | 站内说明 |
|---|---|---|---|
| 价格数据 | 固定日期索引的 CSV/Parquet 或数据源表格 | 复权、交易日、缺失值口径是否明确? | 数据接入 |
| 信号与资产 | 布尔信号、资产列和参数维度 | 信号何时可知、股票池如何形成? | 指标信号 |
| 广播矩阵 | 沿资产、信号与参数维度扩展 | 组合规模与峰值内存是否可承受? | 参数扫描 |
| 数值计算 | NumPy/Numba 路径,可选 Rust 安装扩展 | 是否拆分首次编译与稳态计时? | 安装路线 |
| Portfolio 记录 | orders、trades、positions、drawdowns 等 | 订单与持仓是否符合成本和成交假设? | Portfolio |
| 绩效与图表 | 统计摘要、热力图、单配置复盘 | 频率、样本区间和基准是否一致? | 结果审计 |
| 样本外复核 | 未参与选参的时间段与滚动窗口 | 稳定区域能否跨窗口保留? | 稳健性验证 |
向量化广播适合多资产、多参数批量实验;事件驱动模型更自然地表达逐 bar 状态变化。实际适配取决于策略逻辑、成交假设与数据粒度,不以未经同环境测量的速度倍率判断。
| 维度 | 向量化(本项目路线) | 事件驱动框架 | 注意点 |
|---|---|---|---|
| 执行方式 | 整列 NumPy 数组一次运算 + Numba JIT | 逐 bar 循环模拟事件 | 首次运行有 JIT 编译预热时间,短任务感知明显 |
| 参数扫描 | 原生广播,一次跑大量参数组合 | 需外层循环逐个跑 | 组合数量爆炸时要注意内存与耗时 |
| 路径依赖 | 适合能写成数组规则的策略 | 适合持仓状态强相关的策略 | 止损、加仓这类状态逻辑需改写成可向量化的形式 |
| 适合场景 | 因子研究、参数调优、批量策略验证 | 精细撮合、逐笔委托与状态路径策略 | 研究阶段与执行阶段可使用不同工具,按问题选型 |
| 交易假设 | 需由数据和组合参数共同描述 | 通常通过逐 bar 事件推进状态 | 两类框架的成交价、手续费和订单语义不可直接类比 |
| 性能比较 | 受矩阵规模、Numba 预热和硬件影响 | 受策略循环、数据规模和实现影响 | 没有同机同口径基准前,不引用固定倍率 |
| 前置门槛 | pandas / NumPy 数据科学基础 | 事件循环与撮合模型理解 | 不熟悉广播机制容易写出错误的信号对齐 |
| 可视化与报告 | Plotly 交互图 + 绩效统计 | 自带分析器或需自行接图表库 | 报告口径不同,跨框架比较前要统一指标定义 |
两条路线的准备成本差别很大,先看你怎么用。
换来的是完整可控的研究工程:信号对齐、资金与手续费设定、参数扫描结果都由自己掌握,产物是可复用的 Python 代码;代价是要维护 Python 环境与数据更新,并具备 pandas/NumPy 基础。
前置条件:能安装 Python 包;行情数据需自备——本项目不含内置行情源。
本机已核验的 quant-analyst 覆盖金融建模、策略回测与风险指标方向,akshare-finance 与 tushare-finance 覆盖 A 股等行情数据,stock-technical-mastery 与 a-stock-analysis 覆盖 A 股技术分析与实时行情;但没有本框架对应的集成证据,不能视为本项目的替代安装方式。
前置条件:需先安装客户端;部分数据源需要 Token 或账号;输出仅供研究,不构成投资建议。
以下为本机对话的真实截图(点击左右箭头翻页),用于对照「自建管道:装环境 + 接数据 + 写信号」的准备成本。截图演示的是技能路线,不是本框架的运行结果;与本项目无已证实集成,仅供研究。
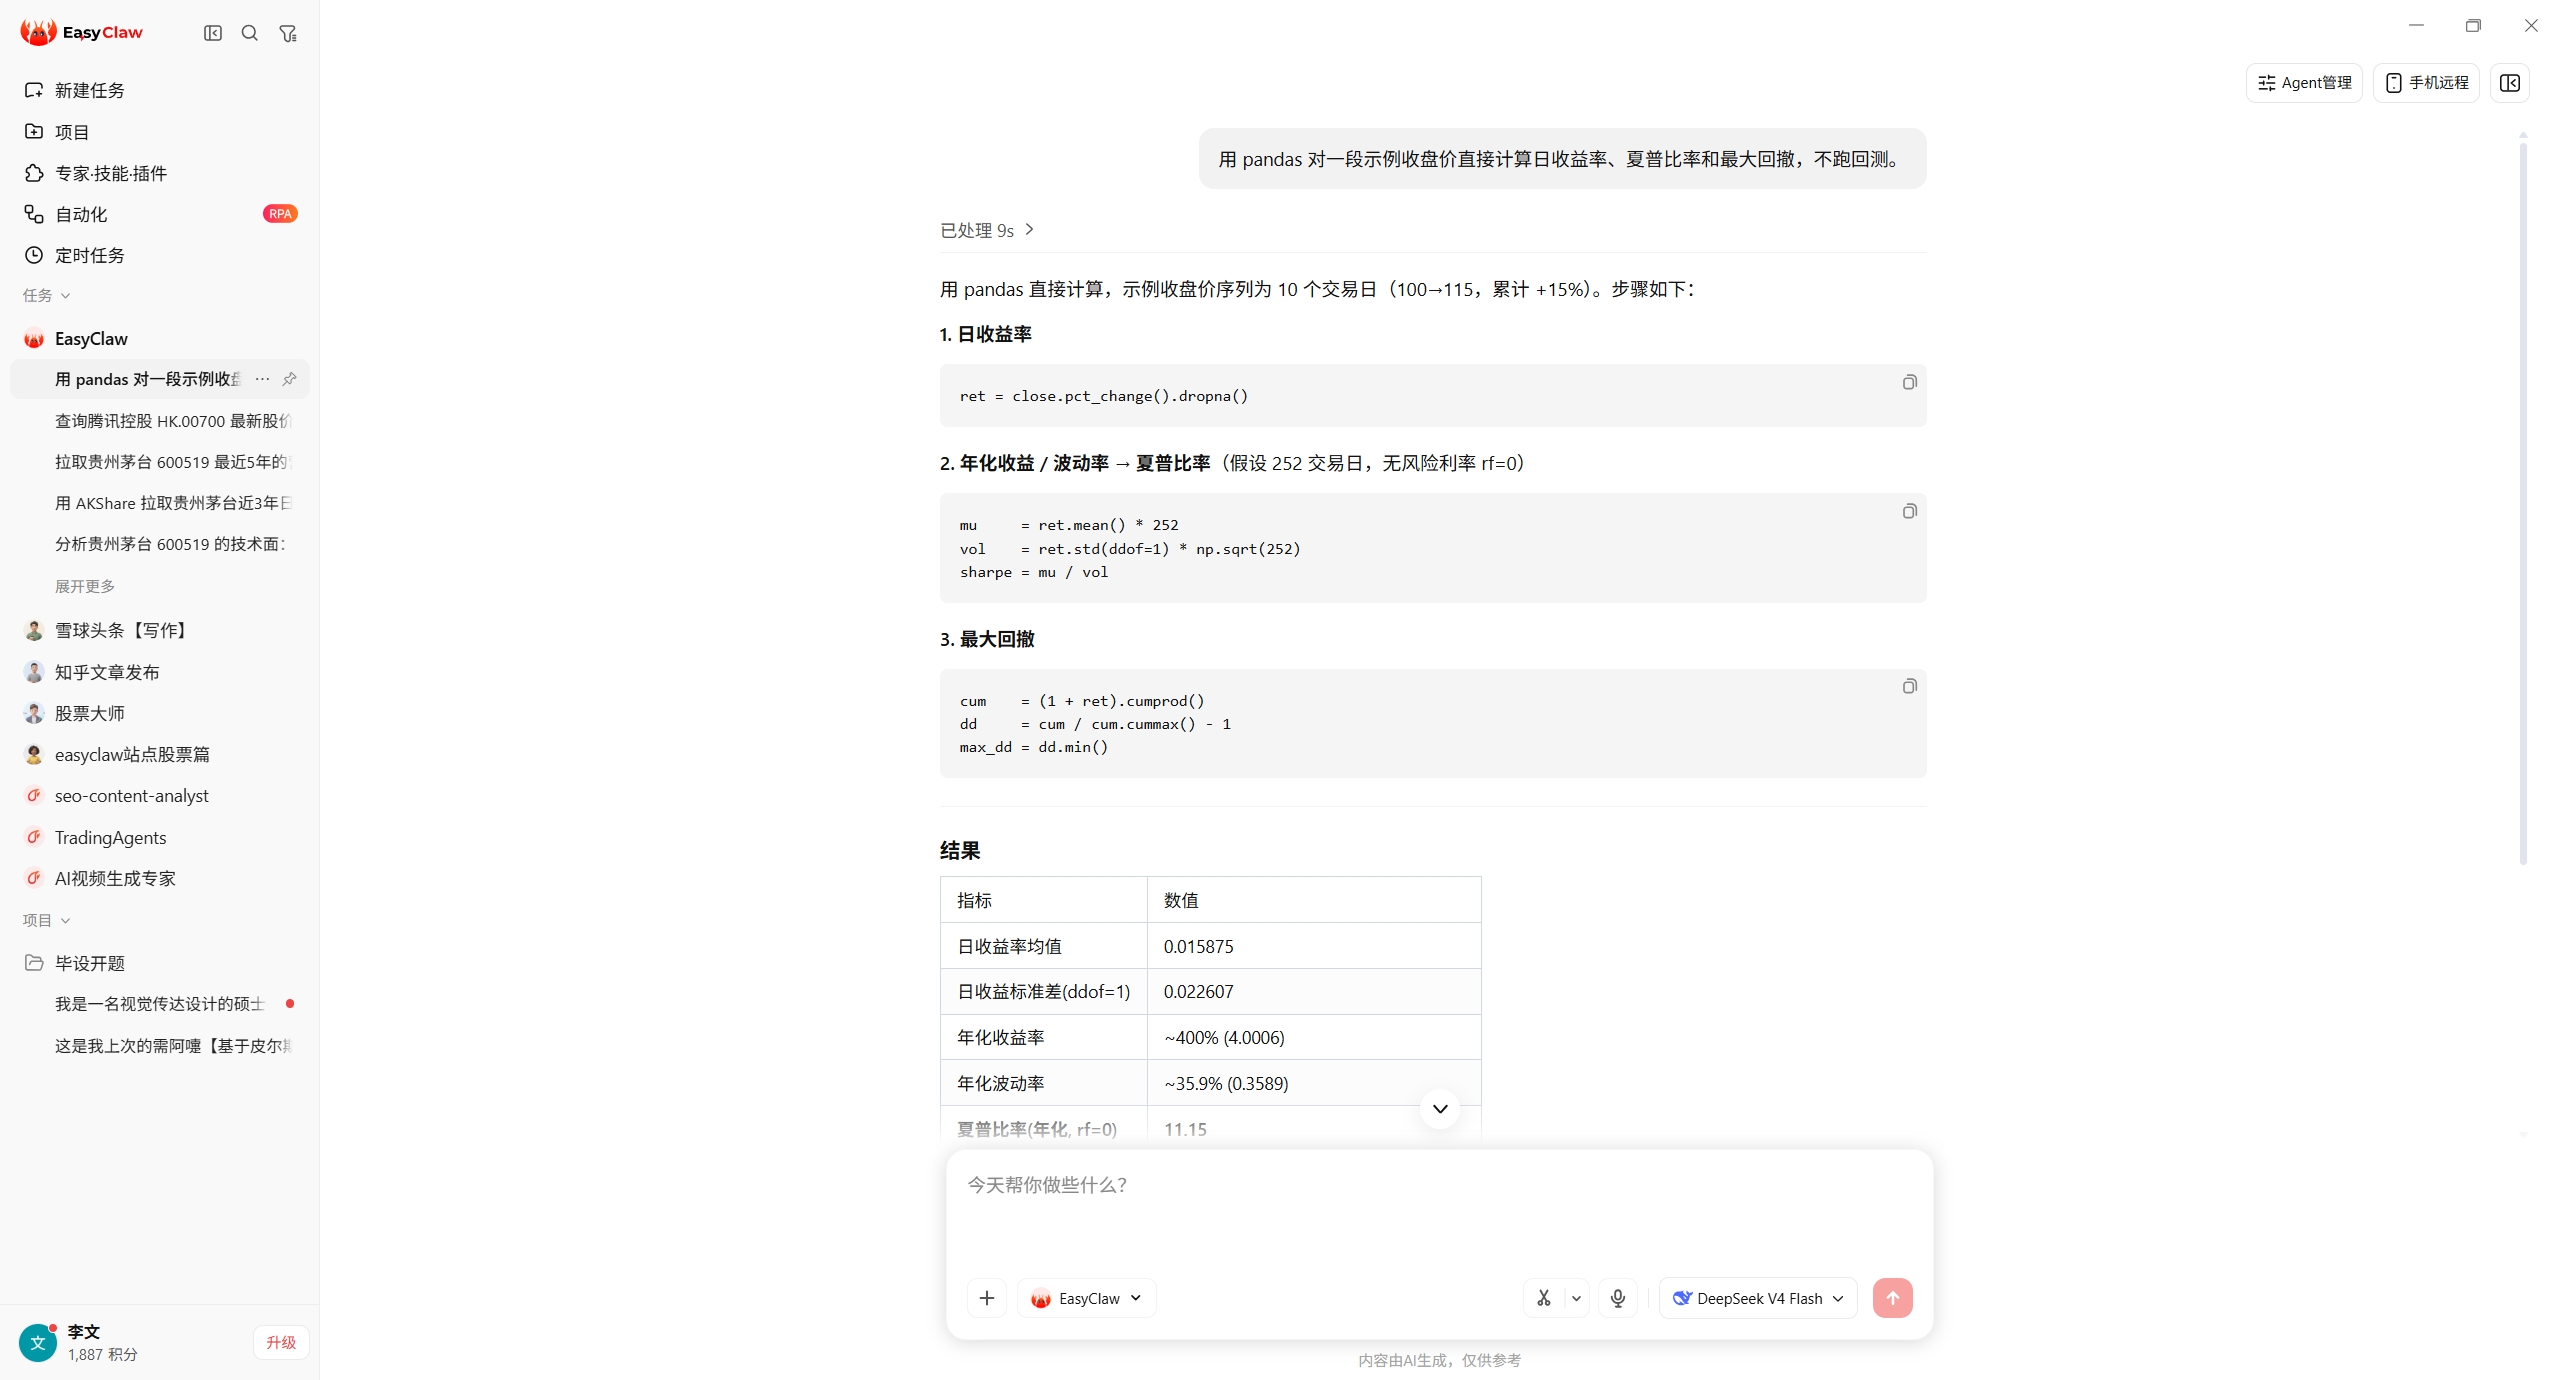
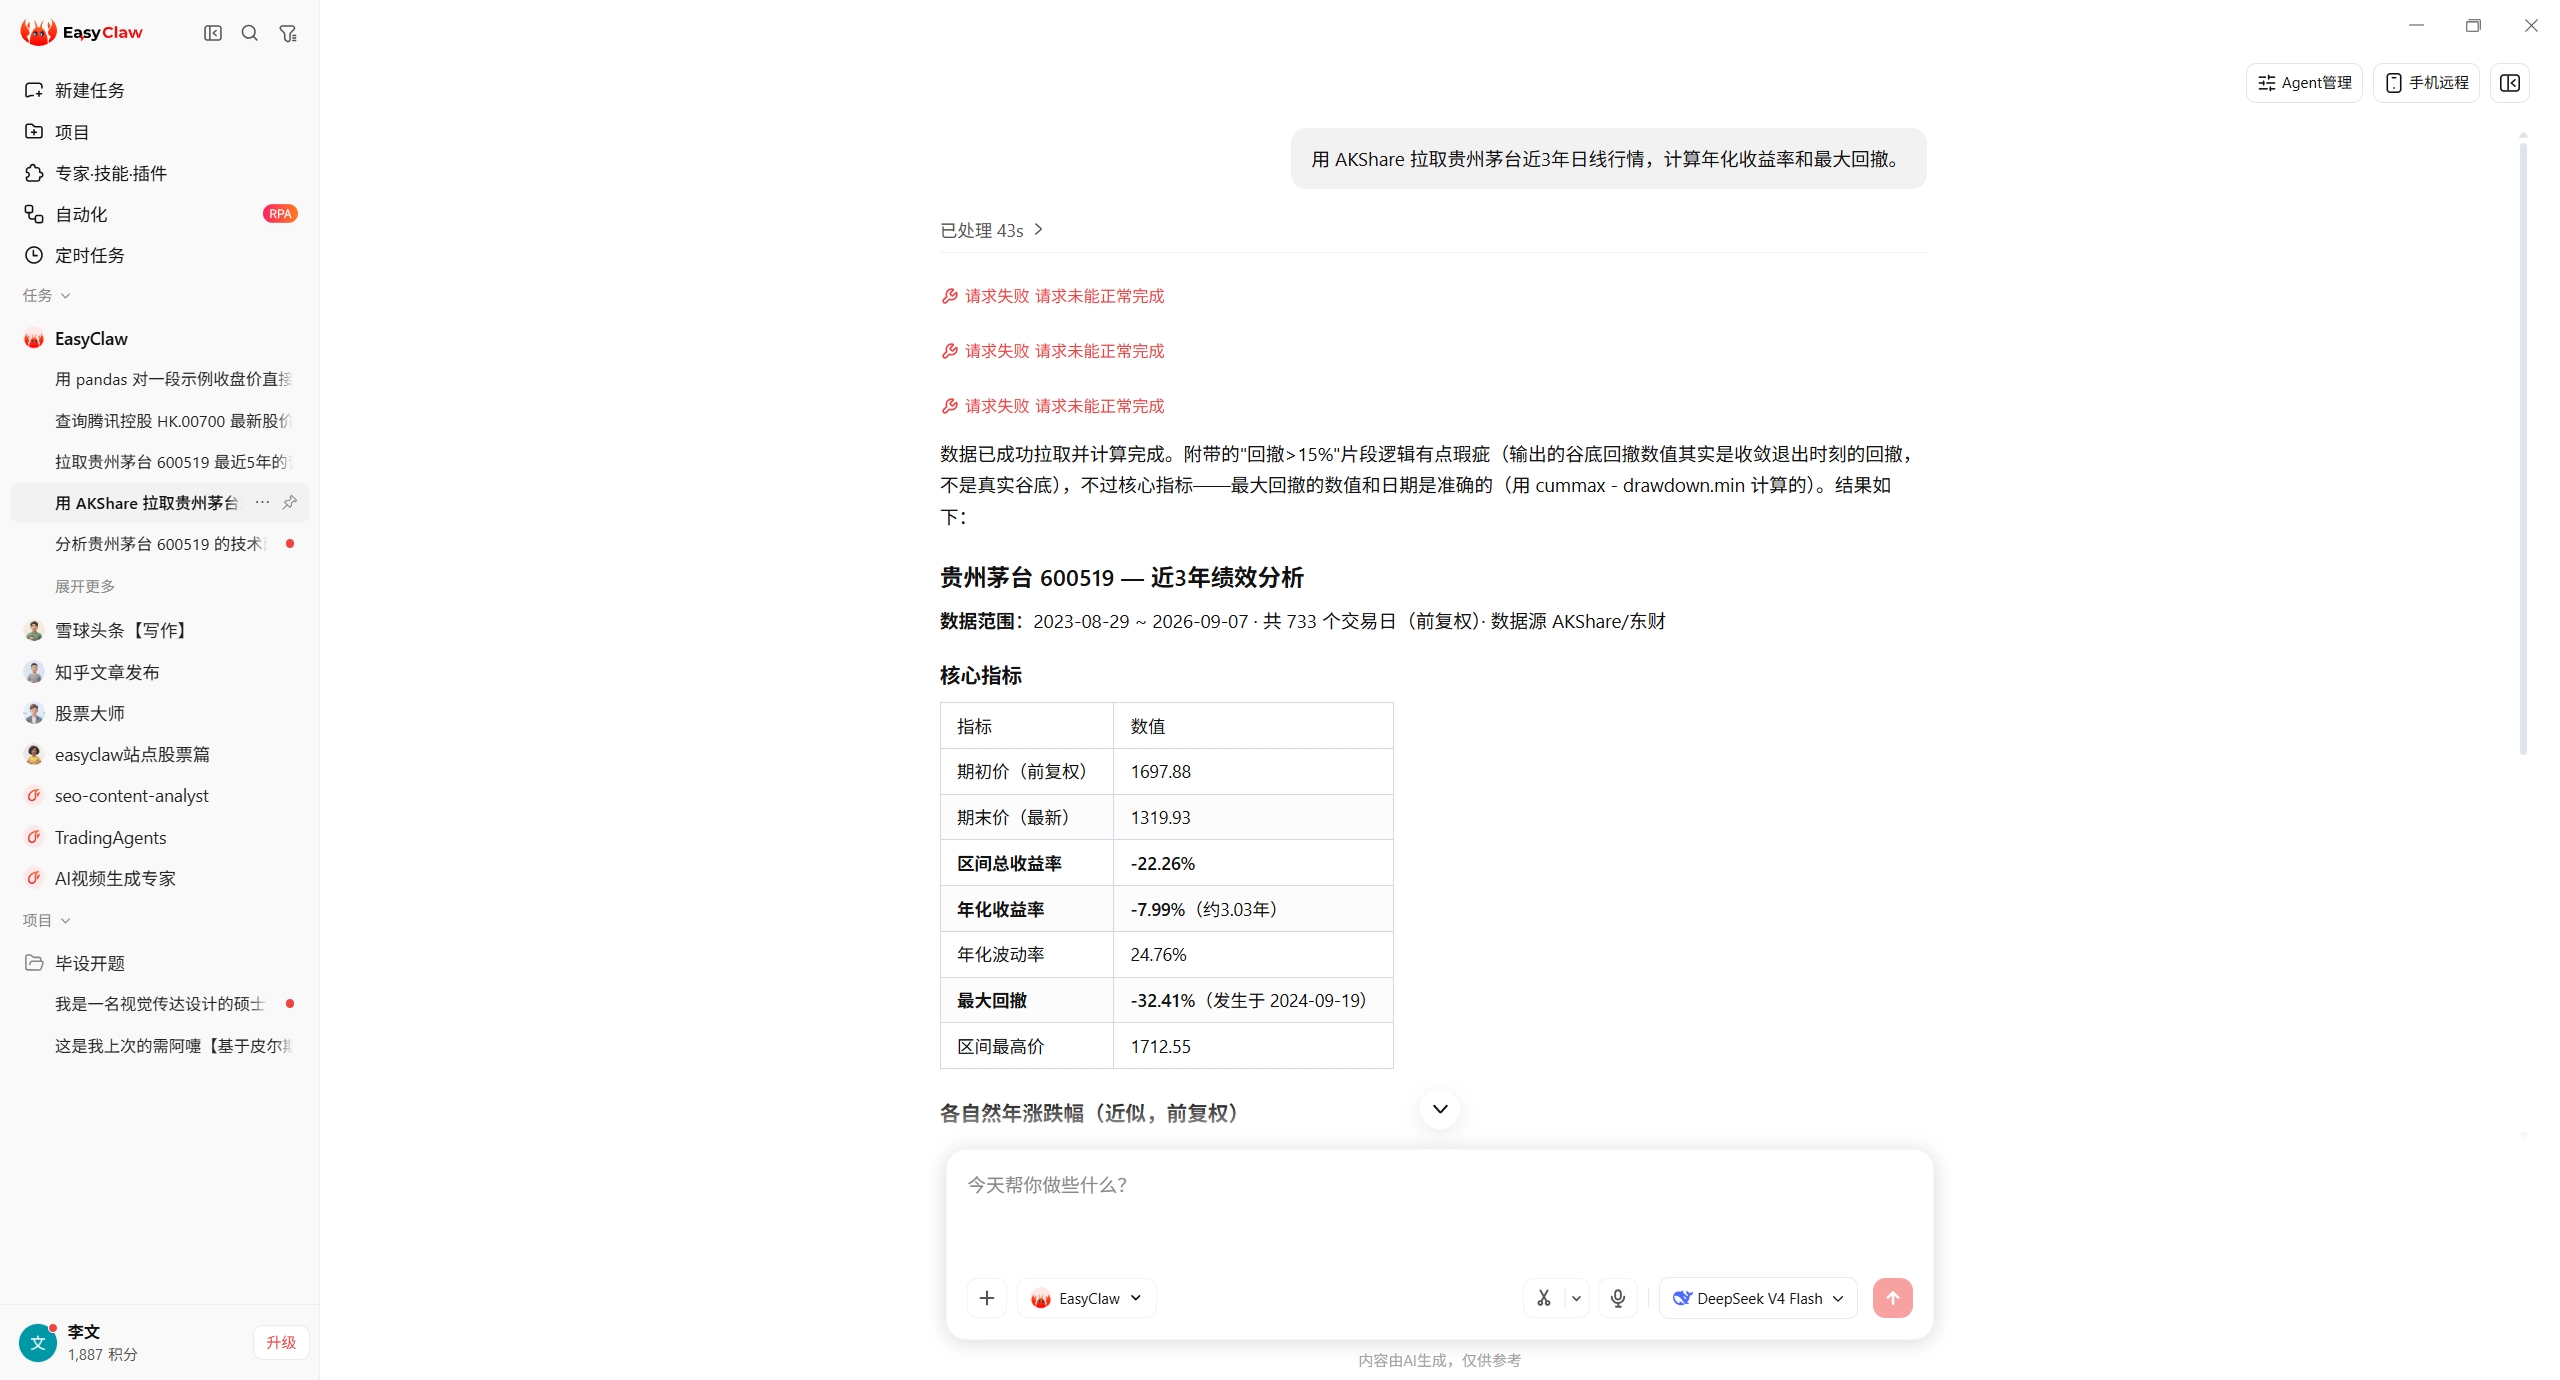
以上截图为该技能路线的实际使用效果,需先安装客户端;图中的数据源与指标口径由所用技能决定,与本框架的回测口径不同,不能直接对比收益结果。结果由 AI 生成,仅供研究,不构成投资建议。
它是 polakowo 开源的 Python 向量化回测与策略研究库,基于 pandas、NumPy、Numba 构建,用向量化数组运算替代事件驱动循环。定位与最新能力以官方 README 与官方文档为准;本页只做中文导航,不替代官方文档。
需要 Python 与 pandas/NumPy 基础——它以访问器形式挂在 DataFrame 上(如 df.vbt),理解向量化广播后上手较快。若完全不熟悉数组运算,复杂策略的信号对齐与状态处理容易出错,这时可以先看对比页列的本机免部署技能路线;vectorbt 官方文档的示例才是更权威的入门材料。
用 vectorbt 做因子研究、批量参数扫描、多标的多参数快速验证,向量化广播更高效;做强路径依赖策略、精细撮合与实盘对接,事件驱动框架更贴合。两者撮合与指标口径并不等价,跨框架比较前要统一口径,具体差异以各自官方文档为准。
许可为 Apache 2.0 with Commons Clause(Fair Code):源码公开、可免费使用,但不得销售主要基于本软件的产品或服务;可选依赖(如 TA-Lib 等)可能受更严格许可约束。商用前请直接阅读仓库 LICENSE 原文并自行评估合规,本页说明不构成法律意见;许可条款以官方仓库 LICENSE 原文为准
vectorbt 内置的数据访问以 YFData(Yahoo 行情)为主;A 股通常用 akshare / tushare 等来源自行取数,整理成标准 DataFrame 后再进入回测流程,接口与复权口径以对应数据源官方文档为准。本机技能中的 akshare-finance、tushare-finance 覆盖 A 股等行情数据,可作为另一条取数路线参考。
无已证实集成。官方 README 与文档没有提到它,本机技能目录中也没有本项目对应的技能;两者是并列的独立路线,各自适合的作业环节见对比页。若只想先得出研究结论、不想维护 Python 环境,可先试本机技能路线。