把翻 K 线找形态变成一次全市场扫描
七个策略共用同一份本地日 K:海龟突破看 20 日新高与成交额,均线放量看 MA5 与 MA20 金叉,高窄旗形看 40 日动量与 10 日收敛,涨停洗盘与上升趋势跌停看反转结构,RPS 突破看 120 日相对强度排序,另有定增公告监控。阈值写死在源码里,改哪个数值对应哪条判定都能对着文件改。
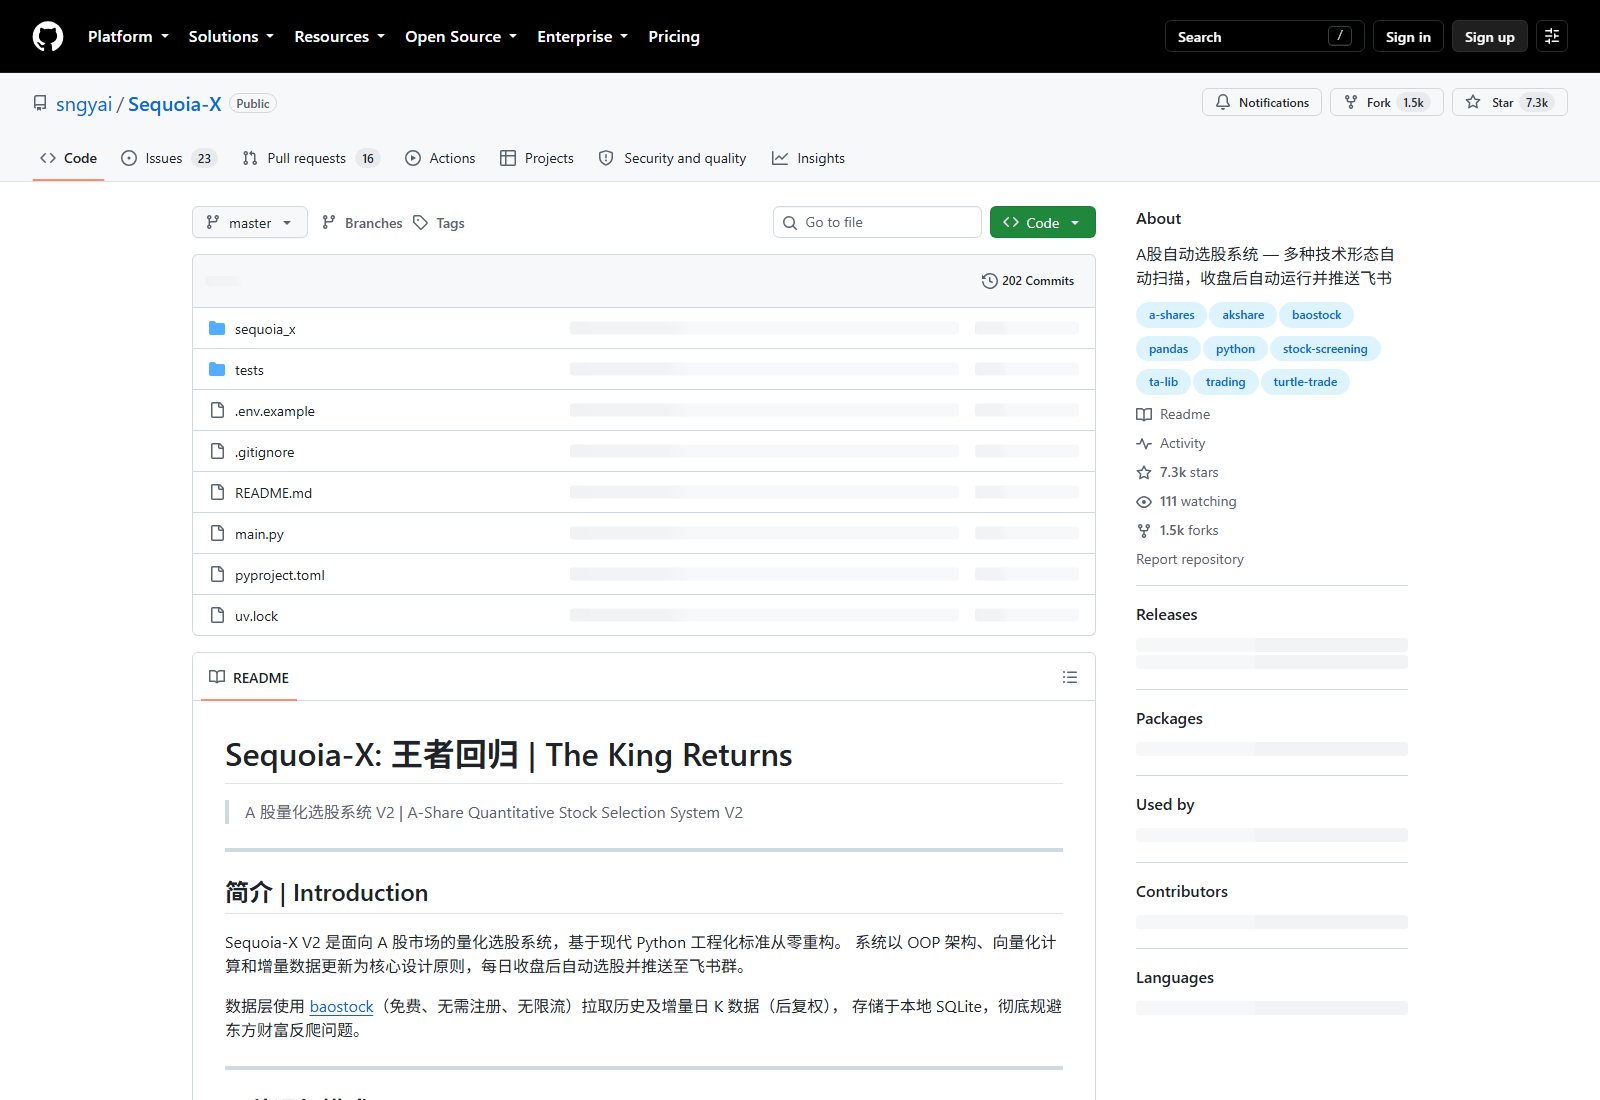
Sequoia-X · sngyai 开源的 A 股自动选股系统
收盘后一只只翻 K 线找形态、翻完还要手动记下来——这件事可以交给程序。Sequoia-X 用免费的 baostock 日 K(后复权)在本地建库,按七个写在源码里的技术形态逐只扫描沪深两市,命中结果按策略推送到对应的飞书群。它是一套可自定义规则、收盘后自动扫描 A 股并推送结果的开源选股系统:不是自动交易系统,不提供买卖点,也没有任何收益保证;本站逐条核对源码条件、标注证据等级,并把复权审计与验证方法一并给你。
截图采集于 2026-09-15(页面显示 7.3k Star);2026-09-23 复查为 7,514 Star、1,529 Fork,数字随社区变化。
 查看源码
大多数人不是需要一整套量化平台,而是卡在下面四件事上。Sequoia-X 只回答了其中三件半,第四件要你自己补。
| 卡点 | Sequoia-X 的回答(附依据) | 去哪一页细看 |
|---|---|---|
| 数据每天都要手动弄,导 Excel、存桌面,还容易漏 | 用免费的 baostock 拉日 K(后复权)写进本地 SQLite 的 stock_daily 表:首次 --backfill 灌历史,之后每个交易日补一次增量,数据库就是一个文件,可拷贝可复盘(依据:data/engine.py,②级) | 数据层 安装与回填 |
| 脑子里有一套选股条件,但不知道怎么写进程序 | 七个内置策略都是「逐条阈值 + pandas 向量化」,阈值就写在策略类属性上(例如 RPS 的 rps_threshold = 90):照着一份抄下来改数字就能跑(依据:strategy/ 七个文件,②级) | 突破信号 新增策略 |
| 跑完怎么知道结果、总不能一直盯着屏幕 | crontab 在工作日收盘后触发 python main.py,每个策略带自己的 webhook_key,命中结果按策略推送到对应的飞书群(依据:README + main.py,①级) | 日常运行 飞书播报 |
| 选出来的票到底靠不靠谱?会不会是过拟合 | Sequoia-X 没有回答这一题:仓库里没有回测引擎、没有费率模型、README 与源码都没有胜率或收益数据。本站把「怎么自己验证」写成可复现的方法:回测模板、未来函数检查、幸存者偏差说明与六个失效场景(④级) | 回测与验证 六类失效场景 |
不是又一个行情客户端,而是把「收盘后找形态」变成一条可定时的流水线。
七个策略共用同一份本地日 K:海龟突破看 20 日新高与成交额,均线放量看 MA5 与 MA20 金叉,高窄旗形看 40 日动量与 10 日收敛,涨停洗盘与上升趋势跌停看反转结构,RPS 突破看 120 日相对强度排序,另有定增公告监控。阈值写死在源码里,改哪个数值对应哪条判定都能对着文件改。
数据层取 baostock 的日 K(后复权),落进本地 SQLite 的 stock_daily 表。日常模式八个进程并行补当日增量,首次用回填模式一次性灌入全市场历史。数据库是一个文件,可以直接拷贝到别的机器继续用——这是它和「在线接口每次现取」最本质的差别。
每个策略有独立的 webhook_key,可用 STRATEGY_WEBHOOK_<KEY> 环境变量把不同策略的结果送进不同的飞书群;没配的策略自动回落默认 Webhook。配合 crontab 在工作日收盘后执行,你只在飞书里看结果。
命令全部来自官方 README 与 main.py 的 argparse 定义。
uv sync(官方推荐)或 pip install .;把 .env.example 复制为 .env,至少填 FEISHU_WEBHOOK_URL——这一项是必填,缺失时配置校验直接抛错、程序不启动。
python main.py --backfill:单线程逐只拉取,README 称约 12 分钟完成 ~5200 只 A 股。中途失败会重试三次并跳过已入库的股票,所以中断后可以再跑一次续传。
python main.py:先读本地已有股票清单,按 tasks[i::n] 切成最多 8 份并行拉取当日数据,写入前会先删掉当日旧记录再追加,避免重复行。
策略在 main.py 的列表里顺序执行,每个策略独立返回股票代码清单;命中为空时记一行日志跳过推送,不会发空消息。
命中的策略把结果组装成飞书交互卡片(日期 / 策略名 / 数量 / 带雪球链接的标的列表)POST 到对应 Webhook;整个过程用 rich 输出带时间戳的日志。
按官方 README、main.py 与 sequoia_x/ 源码整理;每一行都指向本页之外的具体页面。
| 栏目 | 内容 | 来源依据 | 入口 |
|---|---|---|---|
| 安装与回填 | 环境要求、两种依赖安装方式、.env 四个字段、首次回填与断点续跑、装完自检 | README 快速开始、pyproject、.env.example | 安装与回填 |
| 日常运行 | 八进程增量机制、crontab 定时、耗时影响因素、日志怎么读、非 Linux 调度说明 | main.py、data/engine.py、README | 日常运行 |
| 突破信号 | 海龟突破、均线放量、高窄旗形、RPS 突破四套条件的逐条阈值与最小 K 线要求 | 四个策略源码 | 突破信号 |
| 反转信号 | 涨停洗盘、上升趋势跌停、定增公告监控三套条件,以及 README 与代码策略数不一致的说明 | 三个策略源码 vs README 表 | 反转信号 |
| 数据层 | baostock 与后复权口径、stock_daily 表结构、UNIQUE 约束、两条写入路径差异、数据边界 | data/engine.py | 数据层 |
| 飞书播报 | 卡片结构、七个 webhook 标识与路由规则、fallback 逻辑、推送成功判定与失败排查 | notify/feishu.py、core/config.py | 飞书播报 |
| 新增策略 | 策略基类契约、五步接自己的逻辑、向量化写法约定、两条取数路径、测试与代码规范 | strategy/base.py、tests/、pyproject | 新增策略 |
| 排障续传 | 八类常见报错的现象与处理、断点续传机制、日志定位、数据体检、何时该重跑回填 | 源码日志文案与容错分支 | 排障续传 |
| 路线对比 | 自建选股系统与 EasyClaw 本机技能路线在选股方式、数据、调度、前置成本上的逐项对照与决策清单 | 本机技能目录(16 个技能)核验 |
参考页多半只写「支持七个策略、免费数据、自动推送」,不写这些说法是从哪来的。本站把每个结论的来源标成五级,读的时候可以直接判断该不该信。
| 等级 | 含义 | 本项目里的实例 |
|---|---|---|
| ① 官方功能 | README、pyproject、.env.example 里明确写了的 | 七个内置策略、baostock 免费数据、python main.py --backfill 回填、FEISHU_WEBHOOK_URL 为必填 |
| ② 源码已核验 | 在引用的 commit 里逐行读到实现(不只看文档) | 海龟突破用 shift(1).rolling(20).max() 排除当日、涨停洗盘四条条件、RPS 的 min_periods=60、日增量按 tasks[i::n] 分片 |
| ③ 本站实测 | 本站自己跑出来的输出或日志原文 | 本项目没有这一级——本站是静态源码核验,没有在本机安装、回填或跑过一次完整选股,凡是「跑一下就知道」的话都不写 |
| ④ 教程扩展 | 官方没写,本站按源码推导出来的可操作步骤 | 用 SQL 复现当日选股结果、数据体检查询、复权口径审计、回测与样本外验证模板 |
| ⑤ 待核验 | 只有第三方说法,官方与源码都对不上 | README 策略表只列 6 个而代码注册 7 个;README 称 MIT 但仓库根目录没有 LICENSE 文件、GitHub API 的 license 字段为 null |
| 核验项 | 读到的值 |
|---|---|
| 对应版本 | pyproject 声明 2.0.0;仓库没有任何 Release(GitHub releases 接口返回空数组),所以版本号只在 pyproject 里 |
| 对应 commit | 默认分支 master 的 444c0db(2026-05-09)。本站引用的 16 个源文件已按该 commit 逐份重取并 sha256 比对,全部一致 |
| Python 版本 | requires-python >=3.10,README 与 pyproject 口径一致 |
| 操作系统 | 官方 README 未给出支持矩阵;定时运行章节按 crontab 写法给出,非 Linux 需要自行换调度器 |
| 数据源 | baostock 日 K(adjustflag=1 后复权)为主;定增公告策略单独走 akshare 的公开接口 |
| 是否完整运行 | 没有。本站没有在本机安装依赖、没有执行 --backfill、没有跑过日常模式;正确性与性能以你的机器实测为准 |
| 核验日期 | 2026-09-23(仓库元数据同日采集:7,514 Star / 1,529 Fork / 42 个 open issue) |
两条路线的准备成本差别很大,先看你怎么用。
换来的是完全可控的流水线:阈值在源码里、数据在本地库里、推送路由自己配,结果可复现、可二次开发;代价是要维护 Python 环境、准备必填的飞书 Webhook,并承担首次回填的等待。
本机已核验的 mx_select_stock 覆盖自然语言条件选股、stock-technical-mastery 覆盖单只 K 线技术指标、stock-monitor-skill 覆盖已选标的的预警、akshare-finance 覆盖行情取数;但没有任何证据表明 Sequoia-X 已集成 EasyClaw,不能把它当作本项目的另一种安装方式。
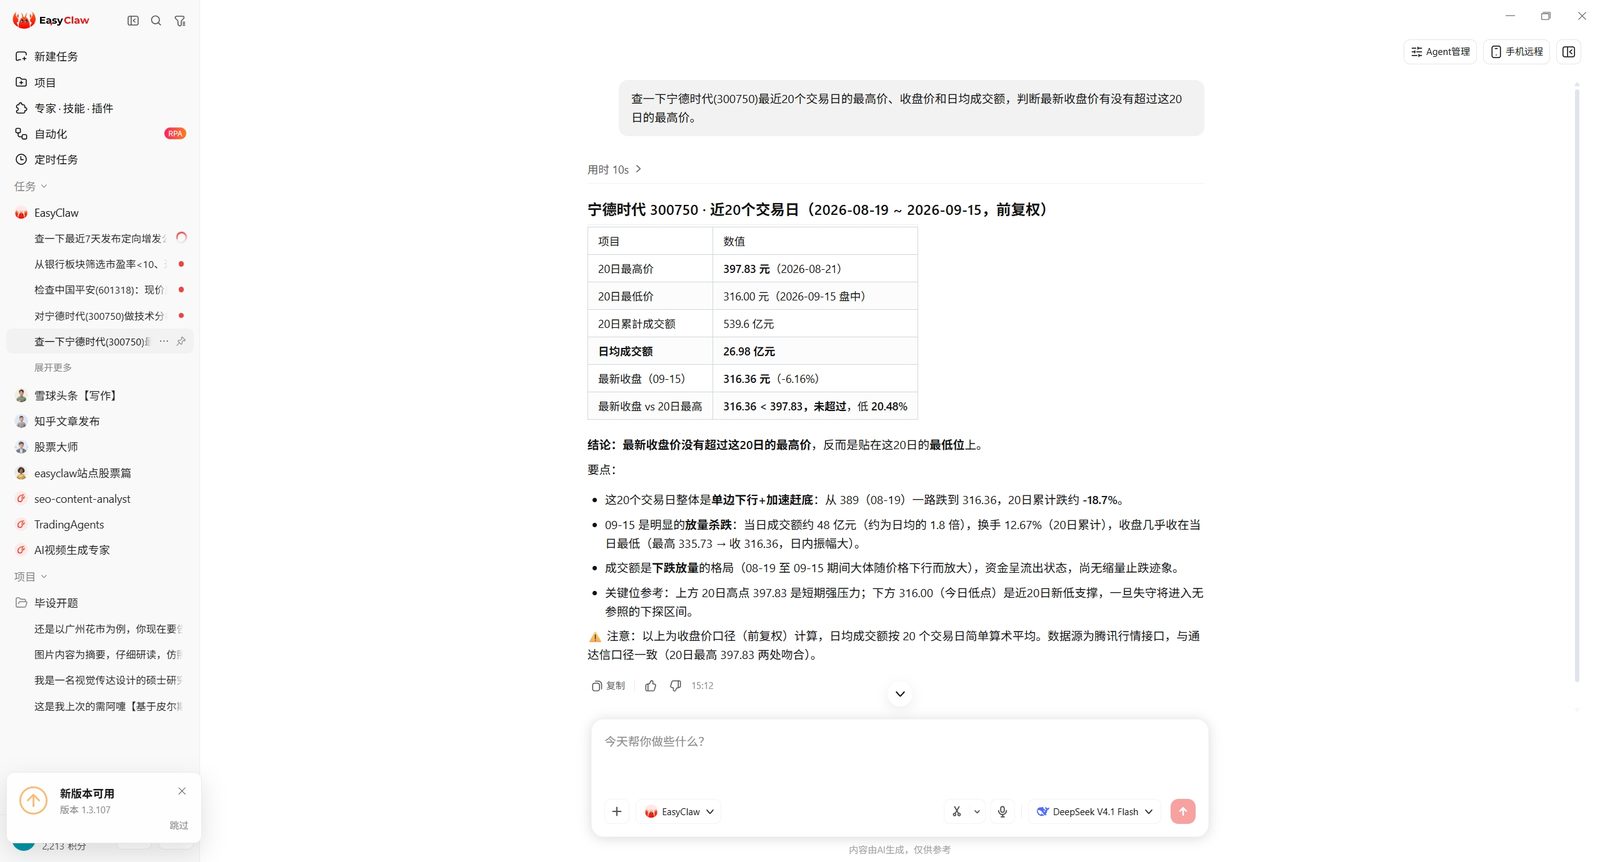
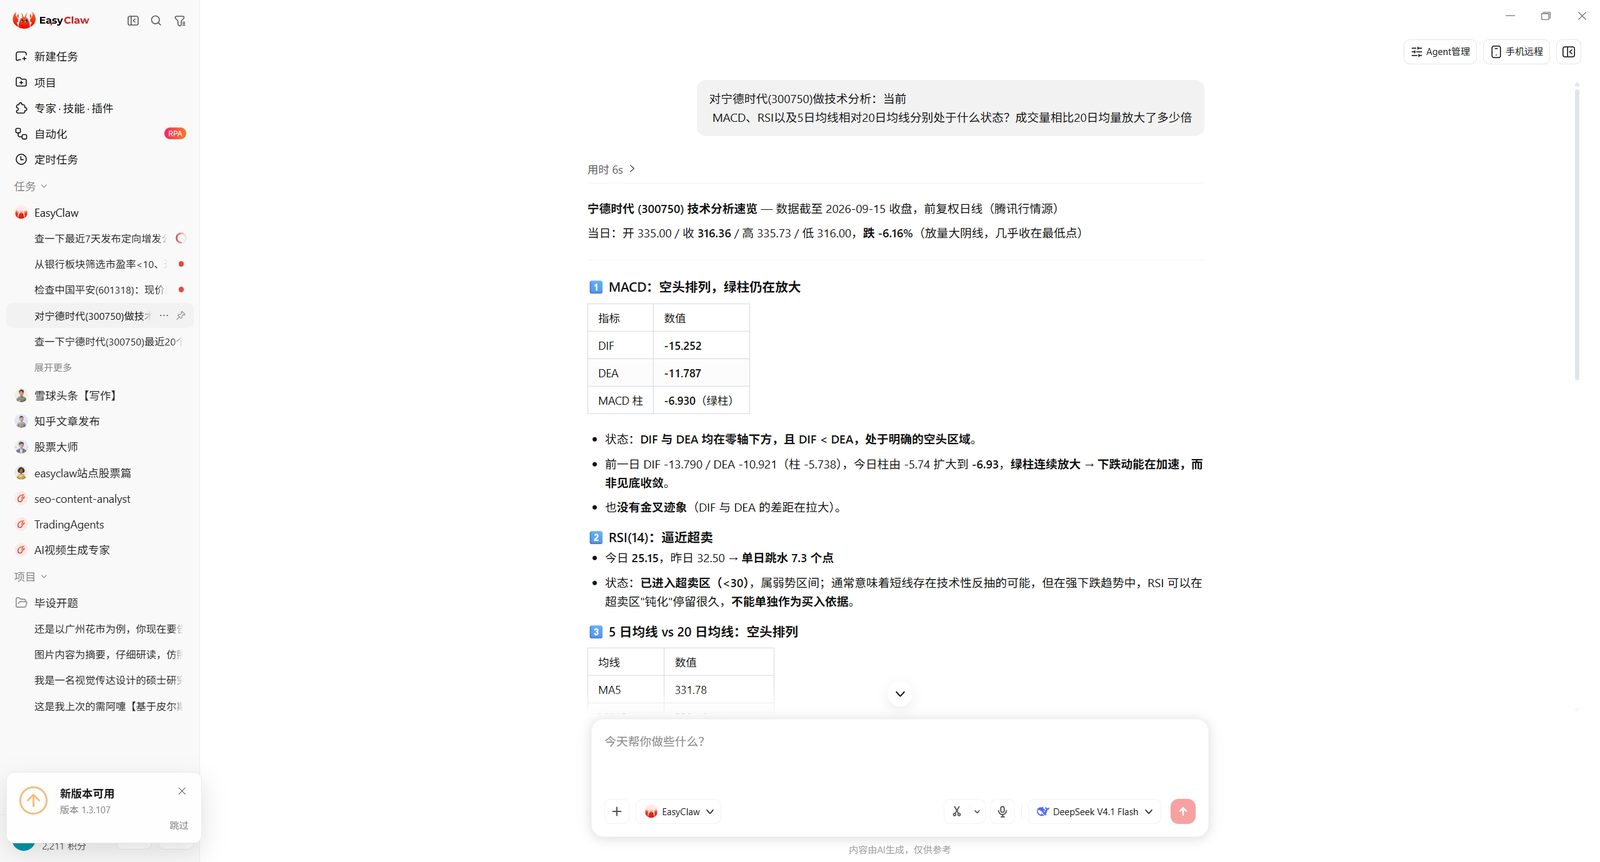
以下为本机技能对话的真实截图(点击左右箭头翻页),用于对照「自建流水线:装环境 + 回填数据 + 等收盘后跑」的准备成本。截图演示的是本机技能路线,不是 Sequoia-X 的运行结果;Sequoia-X 与 EasyClaw 无已证实集成,仅供研究。
它的边界比功能更需要先确认。
你能接受命令行操作、愿意维护一台常开的机器跑定时任务,并且想要「固定阈值 + 全市场扫描 + 本地库可复现」的工作方式。它不追求预测,只负责把符合条件的标的按同一套规则筛出来。
你想要图形界面、想要分钟级或基本面数据、想要回测验证策略收益、或者希望有买卖点提示。本项目不开箱即用:必须装 Python 环境、必须准备飞书 Webhook,首次还要等回填完成。
README 写的是 MIT,但仓库里没有 LICENSE 文件,GitHub 也没有识别到许可证。要以 MIT 复用或用于商业场景前,请先向仓库作者确认,不要直接按 README 的一行声明判断。
项目只负责「今天选出了谁」,不回答「这个规则过去到底有没有用」。验证要你自己做,下面这张表是本站建议的最小回测模板——每一项都要写清楚,缺一项结论就不可比。
| 模板字段 | 为什么必须写清 / 常见坑 |
|---|---|
| 策略名称与规则版本 | 写清是哪套阈值、对应哪次修改。同一个名字下改了阈值,结果就不能和历史对比 |
| 回测区间 | 至少覆盖一段上涨、一段下跌;只测牛市区间得出的胜率没有意义 |
| 股票池与筛选口径 | 本项目股票池来自当前上市清单,退市股不在库里,直接影响结论(见下方幸存者偏差) |
| 数据源与复权方式 | 本项目统一后复权(adjustflag=1)。换成前复权或不复权,同一策略的信号数会变 |
| 信号日定义 | 明确「用当日收盘价算出信号」——所以最早只能次日成交,这是最容易埋进未来函数的地方 |
| 买入价格口径 | 次日开盘价 / 次日均价 / 次日收盘价,三选一并固定;用信号日收盘价买入就是未来函数 |
| 持有周期 | 统一成 1 / 5 / 10 / 20 个交易日分别统计,别只挑表现最亮眼的那个周期 |
| 手续费与印花税 | 项目不含任何费率模型,回测必须自己加:佣金、过户费、卖出印花税逐项扣 |
| 滑点假设 | 形态类信号常在放量或涨停附近出现,按 0 滑点会系统性高估 |
| 基准 | 至少与沪深 300 或中证全指同期对比,否则「正收益」可能只是市场给的 |
| 样本数量 | 样本少于 30 个的结论只能当线索;把每日命中数打出来,看清楚是 3 只还是 300 只 |
| 收益分布 | 只给平均值会被单只极端值带偏,同时给中位数与胜率 |
| 最大单笔亏损与最大回撤 | 形态失效时的尾部风险,比平均收益更决定这套规则能不能用 |
信号在收盘后才成立,所以只有「次日成交」的假设才成立。本项目所有策略都读最后一根 K 线判断,回测时必须把成交价整体后移一天;一旦用信号日收盘价买入,回测结果基本作废。
get_all_symbols() 只保留 status=1(上市)且 stock_type=1(股票)的标的——退市股、指数、基金从一开始就不在库里。用它回测任何「长期持有」类结论都会天然偏乐观。
日增量在入库前会过滤掉 volume = 0 的行,停牌日不会写进库。策略用「最后一根 K 线」取「今日」时,库里最新日期未必等于你想回测的那个交易日,回测前必须先断言日期。
「选出股票」不等于「这套规则有效」。下表每一条的触发机制都能在源码里找到对应写法,检查方法本站也给出了可执行的查询思路。
| 失效场景 | 为什么会发生(源码依据) | 怎么发现 | 怎么规避 |
|---|---|---|---|
| 假突破:盘中新高回落、次日跌回箱体 | 海龟突破只要求当日 close 超过前 20 日最高价,且是实体阳线——只看一天,没有「站稳」确认 | 把当日命中票按次 1 / 3 / 5 日收益分组,看分布是否显著偏正 | 显式加入确认条件(例如次日不破当日低点)后重新验证,而不是直接把结论当成规则有效 |
| 把高位放量出货读成「洗盘」 | 涨停洗盘要求「今日收阴 + 放量 2 倍 + 最低价不破昨收」,在情绪退潮期同样能被满足 | 同时看该票所处位置(区间涨幅、是否连板)与板块状态 | 库内没有换手率与涨跌停价字段,位置过滤要另取数据;先确认能拿到再决定是否把该策略纳入选股 |
| 风格切换:强势股集体补跌 | RPS 用的是当日横截面排名(前 10%),只回答「相对谁强」,不判断价格整体趋势 | 把命中票按市场阶段(指数 20 日涨跌)分组统计后续表现 | 把 RPS 当筛选器而不是买入信号;必要时叠加指数或行业过滤 |
| 数据断档:跑出来的「今日」其实是上周 | 日增量入库前过滤 volume = 0,停牌与非交易日不会新增行 | SELECT MAX(date) FROM stock_daily; 与交易日历比对 | 跑策略前先断言「库内最新日期 = 目标交易日」,不一致就直接中止并补数 |
| 复权口径错配:价格和行情软件对不上 | 库里统一是后复权价(含历史分红送股的复权),与券商 App 的现价天然不同 | 抽一只近期除权的股票,对比库内收盘价与行情软件前复权价 | 库内序列只用于相对计算;把后复权价当成交价、或据此推算委托价都会错 |
| 参数调优造成「历史很好看」 | 阈值都是策略类里的常量,改一个数字就能让历史命中数变少变好 | 把时间段切成样本内 / 样本外,只在样本内调参 | 先定规则再跑样本外;同一组参数只在样本外验证一次,不许反复回看 |
| 推送成功但数据日期不对 | 程序只在「库里已有数据」之上运行,非交易日照常输出旧数据、照常推送 | 核对飞书卡片头部日期与库内 MAX(date) 是否一致 | 把「日期一致性」当成每日第一次检查;不一致时先补数再看结果 |
Sequoia-X 是 sngyai 开源的 A 股自动选股系统,形态是 Python 命令行程序:本地存日 K、按固定阈值扫描全市场、把命中结果推送到飞书。行情软件给你看盘工具,它给你一套可定时的筛选流水线。细节以官方 README 与源码为准。
不需要。数据来自 baostock(README 称其免费、无需注册、无限流),推送用飞书自定义机器人的 Webhook。必须配置的凭据只有一个——FEISHU_WEBHOOK_URL,它同时是配置校验的必填项。除定增公告策略走 akshare 的公开接口外,其余策略都只读本地 SQLite。
源码里注册了七个策略:海龟突破、均线放量、高窄旗形、涨停洗盘、上升趋势跌停、RPS 相对强度突破,以及定增公告监控。README 的策略表只列了前六个——定增公告策略没有出现在表里,这是代码与文档的真实差异,本站把它如实标出,具体以源码为准。
不能。项目里没有回测引擎、没有撮合与费率模型,也不提供任何收益、胜率或回撤数据。它输出的是收盘后的候选清单,是否有效需要通过你自己的研究去验证;本站不发布任何绩效数字。
没有已证实集成。它通过 Python 包管理安装(uv sync 或 pip install .),本机技能目录里也没有对应技能;本机技能侧可用的是自然语言选股、技术指标、盯盘预警、行情取数等独立技能,属于并列的另一条路线,详见对比页。
README 自述日常模式约 2~3 分钟、首次回填约 12 分钟(全市场约 5200 只)。实际耗时取决于机器性能、网络与当日是否为交易日,非交易日会输出「无新数据」并正常结束——这是预期行为,不是故障。
官方 README 是中文的,但内容集中在一页说明里。本站是第三方研究站,不是官方文档:全站逐条标注证据等级(官方功能 / 源码已核验 / 教程扩展 / 待核验),并明确本站没有在本机运行过该项目。任何口径冲突时以官方仓库与源码为准。
不能。源码里没有券商接口、没有下单或风控模块,程序的输出只有飞书卡片里的候选名单。它是一台「筛子」,不负责买卖决策——这一点官方 README 与全部七个策略源码都可验证。
项目本身开源,数据用免费的 baostock,推送用免费飞书自定义机器人,没有强制付费项;成本主要是你的机器(要能常开跑定时任务)与时间。注意许可证据冲突:README 称 MIT,但仓库根目录没有 LICENSE 文件、GitHub 也未识别到许可证,商用前请先向作者确认,以官方仓库为准。
全部来自官方仓库:README、pyproject、.env.example 与 16 个源文件(commit 444c0db,2026-05-09),本站已按该 commit 逐份重取并做 sha256 比对,全部一致;仓库数据同日从 GitHub API 采集。凡是官方与源码都没有的数字(收益、胜率、回撤、耗时实测值)本站一律不写。
它是按固定阈值筛形态,输出的是候选名单而不是投资结论。形态有效性会随市场环境变化,假突破、风格切换、参数过拟合都会让历史表现失效;所以本站专门给出回测模板与六类失效场景。所有结果仅供研究与学习,不构成投资建议,任何策略都应经过独立回测和样本外验证。