绩效指标:把「感觉不错」变成可比的数字
用 stats 模块算 Sharpe、索提诺、最大回撤、波动率、VaR/CVaR 等约 60 个指标,把一段收益序列的风险收益特征量化下来。好处是横向可比:不同策略、不同参数、不同时间段可以用同一套口径放在一起比,而不是各说各话。
QuantStats · Portfolio analytics for quants
QuantStats 是一个开源的 Python 组合绩效分析库,帮你计算夏普比率、最大回撤、波动率等 60+ 绩效与风险指标,绘制绩效图,并一键生成 HTML/TeX 报告。它分析「收益率序列」,适合量化策略、组合管理与策略复盘。
约 7.6k Star · Apache-2.0 许可 · 采集于 2026-09-10;数字会随社区活动变化,许可证以仓库 LICENSE 为准。
 查看源码
它按「stats 算指标 → plots 画图 → reports 出报告」组织能力,前两者可单独调用,reports 则把两者组装成一份可交付的 tearsheet。下表依据官方 README(2026-09 核验),方法数量与命名以官方实现为准。
| 模块 | 规模 | 能回答什么问题 | 典型方法 | 注意点 |
|---|---|---|---|---|
| stats 子模块 | 约 60 个指标方法 | 这段收益序列的风险收益特征如何?回撤有多深?尾部风险多大? | sharpe / sortino / max_drawdown / volatility / var / cvar / win_rate / profit_factor | 输入是收益率序列而非逐笔成交;无风险利率等口径以官方实现为准 |
| plots 子模块 | 约 17 个绘图方法 | 绩效长什么样?回撤发生在哪几段?月度胜率分布是否集中? | snapshot / drawdown / monthly_heatmap / rolling_beta / rolling_sharpe | 基于 matplotlib/seaborn;交互图需另装可选的 plotly |
| reports 子模块 | 7 种 tearsheet | 能不能一键交付一份完整的绩效报告?能不能给别人看? | metrics / plots / basic / full / html | metrics 与 plots 还分 basic / full 两种模式;自定义模板官方标注仍在完善 |
| 基准对比 | 贯穿 stats / plots / reports | 策略是真有超额,还是只是跟着大盘涨?风格暴露有没有变化? | benchmark 参数 / information_ratio / rolling_beta | 基准要与策略市场和风格匹配,且两边收益口径必须同频 |
| 蒙特卡洛模拟 | stats 下的模拟系列 | 给定收益分布,未来亏到某个阈值的概率有多大?达到目标收益的概率有多大? | montecarlo / bust_probability / goal_probability | 结果取决于历史收益分布假设与模拟次数,属于概率参考而非预测 |
| quantstats.utils | 取数与扩展工具 | 没有自己的收益序列怎么办?能不能直接写成 pandas 风格调用? | download_returns / extend_pandas | download_returns 走 yfinance,境外数据源在网络受限环境下可能拉不到,需自备序列 |
它把「收益率序列 → 指标计算 → 可视化 → 报告」整理成一条可复现的绩效分析流水线:同一份收益序列进去,指标、图表与报告的口径保持一致,避免手工用 Excel 算指标时出现的口径漂移。适合策略复盘、组合评估与对外汇报三个典型场景。如果你现在的痛点是「指标算得出来、每次口径却不一样」,或是「报告每次都要手工拼图」,这两件事正是它要解决的问题。
用 stats 模块算 Sharpe、索提诺、最大回撤、波动率、VaR/CVaR 等约 60 个指标,把一段收益序列的风险收益特征量化下来。好处是横向可比:不同策略、不同参数、不同时间段可以用同一套口径放在一起比,而不是各说各话。
用 plots 模块画净值曲线、回撤区间、月度热力图、滚动 Sharpe/滚动 beta 等约 17 种图。指标只能给出一个数,图形能回答「亏损集中在哪一段」「收益是不是靠少数几个月撑起来的」这类结构问题,是复盘时最直接的证据。
用 reports 模块一键生成 HTML/TeX tearsheet,把指标表、净值图、回撤图、月度收益等内容组装成一份自包含文档,适合存档、发邮件或放进研究笔记。相比手工拼图,重复出报告的边际成本几乎为零。
下面四步是概念层面的工作流,具体命令与预期输出见下方「从装到出第一张报告」的分步实操;完整参数说明见安装页、指标页与报告页。
装好 Python≥3.10,再用 pip 或 conda 安装该库,连带 pandas/numpy/scipy/matplotlib/seaborn 等依赖。这一步的常见卡点是 Python 版本过低或虚拟环境未激活,排查方法见安装页。
QuantStats 的入口是「一条收益率序列」:可以用 qs.utils.download_returns('META') 直接下载,也可以传入自己的 pandas Series。关键要求是频率一致——策略与基准必须同为日频、周频或月频,否则相对指标没有意义。
调用 qs.stats.sharpe()、qs.stats.max_drawdown() 等取数值,或 qs.plots.snapshot()、qs.plots.drawdown() 出图。这一步可以按需挑选指标,不必每次都跑全部约 60 个方法,适合做针对性的问题排查。
用 qs.reports.html(stock, 'SPY') 一次生成带基准对比的 HTML 报告,或选 metrics/plots/basic/full 里的其他 tearsheet 形式。报告是自包含文档,生成后即可离线查看与转发,便于留档与横向比较。
两条路线解决的是不同目标、不同准备成本的问题:一条要自己维护 Python 环境与代码,另一条装好客户端就能用一句话发起任务。逐项对照表在导航「对比」页,这里只讲判断要点。
灵活度最高:能接自己的数据源、嵌进现有回测框架、把报告接进自动化流水线。代价是 Python 环境、依赖版本与代码都要自己维护,出问题需要自己看报错。
上手成本低,不用自己装 Python 依赖;但每个 Skill 的数据源、Token 要求与市场覆盖各不相同,能力边界要先看清。不代表 QuantStats 已集成这些 Skill。
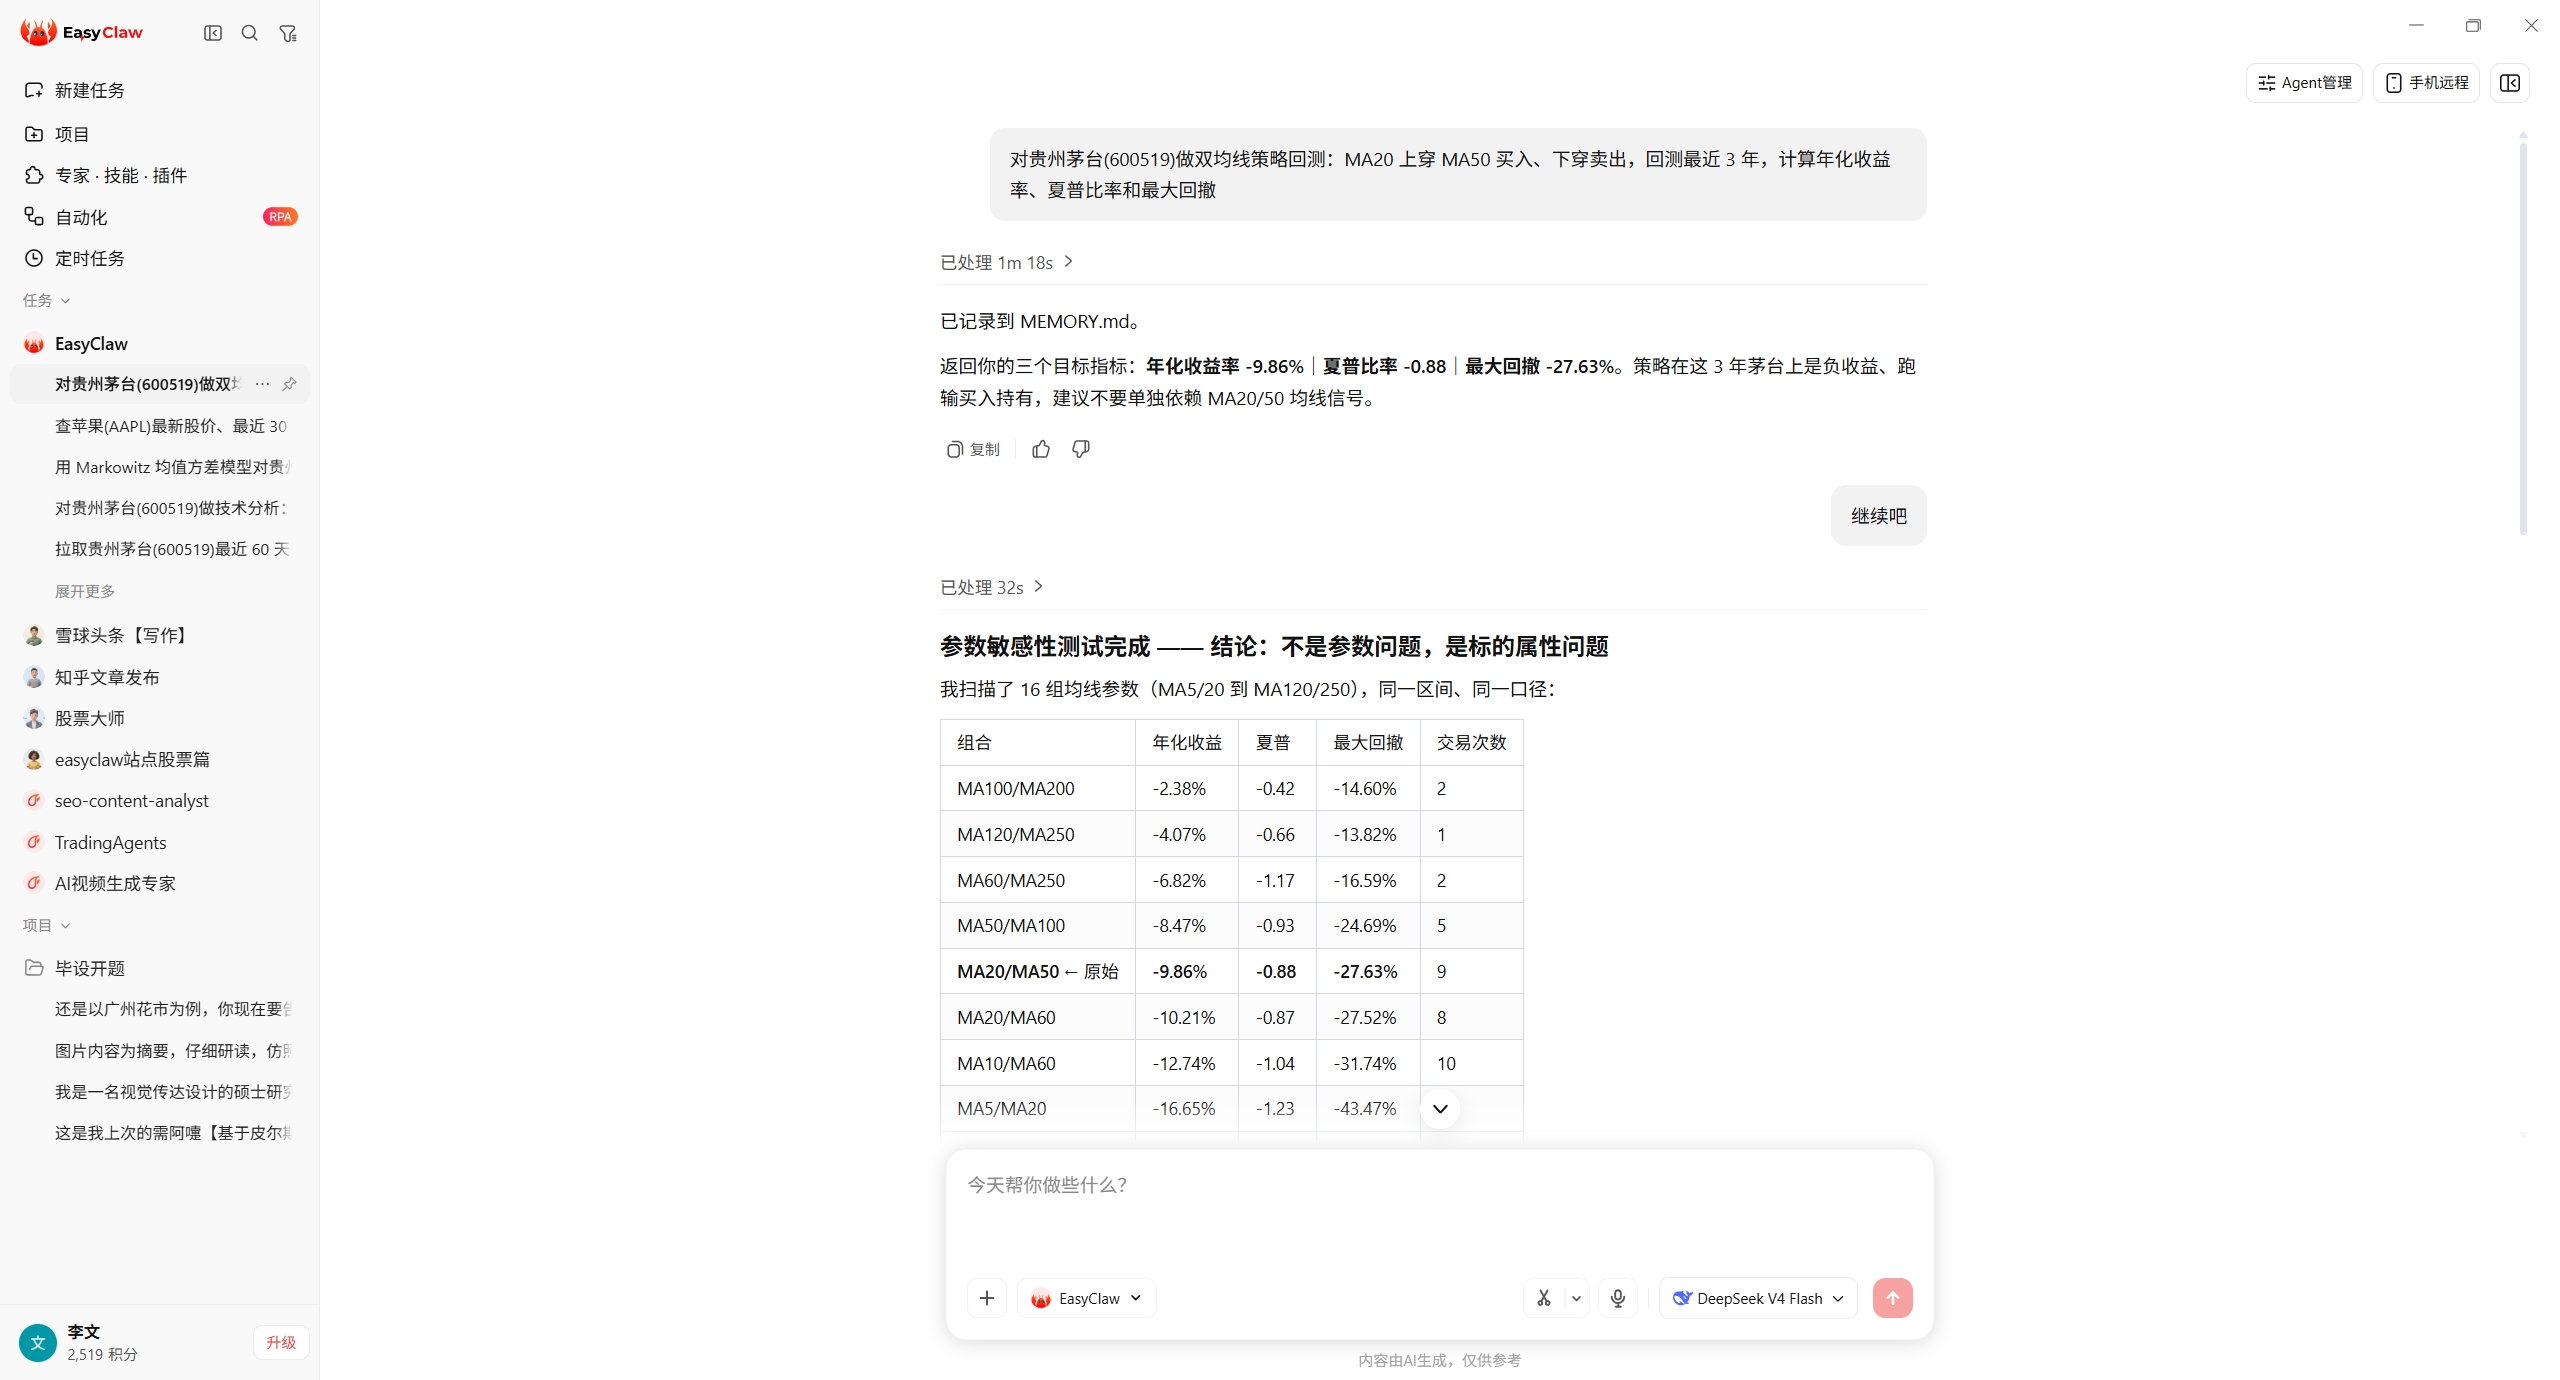
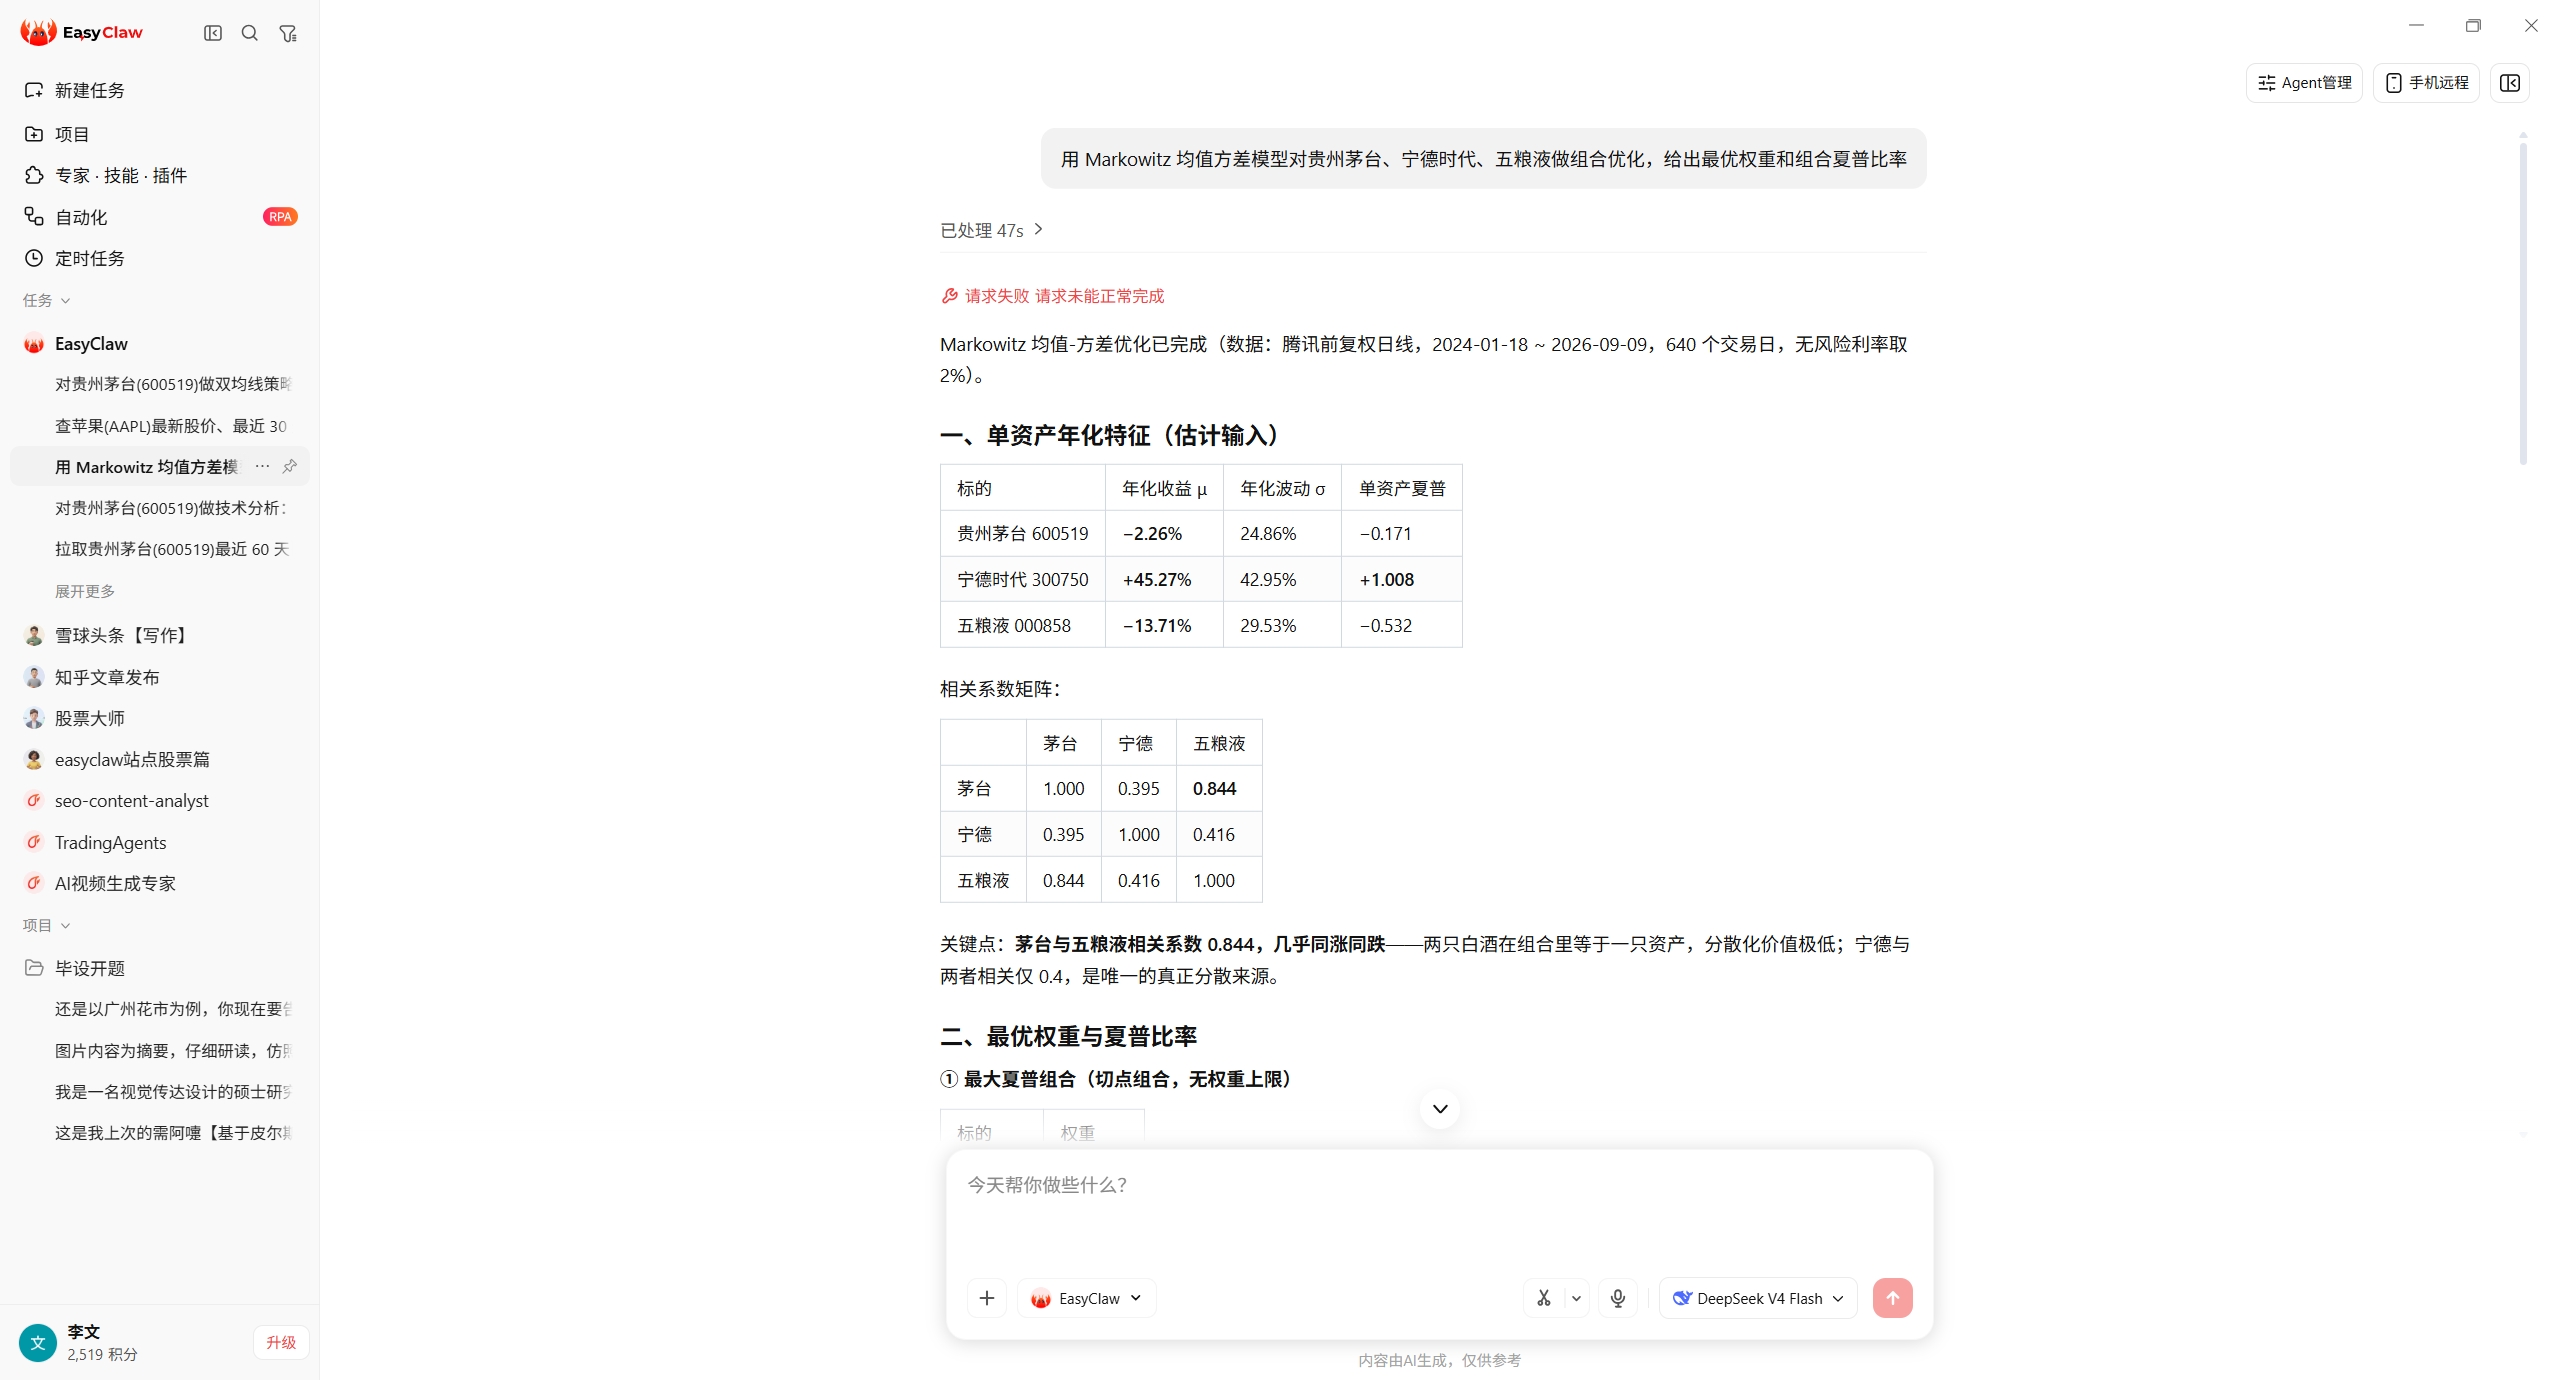
以下为本机量化研究 Skill 的实际对话截图(左右点击翻页),演示「一句话发起策略回测 / 组合优化」的免部署研究路线。QuantStats 与本机 Skill 无已证实集成,截图仅供研究,不代表 QuantStats 的运行结果。截图演示的是本机技能路线的交互方式,与本站介绍的库没有代码级联系;若要复现类似流程,需自行核对各 Skill 的数据源、Token 与前置条件。
多数误用都来自把它当成了回测框架。它处理的是「已经产生的收益序列」,不负责「这条序列是怎么算出来的」。下表是依据官方 README 整理的边界清单,用来判断它能不能解决你手头的问题。读表时建议直接从「不是什么」那一列看起——先确认需求不在排除项里,再看它能做到什么。
| 维度 | 是什么 | 不是什么 | 判断要点 |
|---|---|---|---|
| 定位 | Python 组合绩效分析与报告库(Portfolio analytics for quants) | 不是完整的量化交易平台 | 它只覆盖「分析 → 可视化 → 报告」这一段,前后两端要自己接 |
| 输入数据 | 一条收益率序列(日/周/月),可为 pandas Series 或由 ticker 下载 | 不是逐笔成交与订单流分析器 | Win Rate 指正收益期占比、Profit Factor 指正收益和÷负收益和,不是按笔统计 |
| 策略生成 | 不参与:策略逻辑由你自己或其它框架实现 | 不是回测引擎:不含信号生成、撮合、滑点与手续费建模 | 想要「跑回测」请先用专门回测框架,再把收益序列交给它分析 |
| 交易执行 | 不参与:不连接经纪商、不下单 | 不是实盘交易系统,也不含风控执行 | 没有订单管理、持仓管理与风险拦截能力 |
| 实时行情 | 基于历史收益序列做统计与画图 | 不是实时行情或盘中监控工具 | 需要实时数据要另配数据源;绩效评估本身是「事后」工作 |
| 市场覆盖 | 与市场无关:只要能算出收益序列,股票/基金/加密货币等都能分析 | 不内置各市场的行情数据通道 | 默认取数走 yfinance,国内网络环境下可能拉不到,需自备序列 |
| 输出形态 | 数值指标、matplotlib 图表、HTML/TeX tearsheet | 不是交互式 Web 看板或 BI 产品 | 输出是静态文档,需要自己转发或托管 |
| 许可与费用 | Apache-2.0 开源,可免费使用与商用 | 没有官方托管版,也不提供付费数据服务 | 第三方数据源的费用与授权需要另行确认 |
下面是最小可复现路径,每步给出命令与预期结果,任选一个空目录执行即可。想看更细的环境排查与依赖说明,见安装页。
1. 安装:pip install quantstats --upgrade --no-cache-dir —— 预期结尾出现 Successfully installed 并连带装好 pandas / numpy / scipy 等依赖。若之后仍报「No module named quantstats」,多半是装到了另一个 Python 环境,先确认 pip 与 python 指向同一个解释器。
2. 确认版本:python -c "import sys, pandas; import quantstats as qs; print(sys.version.split()[0], pandas.__version__)" —— 预期先打印 Python 版本(需 ≥3.10),再打印 pandas 版本。ImportError 时优先检查 pandas 是否低于 1.5.0;库的版本号属性以官方实现为准。
3. 取一条收益序列:stock = qs.utils.download_returns('META') —— 预期返回一条日频收益率序列。若这一步长时间无响应或报下载失败,通常是本机网络访问不到 Yahoo 数据源,改用自备数据即可绕过,不必在这里反复重试。
4. 先算一个指标验证链路:qs.stats.sharpe(stock) —— 预期返回一个浮点数。拿到数字说明「取数 → 指标」链路已通,可以放心继续画图与出报告。
5. 生成 HTML 报告:qs.reports.html(stock, 'SPY', output='qs-report.html') —— 预期在当前目录生成自包含 HTML 文件,浏览器打开可见指标表与净值、回撤等图表;若只要指标摘要,改用 qs.reports.metrics(stock, mode='basic')。
判断标准不是「会不会 Python」这一条,而是两件事:你手上有没有一条能跑起来的收益序列?你要的是可复现的数字与文档,还是要能执行的交易?
| 使用者 / 场景 | 是否适合 | 为什么 | 建议路径 |
|---|---|---|---|
| 已有回测结果、缺统一绩效口径的量化研究者 | 适合 | 收益序列已经有了,缺的正是标准指标与可复现的输出 | 装好后把序列交给 stats 模块 |
| 要给多只策略做横向对比的团队 | 适合 | 同一套函数保证不同策略的指标口径完全一致,避免手工计算的口径漂移 | 批量循环调用 stats 并按统一格式落表 |
| 需要定期出绩效报告存档或汇报的人 | 适合 | 报告可由脚本重复生成,格式统一,重复出报告的边际成本极低 | 用 reports.html 指定输出路径,纳入定时任务 |
| 需要跟指数或基准比相对绩效的人 | 适合 | 内置基准参数与信息比率、滚动 beta 等相对指标,不必另写代码 | 见基准对比页的基准选择与口径说明 |
| 关注破产概率、目标达成概率的风险评估 | 适合 | 内置蒙特卡洛模拟系列,可直接得到概率化结论 | 见蒙特卡洛页的参数与解读 |
| 只有策略想法、还没有任何回测结果的人 | 不适合先装它 | 它不做回测;没有收益序列就没有可分析的对象 | 先用回测框架跑出收益序列,再回到本项目 |
| 想自动下单、做实盘执行的人 | 不适合 | 没有经纪商接口、没有订单与持仓管理、没有实时行情 | 选带交易执行能力的框架 |
| 完全不想碰命令行与代码的人 | 不适合 | 它是 Python 库,通过代码调用,没有图形界面 | 可考虑免部署的量化研究路线(见上「路线」小节) |
| 要复现同行或论文里的绩效指标口径 | 适合 | 常用指标都有现成实现,比手工实现更容易对齐口径 | 仍需确认无风险利率取值与年化方式双方是否一致 |
结论先说:库本体是 Apache-2.0 开源项目,免费使用、可商用;真正需要你准备的是 Python 运行环境和数据来源。下面两张表把「要不要花钱」和「要装什么」分开列清。
| 项目 | 结论 | 说明 | 注意点 |
|---|---|---|---|
| 库本体 | 免费 | Apache-2.0 许可,可自由使用、修改与分发 | 具体条款以仓库中的 LICENSE 文件为准 |
| 商业使用 | 可以 | Apache-2.0 允许商业使用与再分发 | 再分发时需保留版权与许可声明 |
| 官方支持 | 社区支持 | 以 GitHub issue 与 README 为主,无商业服务承诺 | 用于生产环境前建议自行评估维护风险 |
| 数据来源 | 取决于你的数据渠道 | 自带取数走 yfinance(免费),也可完全自备 CSV/DataFrame | 自备数据的费用与授权由数据源决定,与本库无关 |
| 运行成本 | 本地计算,无服务费 | 纯本地 Python 计算,不依赖云服务 | 批量生成大量报告时会占用本机 CPU 与内存 |
| 可选依赖 | 按需安装 | plotly 仅用于交互式图表 | 不装 plotly 不影响指标统计与 HTML 报告主流程 |
| 环境项 | 要求 | 是否必需 | 注意点 |
|---|---|---|---|
| Python | ≥3.10 | 必需 | 低于该版本可能装不上或运行异常,官方 README 明确要求 3.10 起 |
| pandas | ≥1.5.0 | 必需 | 收益序列以 Series 形式传入,版本过低容易出现行为差异 |
| numpy | ≥1.24.0 | 必需 | 数值计算底层依赖,一般随 pandas 一并安装 |
| scipy | ≥1.11.0 | 必需 | 部分统计指标依赖;极少数环境编译失败需换预编译轮子 |
| matplotlib | ≥3.7.0 | 必需 | 图表与报告里的图片由它渲染,中文字体需另行设置 |
| seaborn | ≥0.13.0 | 必需 | 影响绘图样式与部分图表类型 |
| tabulate | ≥0.9.0 | 必需 | 报告中指标表格的渲染依赖 |
| yfinance | ≥0.2.40 | 随库安装 | 只有用 download_returns 取数时才用到;国内网络下可能不通 |
| plotly | ≥5.0.0 | 可选 | 仅 plots.to_plotly() 交互图需要,体积较大可选装 |
下面几条不是安装步骤,而是关于「它需要什么输入、输出是什么形态」的认知前提。提前接受这几条,可以省掉大量「装好了才发现用不上」的时间。
它的分析对象是收益率序列。如果你手上只有收盘价,先做一次 pct_change() 转成收益率再传进来;直接传价格会让回撤、波动率这类指标失去意义,而且不会报错,属于最难发现的错误。
策略与基准要同为日频、周频或月频。混频会让信息比率、滚动 beta 等相对指标失真——这是新手最容易忽略、也最难从报错信息里发现的一类问题,只能靠事前约定口径避免。
所有指标都在描述已经发生的收益序列,不预测未来。样本区间越长,结果通常越稳定;短区间里的高夏普可能只是运气,要结合回撤深度与收益分布一起看才有意义。
它不会替你建模手续费与滑点。要在生成收益序列的阶段就把成本扣掉,否则得到的绩效会系统性偏乐观,报表与实盘之间出现难以解释的落差。
生成的 HTML 报告是一份自包含文件,适合存档与转发;它不是在线看板,没有多用户权限与实时刷新,需要分享时得自己发送或托管。
库只提供分析能力,自带取数能力有限:download_returns 走 yfinance,网络受限环境下可能拉不到行情。长期使用建议准备自己的数据来源,把它当成纯分析工具来用。
依赖库与自身版本都会更新,同一段代码在不同版本下可能给出细节不同的结果。自己的研究流程里应记下当时的版本号与数据区间,否则几个月后很难解释两份报告的差异从何而来。
下面几条是选型讨论里高频出现的判断偏差,逐条给出实际情况与判断要点,可以用来对照自己的预期。
| 常见误解 | 实际情况 | 判断要点 |
|---|---|---|
| 它就是回测框架 | 它不做回测,只分析已有的收益序列 | 需要回测请另配框架;它的输入正是回测的输出 |
| 装上就能自动出策略 | 它不生成信号、不选股、不给交易建议 | 策略从哪来是另一个问题,与本库无关 |
| 指标好看就说明策神好 | 指标受样本区间与口径影响,且不包含交易成本 | 要结合回撤、收益分布与成本扣减后再下结论 |
| Win Rate 是盈利笔数占比 | 它是正收益期(日/周/月)占比 | 需要按笔统计就要用逐笔分析工具,口径不能混用 |
| 报告能直接当合规披露材料 | 报告是研究工具的输出,不含合规模板与免责流程 | 对外使用前需自行补充合规内容与风险提示 |
| 可以拿它做实时监控 | 它基于历史收益序列做统计,没有实时行情通道 | 实时场景需另配数据源与监控系统 |
| 它会自动帮你选数据源 | 取数只提供了有限的便捷入口,数据质量与授权由数据源决定 | 数据是否足够长、是否复权、是否含退市股,都要自己把关 |
| 它有图形界面,可以点着用 | 它是一个 Python 库,没有 GUI,需要通过代码调用 | 不写代码的团队应考虑免部署路线,而不是硬拉开发人力 |
QuantStats 是开源的 Python 组合绩效分析库,提供 stats(指标)、plots(可视化)、reports(报告)三大模块,把收益序列变成可比的指标、图表与可交付文档,具体以官方 README 为准。
库本体是 Apache-2.0 开源许可,可免费使用,也可用于商业场景与再分发;再分发时需保留版权与许可声明。需要另外考虑成本的是数据来源——自带取数走 yfinance,改用商业数据源则费用由数据源决定。具体条款以仓库 LICENSE 文件为准。
需要。它通过 Python API 调用,面向有 Python 与量化经验的用户,没有图形界面。如果完全不写代码,就只能走免部署路线,或用其它工具的导出功能间接使用指标口径。
无已证实集成。本项目没有找到官方集成证据;本机内置的是量化研究类 Skill(量化分析、财经数据等),与本库是两条独立路线,各自的数据源与输出形式都不同,以各自官方资料为准。
收益率序列。它按「周期」(日/周/月收益)计算指标,Win Rate 是正收益期占比、Profit Factor 是正收益和÷负收益和,属于 Period-Based 口径而非逐笔成交口径;具体以官方 README 的 Period-Based vs Trade-Based 说明为准。
库本身不做市场数据通道,它只要求一条收益率序列。自带的 download_returns 走 yfinance,能否取到 A 股取决于该数据源支持的代码格式与你的网络环境;更稳的做法是自备 A 股收益序列(CSV 或 pandas DataFrame)再传进来,取数方式以你自己的数据源文档为准。
官方没有中文文档,README 与文档站以英文为主,部分文档内容官方仍标注在完善中。中文资料多来自社区教程,遇到口径分歧时应回到官方 README 与源码确认。
绩效指标只代表历史收益序列的统计特征,不构成收益保证或投资建议。实盘还要考虑交易成本、滑点、流动性与样本区间选择带来的差异;指标口径本身以官方实现为准。