适合:量化研究者与策略开发者
需要把指标接到自己的回测里,必须知道每个列的默认参数、NaN 起点与是否含未来数据。本站的「未来函数审计」页给出了可执行的判定脚本,这是直接从 README 起步拿不到的。
pandas-ta · 中文可验证实战手册
原仓库已 404、官方文档站本机不可达、PyPI 上的原包只到 beta 且要求 Python 3.12 以上——而中文教程仍停在「pip install pandas-ta」。本站把 2026-10-10 的核验结果、四条可运行的调用路径与回测前的审计方法一次讲清,每一步都附本机实测输出。
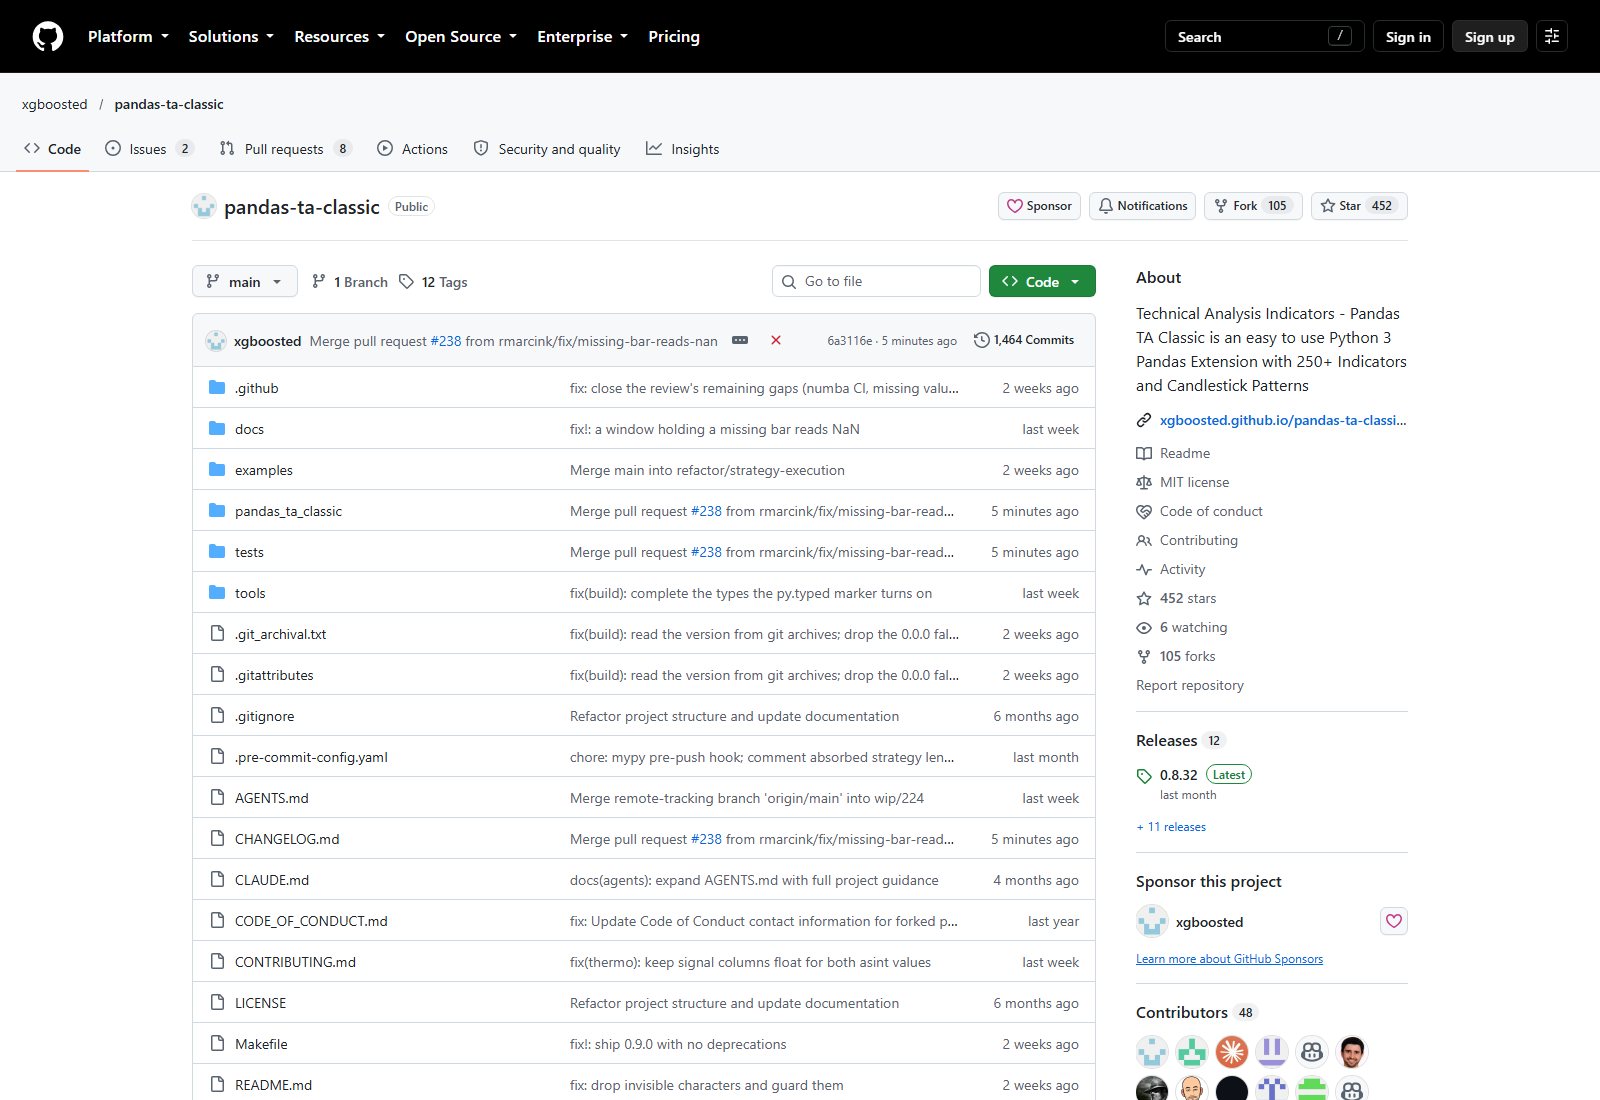
当前仍在维护的对应仓库(452 Star · MIT · 最后推送 2026-10-02 · 最新 release 0.8.32);数字会随社区变化,采集于 2026-10-10
 查看源码
本站于 2026-10-10 在 Windows + Python 3.11.9 上逐条核验。下面三条结论都能在页面里点到原文或实测输出。
| 你的情况 | 今天该怎么做 | 依据(本站实测) |
|---|---|---|
按中文教程直接执行 pip install pandas-ta | 这条命令在 Python 3.11 上会直接失败。改用 pip install <社区分支包名> | 实测输出:Ignored the following versions ... Requires-Python >=3.12 → No matching distribution found for pandas-ta |
| 我的环境是 Python 3.12 以上,想装原包 | PyPI 上的原包仍在,但只有两个 beta 版本;本站没有 3.12+ 环境,未验证 | PyPI 元数据:0.4.67b0 / 0.4.71b0,Requires-Python: >=3.12 |
| 我想看看官方文档和源码 | 原仓库与官方文档站都无法从本机访问;改用存活仓库的文档 | GitHub 页面与 API 双路径返回 404;www.pandas-ta.dev 本机 DNS 不解析、apex 连接超时 |
| 我担心装到的不是同一个东西 | 先打印版本与指标清单确认身份,再往下写代码 | 本站记录了四种互不相同的「指标数量」口径,见「指标目录」页 |
这一节的全部结论来自 2026-10-10 的直接访问,不做推测。仓库与文档站的状态会变化,复查时请以当天结果为准。
| 核验对象 | 访问地址 | 2026-10-10 结果 | 怎么解读 |
|---|---|---|---|
| 原仓库页面 | 原作者仓库主页 | HTTP 404 | 仓库对匿名访问不可见(已删除或已转为私有) |
| GitHub API | 同一仓库的 API 端点 | HTTP 404 | API 与页面一致,不是页面渲染问题 |
| 作者账号 | api.github.com/users/twopirllc | HTTP 200 | 账号仍在,是仓库本身不可见 |
| GitHub 仓库搜索 | 按项目名搜索(2,067 条结果,按 Star 排序) | 结果里不含原仓库 | 同主题最高相关的活跃仓库是社区分支 |
| 官方文档站 | 文档站主域与 www 子域 | 均不可达(www 不解析、apex 连接超时) | 标注为 qualified:不能排除本机网络因素 |
| PyPI 包页 | pypi.org 上的该项目页 | HTTP 200(仍在线) | 页面上的 Repository 链接仍指向那个 404 地址 |
| 存活社区分支 | 社区分支仓库主页 | HTTP 200,452 Star / MIT / 最后推送 2026-10-02 | 当前 GitHub 上持续维护的对应实现 |
生态里最容易被混淆的一点是:包名、导入名、维护线是三件独立的事。下面这张表是本站核验过的最小对照,详细的迁移步骤见「包与维护线」页。
| 项 | pandas-ta | pandas-ta-classic | pandas-ta-openbb |
|---|---|---|---|
| PyPI 上的最新版本 | 0.4.71b0(2025-09-14) | 0.8.32(2026-09-14) | 0.4.24(本机安装的版本) |
| 导入名 | pandas_ta | pandas_ta_classic | pandas_ta |
| Python 版本要求 | >=3.12 | >=3.10 | 未逐一核验 |
| 依赖 | 硬钉 numba==0.61.2;numpy>=2.2.6、pandas>=2.3.2 | 仅 numpy>=2.0.0、pandas>=2.0.0(numba 可选) | 未逐一核验 |
| 许可 | 无法从当前公开来源复核(仓库已不可见) | MIT | 未逐一核验 |
| 仓库状态 | 404 | 452 Star,2026-10-02 仍有推送 | — |
| 注意点 | 元数据里的 Repository / Documentation 链接都指向已失效地址 | 导入名与包名不同,迁移代码时必须改 import | 它只是本机 pip list 里的另一个分发,与原项目的对应关系本站未核验 |
pandas-ta-openbb 之后,import pandas_ta 是可以成功的——所以「能 import」并不能证明你装的是原作者发布的那一个包。判断身份要看 pip show 的包名,而不是 import 是否报错。照着下面的顺序走一遍,每一步都给出了预期输出与不符合时该查什么。命令在本机 Python 3.11.9 + classic 0.8.32 上实测通过。
python -m venv venv 后 venv\Scripts\pip install pandas-ta-classic。预期:末尾出现 Successfully installed pandas-ta-classic-0.8.32 ...(本机 16.1 秒,会一并装上 numpy 与 pandas)。pip show <包名>。预期:Name: pandas-ta-classic、Version: 0.8.32、Requires: numpy, pandas。若显示的是另一个分发名,说明环境里装的可能不是它。python -c "import pandas_ta_classic as ta; print(ta.version)"。预期:先打印 Pandas TA - Technical Analysis Indicators - v0.8.32 与 Total Indicators & Utilities: 255,再打印 0.8.32。这段横幅走的是 stdout,写 JSON/CSV 的脚本要留意它会不会污染输出。df.ta.sma(length=20, append=True) 后打印 df.columns。预期新增一列 SMA_20。若一列都没加,先查列名是否为 open/high/low/close/volume(见「数据契约」页)。print(df['SMA_20'].notna().idxmax())。预期起始非空值出现在第 20 根 K 线上(0 基索引 19)——前面 19 行是 NaN,这是正常行为,不是数据错误。下面每一条都是本站实测与常见说法不一致的地方。不是要否定教程,而是这些内容写在原仓库还在的时候,今天照做会踩坑。
| 教程里的常见说法 | 2026-10-10 的事实 | 你该怎么做 |
|---|---|---|
pip install pandas-ta 就能装 | Python 3.11 下该方法失败:两个版本都要求 >=3.12 | 按你的 Python 版本二选一,见「安装矩阵」页 |
| 「这个库有 130+ / 224 个指标」 | 同一版本里至少能数出 60 / 62 / 193 / 224 / 255 / 284 六个数字,取决于统计口径 | 写文档或做选型时带上口径与版本,别只抄一个数字 |
import pandas_ta as ta 一定就是原作者那个包 | 本机 import pandas_ta 成功,但提供它的是另一个分发 | 用 pip show 核对分发名 |
| 「结果全是 NaN 就是数据有问题」 | 缺列与数据不足时库不报错、静默不加列;缺口则会让部分指标整列 NaN | 先做列名与长度断言,再看数值 |
| 「装了 numba 就快 6–230 倍」 | 这是官方 README 的声明,本站没有复现,不做背书 | 自己按数据规模测;本站给出的是可复现的测量方法 |
| 「RSI 和 TA-Lib 一样,随便用」 | 本站逐列对照里 9 项有 8 项最大绝对差为 0,MACD 差 0.18 | 把差异当成口径问题而不是 bug,见「TA-Lib 对照」页 |
这一节只讲分工,不讲谁替代谁。pandas-ta 与 EasyClaw 没有已证实集成,本机技能里也没有任何「本项目的包装器」。
| 你要解决的事 | 自建路线(本站主体) | 本机技能路线(备选) |
|---|---|---|
| 把指标算在自己的数据上 | 直接可用:传入任意 OHLCV DataFrame,不绑定数据源 | 取决于具体技能覆盖的市场与标的范围 |
| 需要可复现的实验记录 | 代码即记录:版本、参数、列名都在自己手里 | 属于对话式调用,复现需要保留提问与返回 |
| 只是想知道某只标的现在什么状态 | 要先取数、整理列名、再算指标 | 一句话提问即可(见下方截图) |
| 要批量算几十个标的 | 循环 + 向量化由自己控制 | 成本主要看标的扫描范围,不适合全市场海选 |
| 需要审计「指标是否含未来数据」 | 本站给出可执行的判定脚本 | 不在技能职责范围内 |
| 前置条件 | 只要 Python 环境,无 API Key | 各技能不同:有的需 Token,有的需在客户端面板单独授权 |
IWENCAI_API_KEY、妙想系需要 MX_APIKEY、通达信需要在其客户端面板中单独授权。具体以各技能文档为准。下面两张是本机对话界面的截图(用户 2026-10-10 回拍)。它们演示的是「免部署提问」这种交互形态,不是本项目的运行结果——它是一个库,没有对话界面。
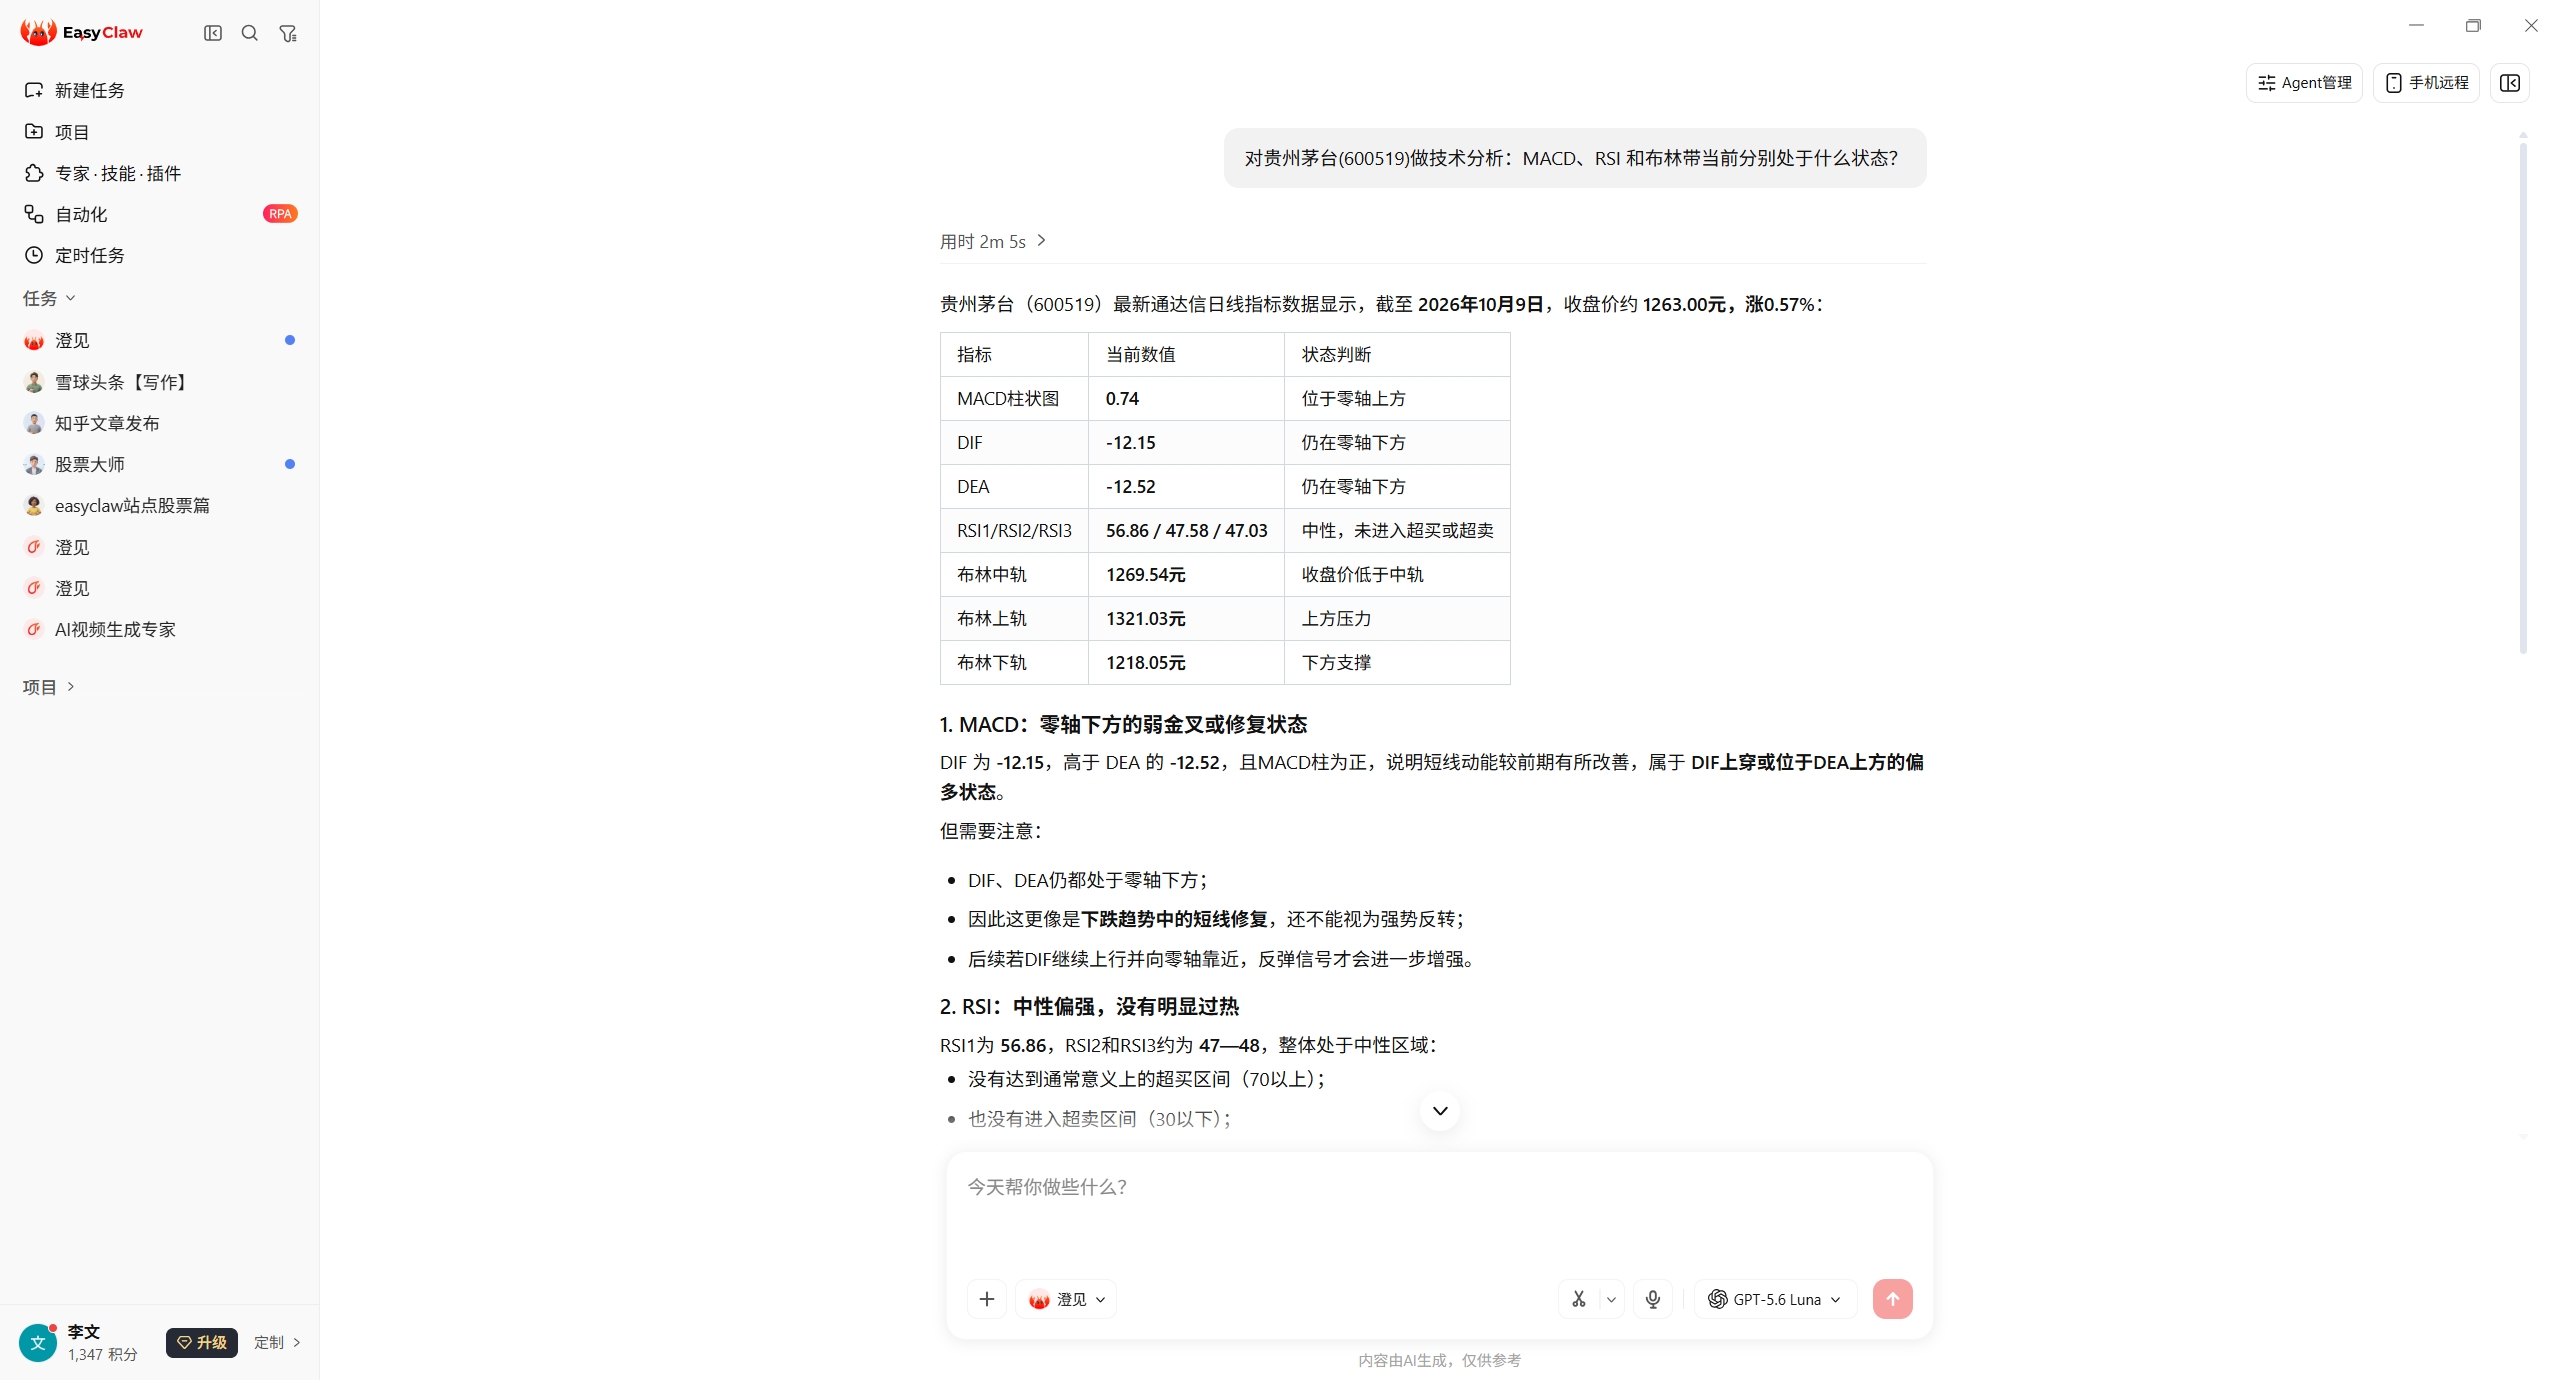
本机对话截图(用户 2026-10-10 在本机 EasyClaw 客户端回拍,截图已归档并做 SHA-256 校验):一句话问「对贵州茅台(600519)做技术分析:MACD、RSI 和布林带当前分别处于什么状态?」,返回截至 2026-10-09 的读数——MACD 柱 0.74 在零轴上方,DIF −12.15 与 DEA −12.52 仍在零轴下方;RSI1/2/3 为 56.86 / 47.58 / 47.03,属中性区间;布林中轨 1269.54、上轨 1321.03、下轨 1218.05,收盘价低于中轨(数据源显示为通达信)。对照本站:同样这几个指标自己算时,先要确认默认参数(pandas-ta 的 bbands 默认 length=5、sma 默认 10),且 MACD 与 TA-Lib 存在 0.18 量级的差。pandas-ta 与 EasyClaw 无已证实集成,截图非 pandas-ta 运行结果;仅供研究,不构成投资建议。
把上一节的路线差异落到具体的人身上。判断标准只有一条:你要不要自己控制数据与指标的口径。
需要把指标接到自己的回测里,必须知道每个列的默认参数、NaN 起点与是否含未来数据。本站的「未来函数审计」页给出了可执行的判定脚本,这是直接从 README 起步拿不到的。
老代码里写的是 import pandas_ta,升级 numpy 或换机器后 import 失败。先看「包与维护线」页判断是版本问题还是包装错了,再决定最小改动的迁移路径。
教学最怕例子跑不起来。本站把「哪条命令今天能跑通」放在首屏,并给出每个指标的默认参数与最小数据长度,方便设计练习。
没有取数需求、也不打算写代码时,自己搭指标管道是绕远路;直接用本机技能路线提问更快,且不需要维护环境。
这个库是指标计算库,不做信号判定、不做回测、不给建议。把 RSI 低于 30 直接当成买入理由是用法错误,不是库的能力问题。
原仓库已不可见,当前维护线是社区分支。生产环境使用前请自行评估维护可持续性。
下面的回答都指向可核验的官方文件或本站实测;与官方表述冲突时,以官方仓库与文档为准。
能确认的只有访问结果:原仓库在 2026-10-10 返回 404(API 与页面一致)。本站没有拿到官方说明,因此不推断原因。当前 GitHub 上持续维护的对应实现是社区分支 xgboosted/pandas-ta-classic。以官方仓库当前状态为准。
取决于 Python 版本:3.12 以上才可能装上 PyPI 上的原包(本站未验证 3.12+ 的实际运行);3.10 / 3.11 只能装 pandas-ta-classic。两者导入名不同,迁移要改 import。
它是独立的社区维护分支,MIT 许可,维护者与原项目不是同一账号。本站不把它等同于原作者发布的版本。是否采用请以仓库当前状态与你的合规要求为准。
三个最常见原因:①列名不是 open/high/low/close/volume(大小写不敏感,但名字必须对);②数据长度小于指标窗口;③数据里有缺口(例如 resample 后插入了周末空行)。前两种库不报错、静默不加列,第三种会整列 NaN。详见「数据契约」页。
不能。这个库只做指标计算,不含行情获取、不含下单、不含回测。本站不提供任何投资建议;任何基于指标的结论都需要你自己回测与评估。
页面标注了采集日期 2026-10-10。仓库状态、Star 数与版本号会变化,复查时请重新核验;本站不会替官方给出「最新」结论。