行业暴露被当成因子能力
如果因子值本身与行业高度相关(例如市值、估值类因子),全样本 IC 可能主要来自行业间的收益差异。加 groupby 并把 binning_by_group 打开后重跑,若 IC 明显衰减,就说明原结论里混着行业暴露。
Alphalens · IC 与 IR
IC 回答一个最直接的问题:这一期的因子值排名,和下一期收益的排名,是否同向。Alphalens 用 Spearman 秩相关来算,并把它扩展成 IC 时序、IC 分布、分行业 IC 与月度热力图四类视图。这一页把口径、函数和读法摊开讲,也如实回答「IC 多少算好」这个问题。
performance.py 的 IC 相关函数链整理(非官方图);具体实现以源码为准。这三个数经常被混着说成「IC」,但它们在库里的计算方式与用途都不同。下表每一行都能在 performance.py 里找到对应函数。
| 指标 | 算法口径 | 对应函数 | 怎么读 | 适用场景 | 注意点 |
|---|---|---|---|---|---|
| IC(逐期) | 每个交易日内,因子值与对应期 forward return 的 Spearman 秩相关 | factor_information_coefficient(factor_data) | 得到一个「日期 × 期数」的矩阵,每期一个值,看它的时序与分布 | 判断因子的方向性与稳定性 | 秩相关只关心排序,不关心幅度;单期值波动很大属正常 |
| IC 均值 | 把逐期 IC 按期数取平均(可再按分组/时间维度细化) | mean_information_coefficient(factor_data, by_group=..., by_time=...) | 均值接近 0 说明当期没有明显预测性;符号决定方向 | 跨因子横向比较的第一眼指标 | 均值高不等于稳定,必须同时看标准差 |
| IR(信息比率式指标) | IC 均值 ÷ IC 标准差(库未提供单独函数,需自己用 IC 矩阵算) | 由 factor_information_coefficient 的输出自行计算 | 衡量「单位波动换来的 IC」,越大说明 IC 越稳定 | 比较两个均值相近但稳定性不同的因子 | 样本期越短,标准差越不可靠,IR 越容易虚高 |
| alpha / beta | 用因子收益对市场收益做回归,得到超额收益与暴露 | factor_alpha_beta(factor_data) | beta 说明因子组合是不是在偷偷跟着市场走 | 判断因子是否只是市场 beta 的代理 | 回归口径与样本期强相关,结论要写清样本范围 |
库里的绘图函数一共 22 个,与 IC 直接相关的是下面这几类。选哪张图取决于你在判断什么,不是越多越好。
| 视图 | 绘图函数 | 回答的问题 | 怎么看 | 适用场景 | 注意点 |
|---|---|---|---|---|---|
| IC 时序 | plot_ic_ts | IC 有没有稳定的方向,还是忽正忽负 | 看滚动均值线的斜率与穿越零轴的频率 | 因子方向性初判 | 多期同图时容易被不同期数放大缩小弄乱,注意图例 |
| IC 分布 | plot_ic_hist、plot_ic_qq | IC 分布是否围绕某个非零值,尾部有多长 | 直方图看中心与偏度;Q-Q 图看是否接近正态 | 判断 IC 的稳定性与极端期占比 | 样本期短的时候分布形状不可靠 |
| 分行业 IC | plot_ic_by_group | 因子在哪些行业更有效 | 比较各分组均值条的差距 | 做行业中性化前后的对照 | 需要提供 groupby;行业样本不均时排名会失真 |
| 月度热力图 | plot_monthly_ic_heatmap | IC 有没有季节性、哪几个月特别差 | 看颜色成块还是随机分布 | 判断失效是否集中在特定时段 | 年份少的时候很容易看出「规律」,但那可能只是噪声 |
| IC 表格 | plot_information_table | 把均值、标准差、t 值等汇总成一张表 | 直接读表,不依赖图形判读 | 写研究记录、贴进报告 | 表格里的统计量依赖样本期长度 |
Alphalens 的每一步都给出可执行代码与预期输出形态。合成数据下的数值不能作为结论,只用于确认链路是否跑通。
ic = alphalens.performance.factor_information_coefficient(factor_data)。预期:得到一个以日期为索引、以持有期为列的 DataFrame;列名就是 periods 里的期数。
ic.mean() 与 ic.std(),并用 ic.mean() / ic.std() 得到 IR。预期:均值给出方向,标准差给出稳定性;两个数一起看才有意义。
alphalens.plotting.plot_ic_ts(ic)。预期:一张 IC 时序图叠加滚动均值;在 Notebook 里直接显示,脚本里需要指定 Agg 后端再保存。
mean_information_coefficient(factor_data, by_group=True) 与 plot_ic_by_group。预期:按行业/分组给出 IC 均值;如果只有个别分组有 IC,说明因子其实是行业暴露在起作用。
把 IC 结论与分位收益结论对照(见「分位收益」页)。预期:多数情况下两者同向;不一致时优先相信分位收益,因为它包含了极端分位的信息。
官方 README 与四个模块的文档里都没有「IC 达到多少算有效」的说法。这不是遗漏——阈值取决于市场、频率、持有期与样本长度。下面是一套不依赖阈值的判读顺序。
| 判读顺序 | 看什么 | 说明了什么 | 下一步动作 |
|---|---|---|---|
| 1. 符号是否稳定 | IC 均值符号与逐期 IC 的正比例 | 方向性是否存在 | 正比例长期接近五成,说明这个因子在当前频率下没有信息 |
| 2. 均值与波动之比 | IC 均值 ÷ IC 标准差 | 单位波动换来的 IC | 比值低说明信号被噪声淹没,考虑换频率或换因子定义 |
| 3. 期数敏感度 | 不同 periods 的 IC 均值变化 | 信号的半衰期 | 只在前 1 期有效说明需要高频调仓,成本要另算 |
| 4. 分组一致性 | 分行业 IC 的离散程度 | 是不是行业暴露伪装成因子 | 高度集中在少数行业时,做行业中性后再看一遍 |
| 5. 时间稳定性 | 月度热力图是否有整片失效期 | 因子是否已失效或只在特定阶段有效 | 有整片负值区就要在报告中写明样本期依赖 |
| 6. 与分位收益是否同向 | IC 结论 vs 分位收益单调性 | 结论是否自洽 | 不一致时先查分位划分与极值处理参数 |
下面四种情形在真实研究里很常见,官方文档没有专门提醒,但它们足以让结论翻转。
如果因子值本身与行业高度相关(例如市值、估值类因子),全样本 IC 可能主要来自行业间的收益差异。加 groupby 并把 binning_by_group 打开后重跑,若 IC 明显衰减,就说明原结论里混着行业暴露。
因子存在大量零值时,默认 zero_aware=False 会把零值与前 20% 的低值混进同一分位,导致最低分位收益被稀释、分位单调性被破坏。事件类因子尤其要注意这个参数。
filter_zscore 默认 20 只处理收益端的极端值,不处理因子端的极值。因子端如果有个别巨额值,分位边界会被拉偏,此时更适合用 bins 传入自定义边界(例如按分位点)。
IC 是各期分别算的,但真实调仓只能选一个频率。用 10 日 IC 的结论去做日频调仓,等于把不同的持有期混在一起读;读 IC 时先把 periods 与计划的调仓周期对齐。
中文文章常把这些统称「IC 分析」,但它们在库里的可得性完全不同。下表明确区分,避免你以为某个数字是 Alphalens 算的。
| 统计量 | 库是否直接提供 | 怎么得到 | 怎么用 | 注意点 |
|---|---|---|---|---|
| IC 均值 / 逐期 IC | 直接提供 | factor_information_coefficient、mean_information_coefficient | 方向与强度 | 必须与标准差一起看 |
| IC 标准差 | 由逐期 IC 自行计算 | ic.std() | 稳定性 | 样本期短时不可靠 |
| ICIR | 需自己算 | ic.mean() / ic.std() | 单位波动换来的 IC | 库没有单独函数,报告里要写明算法 |
| t 值 | 报告表里出现,但没有独立函数 | 由 IC 序列自行计算:mean / (std / sqrt(n)) | 粗略判断显著性 | 重叠窗口会让 t 值虚高 |
| p 值 | 不提供 | 自行做检验(如 scipy.stats) | 辅助判断 | p 值小不等于可交易,见下一节 |
| IC 偏度 / 峰度 | 不提供 | ic.skew()、ic.kurt() | 看分布形态与尾部风险 | 偏度大说明少数期主导结论 |
| IC 正值占比 | 不提供 | (ic > 0).mean() | 方向一致性 | 比均值更抗极端期影响 |
这一节是本站刻意的差异化内容——大多数中文教程在「生成报告」处就结束了。下面每一条都能让一份漂亮的 IC 报告失去意义。
| 陷阱 | 表现 | 为什么会骗你 | 怎么自查 | 注意点 |
|---|---|---|---|---|
| 多重检验(p-hacking) | 试了几十个因子,挑出 IC 最好的那个 | 试得够多,随机数据也会出现「显著」结果 | 记录试过的全部因子数量,必要时做多重比较校正 | 「换参数不换结论」是更实用的稳健性证据 |
| 样本内过拟合 | 参数在历史期最优 | 参数是照着这段数据选的 | 留出样本外区间,或至少做时间上的分段验证 | 分段后结论反转是常态,不是意外 |
| 重叠收益自相关 | 用 5/10 日窗口算 IC,t 值很高 | 相邻窗口的收益高度重叠,有效样本量远小于名义样本数 | 用非重叠窗口复核,或对自相关做校正 | 持有期越长,这个问题越严重 |
| 未做 walk-forward | 只报告一段完整区间 | 忽略了因子在不同市场阶段的失效 | 滚动窗口逐段看 IC 符号与量级 | 与月度热力图(plot_monthly_ic_heatmap)配合看 |
| IC 高但换手极高 | ICIR 好看,成本吃掉全部价差 | 统计有效不等于可实现 | 把换手与成本一起纳入(见「换手与自相关」页) | 成本假设必须换成自己的费率 |
| 只报均值不报分布 | IC 均值 0.03 | 可能由极少数期贡献,其余期为负 | 看 IC 正值占比、偏度与逐期分布图 | 信息比率与占比同时看才完整 |
| 股票池随时间变化被忽略 | 用当前成分股回测过去 | 存活偏差系统性抬高结果 | 逐日构建标的池 | 与「因子输入」页的未来函数清单一起用 |
很多因子看起来有效,实际只是暴露在小市值、某个行业或高波动风格上。中性化的目的是把这些暴露剥掉,再看信号还剩多少。
把因子与行业哑变量、对数市值、Beta 求相关(factor.corr(...))。预期:能说清因子与哪些暴露高度相关;相关系数接近 0 的维度不必中性化。
给清洗函数传 groupby(行业)并打开 binning_by_group=True。预期:分位切分在每个行业内部进行;对比中性化前的分组 IC,看结论是否衰减。
用因子对 log(市值)(必要时加 Beta)做横截面回归,把残差当作新因子重跑清洗与 IC。预期:同一套指标在新因子上重新计算,得到「剥离暴露后」的 IC 与分位收益。
把「中性化前 / 后」的 IC 均值、ICIR、多空价差、换手率并列。预期:如果中性化后 IC 大幅衰减,说明原结论主要来自暴露;如果基本不变,这个因子更可能是独立信号。
把行业分类版本、市值口径(总市值/流通市值)、回归窗口写进研究记录。预期:换个人也能复现同一张对比表。
| 中性化方式 | 剥掉什么 | 做法 | 适用场景 | 注意点 |
|---|---|---|---|---|
| 行业内分箱 | 行业间收益差 | groupby + binning_by_group=True | 行业间差异远大于行业内的因子 | 行业样本不均时小行业分位会失真 |
| 行业中性化(去均值) | 行业整体水平 | 行业内对因子值去均值 | 想保留行业内排序信息 | 去均值会压缩极端值 |
| 市值中性化 | 规模暴露 | 对 log(市值) 回归取残差 | 因子与市值天然相关(如价值类) | 市值口径(总/流通)会改变结果 |
| Beta 中性化 | 市场暴露 | 对 Beta 回归取残差 | 怀疑因子只是市场代理 | Beta 估计窗口的选择影响很大 |
| 因子正交化 | 与已有因子的共同部分 | 对已有因子回归取残差(逐个或矩阵) | 构建多因子体系 | 正交化顺序会改变结果,需固定 |
| 因子相关性矩阵 | —(诊断手段) | 多个因子横截面相关矩阵 | 判断因子是否重复 | 相关性高不等于可替代 |
教程通常只跑 1/5/10 日,却不说这三个数字该怎么选。下面这张图是本机真跑的 IC 衰减曲线,用来演示「信号集中在短窗口」时的形状。
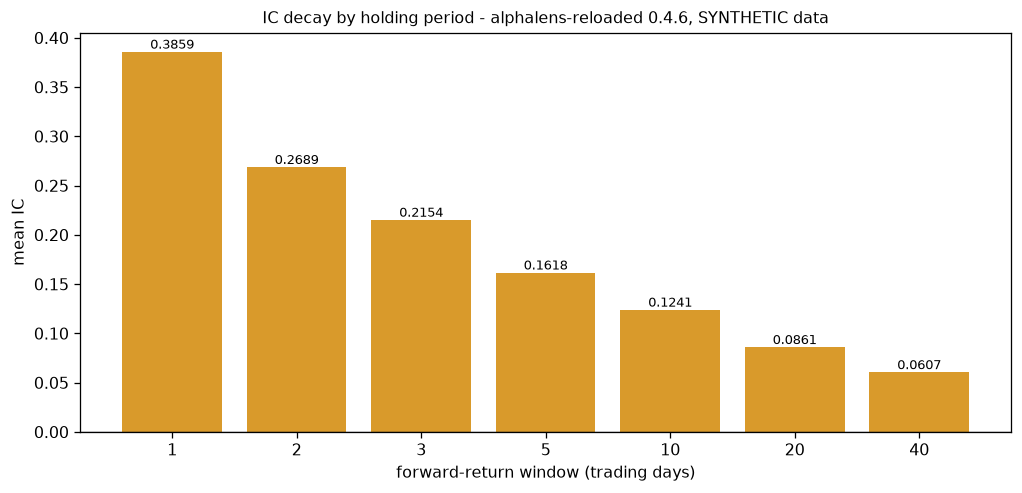
0.3859,逐期降到 2 日 0.2689、5 日 0.1618、10 日 0.1241、40 日 0.0607;ICIR 从 3.619 降到 0.471。它演示的是「信号集中在短窗口」时的形状,不代表任何真实因子的水平。| 衰减形态 | 含义 | 调仓含义 | 还要看什么 | 注意点 |
|---|---|---|---|---|
| 陡降后趋零 | 信号只在前几个交易日有效 | 只能短周期调仓,成本压力大 | 换手率与成本(见「换手与自相关」页) | 高 IC 配上极高换手,扣成本后可能归零 |
| 缓降但不归零 | 信号有长期成分 | 可以拉长持有期以摊薄成本 | 不同期数的 ICIR 是否稳定 | 长窗口的样本量更少,结论更不稳 |
| 中途反弹 | 可能与季度/年度效应或数据问题有关 | 先别据此选周期 | 月度热力图、分组一致性 | 常见成因是样本太短或极值未处理 |
| 整体贴零 | 当前频率下没有可用信号 | 不必继续调参 | 换频率或换因子定义 | 不要靠增加持有期「凑」出显著性 |
periods 设成一组能覆盖你候选调仓周期的值(例如日频、周频、双周频、月频),先看 IC 衰减到哪一期仍为正且 ICIR 不塌,再回到「换手与自相关」页估算该周期的成本。两步都过了,才值得写进研究记录。IC 相关表述以 performance.py 的实现与官方 README 为准;本站未接真实行情数据源,示例均为合成数据。
官方没有给阈值,也不该有一个通用阈值:它取决于市场、样本期长度、持有期与因子类型。可操作的做法是按上面的六步判读顺序,看符号是否稳定、均值与波动之比、期数敏感度、分组一致性与时间稳定性,而不是记一个数字。
IC 是逐期的相关系数(一个时序),IR 通常是 IC 均值除以 IC 标准差(一个比值)。前者看方向,后者看稳定性。库里有前者的现成函数,后者需要自己按 IC 矩阵计算。
先确认三件事没变:因子定义、价格表、清洗参数(分位与 periods)。如果三者都没变而结果不同,通常是数据里有重复日期、排序不稳定或缺失值处理路径不同。IC 本身是确定性计算,不引入随机性。
在因子研究里差别可能很大:Spearman 只看排名,所以对极端值和非线性单调变换不敏感;如果你的因子有长尾分布,用线性相关算出的「IC」会被少数极端值主导。库里用的是秩相关,这也是行业惯例。
它让 IC 均值按时间维度聚合(例如按月度给出均值),是判断「哪段时间失效」的快捷方式,与月度热力图回答的是同一类问题。具体聚合方式以源码参数说明为准。
不说明。IC 只描述排序与未来收益的统计关系,不包含交易成本、容量、可交易性与风控约束。要判断能不能用,还要看换手率(见「换手与自相关」页)与分位收益的实际幅度,并且这些结论都不构成任何投资建议。
没有已证实集成。本机技能里的 quant-analyst 提供量化研究方法论(回测、风险指标、组合优化),但它不实现 IC/IR 这套因子绩效口径;IC 计算必须在你自己装了 Alphalens 的环境里跑。
没有。官方文档站与 README 都是英文,且没有专门的 IC 判读章节。本页的口径与判读顺序由源码函数签名、docstring 与官方示例 notebook 的图目录整理而来,阈值部分明确标注为「官方未给」。