Alphalens · 因子与价格输入契约
Alphalens 因子输入:两张表怎么喂进 get_clean_factor_and_forward_returns
Alphalens 的所有后续分析都建立在一个对象上——factor_data。它由清洗入口一次性生成:把因子值与价格对齐,切分位、算 forward returns、过滤极值、校验数据丢失比例。这一步的参数怎么设,直接决定后面 IC 与分位收益的结论。
Alphalens 的两张表怎么变成 factor_data
utils.py 的函数签名与 docstring 整理的输入—输出示意(非官方图);字段名以源码为准。Alphalens 的两张输入表到底要长什么样
Alphalens 对两张输入表的每一列都有具体要求,不是示意。常见错误一列来自公开 issue 与本站运行记录。
| 输入 | 类型 | 索引要求 | 内容要求 | 常见错误 | 注意点 |
|---|---|---|---|---|---|
| factor(因子值) | pandas Series | MultiIndex,第一层日期、第二层标的,名字通常为 date / asset | 每期每个标的的因子值(可以是原始值,不必先标准化) | 用单层索引或把日期当字符串 | 索引名要与后续 groupby 的索引层名一致 |
| prices(价格) | pandas DataFrame | index 为日期,columns 为标的 | 每个交易日的价格(收盘价即可),列名与因子第二层索引一致 | 传收益率而不是价格;列名与因子不一致导致大量标的被丢 | 官方 issue #253 / #270 请求支持收益率输入,至今未合并——只能给价格 |
| groupby(可选分组) | Series | index 为标的 | 每个标的所属行业/板块等 | 分组标签与标的对不上 | 给了分组才能做行业内分箱与分组 IC |
| groupby_labels(可选) | dict | — | 分组编码到可读名字的映射 | 只给编码,图里出现 0/1/2 | 与 groupby 一起使用才有效 |
| periods(持有期) | tuple | — | 要计算的 forward return 期数,默认 (1, 5, 10) | 给了库里没有的频率(如小时)导致频率推断失败 | 期数越多计算越慢,产出列也越多 |
| binning_by_group | bool | — | 是否在每个分组内部单独分箱 | 与 quantiles 混用时期待值不符 | 做行业中性因子时通常打开 |
Alphalens 清洗参数怎么改:六个参数逐个说
默认值全部来自 utils.get_clean_factor_and_forward_returns 的签名。中文资料通常只给示例代码,不讲这几个参数会怎样改变结论。
| 参数 | 默认值 | 作用 | 调大/调小的后果 | 什么时候该改 | 注意点 |
|---|---|---|---|---|---|
quantiles | 5 | 按因子值切成几个等份分位 | 分位越多越能看出单调性细节,但每组样本变少、噪声变大 | 想观察极端分位表现时可试 10 | 与 bins 互斥,同时给会抛错 |
bins | None | 按给定边界自定义分箱 | 可以做成非等宽分箱(如按因子分布取分位点) | 因子分布极度偏斜时 | 边界必须唯一,官方专门为此定义了一个错误提示 |
periods | (1, 5, 10) | 计算哪几期的 forward return | 期数越多,越能看出信号衰减速度 | 要判断因子适合多长持有期时 | 期数需要与价格频率匹配,否则频率推断报错 |
filter_zscore | 20 | 按期把偏离均值 20 倍标准差的收益视为异常并剔除 | 调小会更激进地剔除极值;设为 None 则完全不过滤 | 数据里有明显的错误价格时 | 过滤掉的是收益不是因子值,别和因子极值处理混淆 |
max_loss | 0.35 | 允许被丢弃的数据比例上限 | 设为 0 会让任何缺失都直接报错;放宽则可能让结论建立在被大量丢弃的数据上 | 数据本身缺失较多、又确认可接受时 | 清洗后会打印实际丢弃比例,请核对这个数字 |
zero_aware | False | 是否把「因子值为 0」单独当作一类处理 | 为 False 时零值会落进最低分位,可能污染最低分位的收益 | 因子存在大量零值(如事件类因子)时 | 官方为此单独开过 issue(#281/#306),说明这是真实痛点 |
cumulative_returns | True | forward return 是否按累计口径计算 | 切换口径会改变多周期收益的读法,进而影响累计收益图 | 要与既有研究口径对齐时 | 累计收益口径本身存在争议,见「分位收益」页 |
Alphalens 的 factor_data 怎么从零做出来
四步都是在 Notebook 或脚本里能直接执行的代码。预期输出写的是形状与列名,便于你确认自己走对了。
造因子 Series(两层索引)
factor = pd.Series(values, index=pd.MultiIndex.from_product([dates, assets], names=["date", "asset"]))。预期:factor.index.names显示['date', 'asset'];如果这里名字不对,后面的分组与分箱都会歪。造价格 DataFrame
prices = pd.DataFrame(close_matrix, index=dates, columns=assets),其中 close_matrix 是「日期 × 标的」的价格矩阵。预期:prices.shape的列数等于标的数;价格必须是价格,不能是收益率。清洗
factor_data = alphalens.utils.get_clean_factor_and_forward_returns(factor, prices, quantiles=5, periods=(1, 5, 10))。预期:返回的多重索引 DataFrame 含factor、factor_quantile与三个 forward return 列;控制台会打印丢弃数据比例,超过 max_loss 会直接抛错。自检三件事
一是
factor_data.columns里期数列是否与 periods 一致——列名是「期数 + D」的字符串(如1D、5D、10D),不是整数,用整数下标取列会直接 KeyError(本机实测踩到过这一点);二是factor_data["factor_quantile"].value_counts()各分位是否大致均衡;三是丢弃比例是否可接受。预期:三项都能对上,才继续算 IC。
Alphalens 为什么只收价格、不收收益率
社区里讨论最久的一条需求就是「能不能直接传收益率」。这件事决定了你的数据准备工作量,所以单列一节。
| 问题 | 现状 | 证据 | 你该怎么做 |
|---|---|---|---|
| 能不能传收益率而不是价格? | 不能。库内部按 periods 从价格自行推算 forward returns | issue #253(57 条评论,2018-01 开)与 #270(22 条评论)提出该 API 需求,均未合并 | 把收益率反推成价格序列,或改用其他因子分析实现 |
| 能不能只给因子不给价格? | 不能,价格是必填参数 | get_clean_factor_and_forward_returns(factor, prices, ...) 签名 | 先解决数据来源,再谈分析;Alphalens 本身不提供行情 |
| 能不能处理日内数据? | 可以,但频率需要能被 pandas 推断出来,examples 里有 intraday_factor.ipynb 示例 | examples 目录清单 | 保证索引是连续可推断频率的时间序列,否则会遇到频率相关报错 |
| 停牌/缺失交易日怎么办? | 由清洗阶段按 max_loss 与 filter_zscore 处理 | 源码参数与 docstring | 先把缺失比例看清楚,别用放宽 max_loss 来掩盖数据问题 |
| 多因子怎么办? | 库按单因子设计,多因子交互属于长期未合并的能力 | issue #177(多因子支持)与 #258(两因子交互开发)均为旧请求 | 拆成多个单因子分别跑,或自己在别的框架里组合 |
| 数据从哪来? | 库不提供,也不引用任何数据源 | 四个模块源码中无数据源引用 | 用你自己的数据,或本机已核验的 akshare-finance / tushare-finance 技能取数后再喂进来 |
Alphalens 的输入表是什么形状:长表、宽表与 MultiIndex
新手卡住的地方通常不是算不出指标,而是数据形状不对。下表把「长表」「宽表」两种形态、转换方式与校验点一次讲清。
| 环节 | 长表(long) | 宽表(wide) | 转换方式 | 注意点 |
|---|---|---|---|---|
| 形状 | 每行一条「日期 + 标的 + 数值」记录 | 行是日期、列是标的 | 长 → 宽 pivot;宽 → 长 stack | Alphalens 的 factor 是两层索引的 Series,prices 是宽表 |
| 典型来源 | 数据库导出、CSV、Tushare / AKShare 的返回结果 | 行情矩阵、因子矩阵 | df.set_index(["date","asset"]) 后取列成 Series | 列名与顺序要固定,否则两次运行结果不同 |
| 索引名 | 需要两层命名(通常 date / asset) | 单层日期索引 | index.set_names([...]) | 索引层名要与后续 groupby 的字段名一致 |
| 校验点 1 | 日期是否为 DatetimeIndex 且可推断频率 | pandas.infer_freq(idx) | 无法推断频率会在清洗阶段直接报错 | |
| 校验点 2 | 是否存在重复的 (date, asset) | df.index.duplicated().sum() | 重复索引会让分位切分结果失真 | |
| 校验点 3 | 因子与价格的标的集合是否一致 | 集合差 set(f.index.get_level_values(1)) - set(prices.columns) | 对不上的标的会被清洗阶段整批丢弃 | |
| 校验点 4 | 缺失值与异常值的规模 | df.isna().mean()、df.describe() | 丢弃比例超过 max_loss 会直接抛错 | |
未来函数怎么防:五类时间与 shift(-1) 何时合理
这是中文资料普遍讲不透的一节。因子研究里一共有五个不同的时间点,把它们混起来用,就是未来函数。
| 时间点 | 含义 | 常见错误 | 正确做法 | 注意点 |
|---|---|---|---|---|
| ① 因子计算时间 | 你实际能算出因子值的最早时刻 | 用当日收盘价算因子,又用当日收盘价成交 | 用 T 日收盘数据算因子,最早在 T+1 开盘成交 | 用收盘价成交是最常见的隐性未来函数 |
| ② 数据可得时间 | 原始数据真正对外发布的时刻 | 用财报「报告期」当「可知日」 | 财务数据一律按公告日(或更保守的可得日)对齐 | 季报存在滞后,且会修正 |
| ③ 下单时间 | 决策落单的时刻 | 因子、成交、下单三者错位 | 明确写出「T 日收盘算因子 → T+1 开盘下单」 | 回测与因子评估的时间口径必须一致 |
| ④ 成交时间 | 订单真正被撮合的时刻 | 假设任意价格都能成交 | 涨跌停、停牌、流动性不足都要显式排除 | 报告里的多空价差通常不含这一层约束 |
| ⑤ 收益计算时间 | forward return 覆盖的窗口 | 用同一根 K 线算因子又算收益 | 因子用 T 日,收益从 T+1 起算(periods 由库按价格自行推算) | shift(-1) 只在「收益从下一期开始」时合理 |
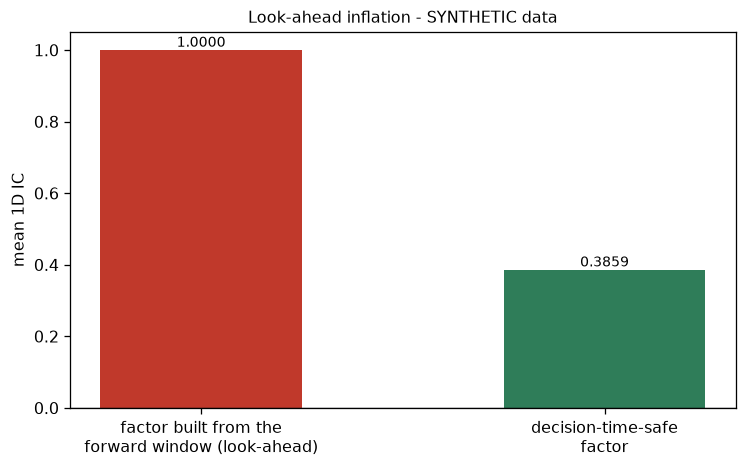
1.0000,而决策时点安全的因子为 0.3859(约 2.6 倍差异)。它演示的是机制,不是任何真实因子的水平。shift(-1) 的每一次使用是否都能说清它代表什么时点。任一条答不上来,结论就不可信。A 股数据怎么接进 Alphalens:AKShare / Tushare 转两张表
本节只做一件事:把常见 A 股数据源的返回结果,转成 Alphalens 能吃的两张表。转换本身是确定性的格式工作,不涉及任何数据源可用性承诺。
取日线行情并转成宽表
prices = df.pivot(index="date", columns="code", values="close").sort_index();价格列名必须与因子表第二层索引完全一致(建议统一成 6 位数字代码字符串)。预期:prices.shape为「交易日数 × 标的数」,索引可被infer_freq推断。决定复权口径并写进记录
用后复权或前复权价格计算因子与收益,并在研究记录里写明所选口径。预期:同一段区间内复权价与原始价差异明显,选错口径会让新旧股票的可比性失真。
构造因子 Series(两层索引)
factor = pd.Series(values, index=pd.MultiIndex.from_product([dates, codes], names=["date","asset"]))。预期:factor.index.names == ["date","asset"]。先做数据体检,再清洗
统计停牌(价格为 0 或缺失)、涨跌停、ST、上市不足 N 日的新股占比。预期:能说出「哪些标的被排除、为什么」,而不是让库替你丢数据。
清洗时把股票池随时间变化讲清楚
用
max_loss约束丢弃比例,必要时在清洗前就用日期逐日构造动态股票池。预期:丢弃比例可解释(本机合成数据示例为 4%–8%),且没有整段区间被静默丢弃。
| A 股特有数据问题 | 对因子分析的后果 | 处理建议 | 注意点 |
|---|---|---|---|
| 停牌日价格缺失 | forward return 窗口被截断,收益失真 | 停牌期间不出信号,或在清洗前剔除 | 停牌复牌后常有跳空,应单独观察 |
| 涨跌停无法成交 | 多空组合里包含实际买不到/卖不掉的标的,收益被高估 | 把「无法成交」显式排除,或改用次日可成交口径 | 报告里的多空价差不含这一层约束 |
| 复权方式不一致 | 前后复权混用会让长期收益完全对不上 | 全流程统一口径并记录 | 后复权价不等于真实成交价 |
| ST / 退市股票 | 存活偏差,回测结果偏乐观 | 按当日的真实可交易状态构建股票池 | 用「当前成分股」回测过去是最常见的错 |
| 新股上市初期 | 极端收益与极端换手污染分位切分 | 设置上市满 N 个交易日才纳入 | N 的取值要在报告里写明 |
| 动态股票池 | 成分股历史变化被忽略 | 逐日构建标的池,而不是固定一份名单 | 指数成分变动频率因指数而异 |
| 行业分类变更 | 分组 IC / 行业内分位被污染 | 使用「当时生效」的分类版本 | 分类标准(申万/中信等)版本也要记录 |
| 财务数据公告日 | 用报告期对齐会造成未来函数 | 一律按可得的公告日对齐,并考虑修正公告 | 年报/季报滞后天数不同,需逐类确认 |
TUSHARE_TOKEN,声明支持 220+ 接口)。它们只负责把数据取出来,格式转换与因子评估仍在 Alphalens 侧完成,两者无已证实集成。案例:市值因子与动量因子怎么走完整流程
这两个因子最适合入门:计算方式直观、方向容易验证、正好代表「正向」与「反向」两种符号约定。下面把两段流程并列写出,代码结构相同、只换因子定义。
| 步骤 | 市值因子(size) | 动量因子(momentum) | 关键差异 | 注意点 |
|---|---|---|---|---|
| 因子值 | 总市值(或其对数值) | 过去 N 日收益率(如 20 日) | 市值用「时点可得」的市值,动量用价格序列 | 都要用当时可得的数值,不能用最新值回填历史 |
| 符号方向 | 常用「小市值为高因子值」,需对市值取负或取倒数 | 正动量即高因子值 | 方向决定分位收益读法 | 方向搞反时,分位图会呈现反向阶梯 |
| 常见预处理 | 取对数、行业中性化 | 剔除停牌与涨跌停日 | 市值天然带行业与风格暴露 | 不做中性化时,结论可能只是风格暴露 |
| 期望形态 | 分位收益阶梯较弱,且与市场风格阶段强相关 | 短周期动量较强,长周期常出现反转 | 两者对持有期敏感度不同 | 用 IC 衰减曲线确认信号集中在哪个窗口 |
| 必查项 | 是否与行业、Beta 高度相关 | 是否受少数极端涨幅股主导 | 都需做极值处理 | filter_zscore 只处理收益端极值 |
| 报告口径 | 写明中性化方式与股票池 | 写明动量窗口与调仓周期 | 两者都需记录版本与参数 | 换参数不换结论,才能说明结论稳健 |
# 两个案例共用同一段流程,只换 factor 的定义(示意,非本机输出)
for name, factor in {"size": -np.log(mkt_cap), "momentum_20d": close.pct_change(20)}.items():
    factor = pd.Series(factor.values.ravel(),
                       index=pd.MultiIndex.from_product([dates, codes], names=["date", "asset"]))
    factor_data = alphalens.utils.get_clean_factor_and_forward_returns(
        factor, prices, quantiles=5, periods=(1, 5, 10))
    print(name, factor_data.shape, list(factor_data.columns))
    ic = alphalens.performance.factor_information_coefficient(factor_data)
    print(name, "mean IC:", ic.mean().round(4).to_dict())
Alphalens 因子输入常见问题
函数行为以源码签名与 docstring 为准;参数默认值可能随维护分支变化,动手前请再核对官方代码。
因子值需要先标准化或去极值吗?
不需要预先标准化:这个函数会按分位切分,分位本身对量纲不敏感。但极值会影响分位边界,所以库提供了 filter_zscore 与 zero_aware 两个参数来处理收益端与零值端的问题。具体口径以源码实现为准。
quantiles 和 bins 到底该用哪个?
想要等份分位就用 quantiles(默认 5 组);想要自定义不等宽分箱就用 bins 传边界数组。两者互斥,同时给会抛错,错误提示就是官方为这个场景专门写的。
清洗时丢弃了多少数据怎么看?
函数会打印清理过程的统计(包括丢弃比例),并且只要超过 max_loss(默认 0.35)就直接抛错。判断标准很简单:丢弃比例高的时候,先修数据,别调参数。
能直接用 DataFrame 里的某一列当因子吗?
需要先取成带两层索引的 Series。把 DataFrame 某列 stack() 之后就是常见做法,这也正是公开 issue #402 里用户的做法。索引层顺序要对,否则清洗阶段会因为匹配不上而大量丢弃。
为什么我算出来的分位收益方向是反的?
先确认分位编号方向:库把因子值最大的一组分位编号最大还是最小,直接决定「第 5 组」是高因子还是低因子。同时确认因子定义方向(你希望高因子值对应正收益还是负收益),这两件事对不上,读图结论就会反。
没有行业分组会影响结果吗?
会。不给 groupby 时,分位划分在全样本内进行,行业暴露会混进收益里;给了 groupby 才能看「行业内」的分位表现(binning_by_group)。是否要做行业中性,取决于研究问题,不取决于库。
这一步和免部署技能有关系吗?
没有已证实集成。取数环节可以用本机已核验的 akshare-finance 或 tushare-finance 技能帮你把因子与价格整理出来,但清洗与后续分析仍要在你自己的 Python 环境里跑,Alphalens 无法在对话式环境里运行。
本站的示例数据是真的行情吗?
不是。本站没有接任何真实行情数据源,页面上出现的运行记录与图表全部基于合成数据,并且已逐处标注。真实因子结论必须用你自己的数据重跑。