MIT 开源 · 21 个 Skill · 3,018 份报告文件
AI Berkshire:把价值投资研究方法论写成可复核的 AI 工作流
AI Berkshire(xbtlin/ai-berkshire)同时兼容 Claude Code 与 Codex,
把巴菲特、芒格、段永平、李录四位大师的方法论拆成 21 个可调用的投研 Skill,
再配一层精确计算与报告抽检工具。本站是它的中文可验证手册:
能告诉你每一条结论出自哪个文件、哪次实测。
- 全站依据固定 commit
55be4f7(2026-09-27 最后提交)与 2026-09-28 核验日期 - 本机实跑 15 条上游命令、26 个上游单元测试,输出原文留档
- 不做收益宣传:README 里的实盘收益截图只在「AI 投研边界」页作反面案例
项目来源
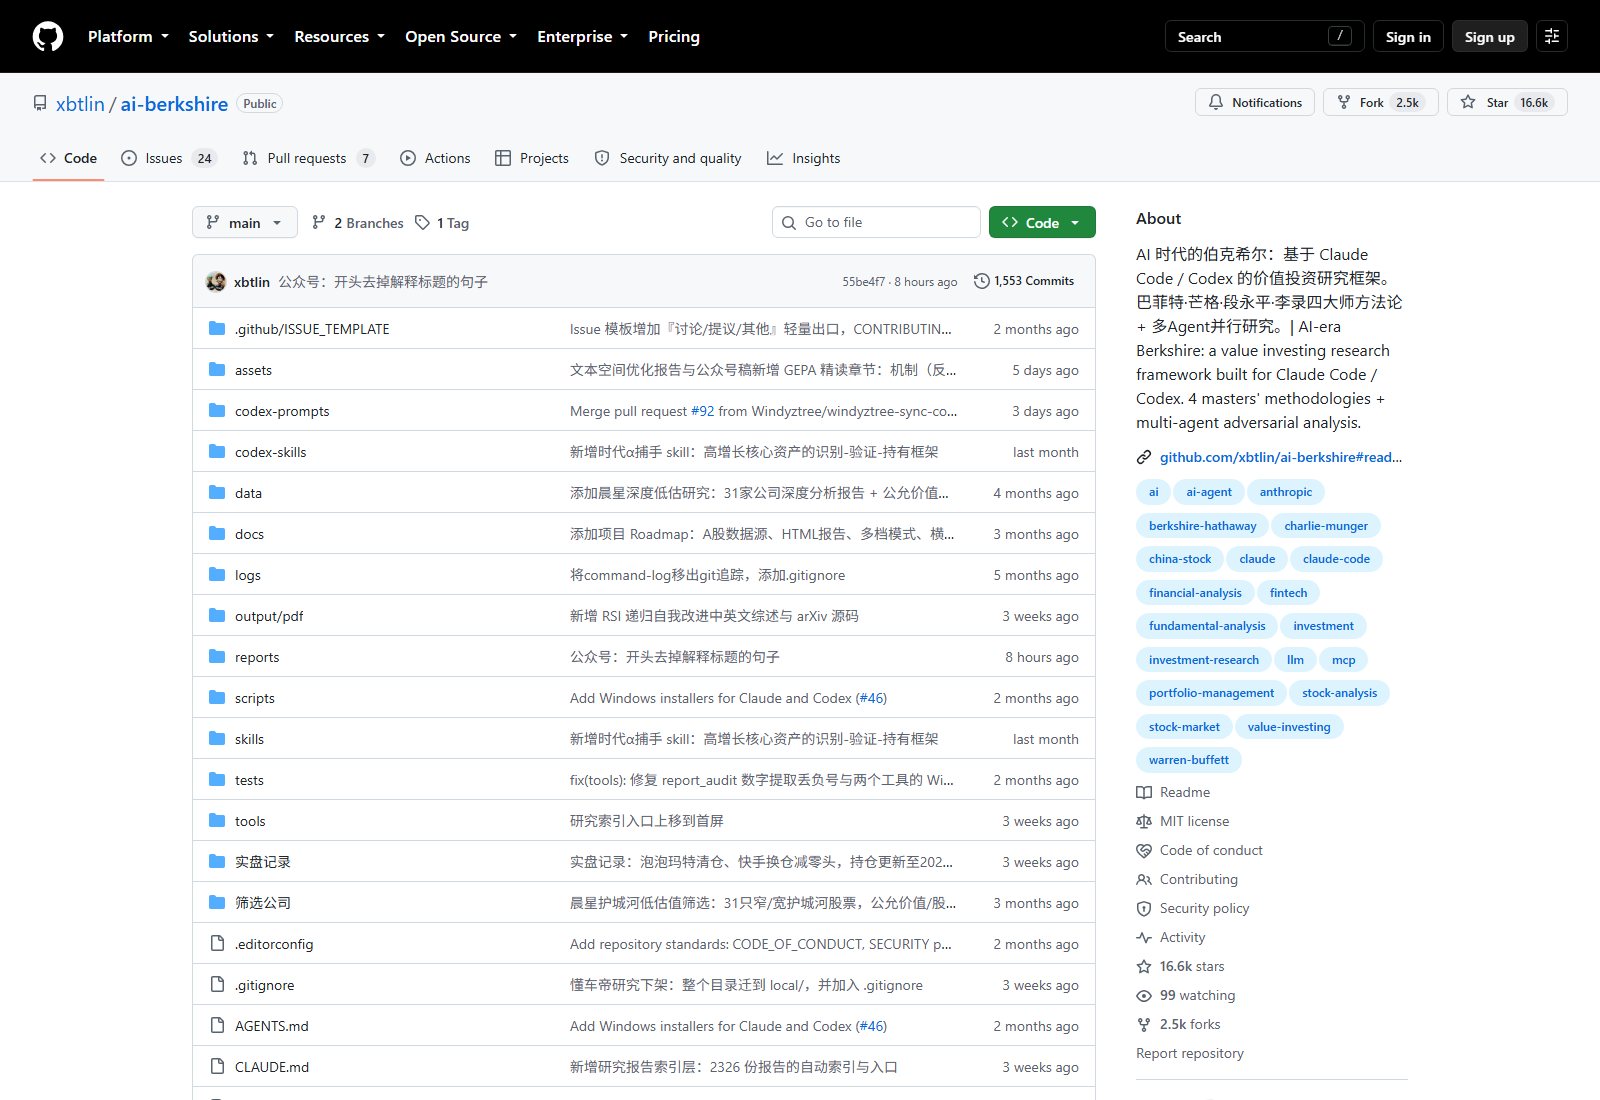
Star 约 16.6k · Fork 约 2.5k · MIT · 1,553 次提交(采集 2026-09-28,数字会随社区变化)
WHAT IT SOLVES
AI Berkshire 解决的到底是什么问题
| 它内置的机制 | 要挡住的毛病 | 官方给出的例子 | 本站证据等级 |
|---|---|---|---|
| 强制给结论,不打太极 | 两面讨好、回避判断 | 输出「通过 / 不通过 / 灰色地带」并带价格区间 | 官方确认(README) |
| 四大师视角对抗 | 单一分析视角的盲区 | 巴菲特说便宜、李录说十年不确定,冲突被保留 | 官方确认(README) |
| 信息丰富度评级 A/B/C | 把「资料多」误当「确定性高」 | 信息充裕的公司更容易趋同于市场共识 | 源码已核验 |
| 芒格式逆向检验 | 只列优点不列死法 | 强制写「什么情况下这家公司会死」 | 源码已核验 |
| 快速否决清单(8 条红线) | 用便宜估值掩盖治理问题 | 管理层诚信污点一票否决,不管多便宜 | 官方确认(README) |
| 多源交叉验证 + 精确十进制 | LLM 心算与单位错误 | 市值 = 股价 × 总股本,单位错一个零就翻车 | 本站实测 |
这张表把 README 的宣传语还原成「机制 → 病 → 例子」三列,方便你判断它是否解决了你真正在意的问题。
本板块依据 AI Berkshire 官方仓库 commit 55be4f7 与本站 2026-09-28 实测整理。
HOW IT WORKS
三层结构分别落在仓库的哪些目录
三层结构示意图(依据 commit 55be4f7 的真实目录推导,非官方架构图)。
| 层 | 官方定义 | 仓库中的真实位置 | 本站核到的数字 |
|---|---|---|---|
| Skill 层 | 把「你要做什么」抽象成明确入口 | skills/*.md | 21 个文件(README 标题写 20) |
| Agent 层 | Team Lead 并行调度四位大师视角 | 团队型 skill 的内部流程 | 轻量 skill 不走这一层,直连工具 |
| 工具层 | 精确计算、实时检索、报告抽检 | tools/*.py | 15 个文件,其中 12 个 Python |
| Codex 侧 | 由源文件生成,保持同一套 workflow | codex-skills/*/SKILL.md | 22 个目录(多一个 Codex 专用包) |
| 兼容层 | 可选的 slash prompt | codex-prompts/*.md | 21 个,与 skills 一一对应 |
| 报告层 | 研究产出 | reports/ | 3,018 个文件(README 横幅写 2377 份) |
「官方定义」列是 README 的意思,右两列是本站按 commit 55be4f7 实测的数字。两列不一致的地方在「事实与版本」页单独解释。
本板块依据 AI Berkshire 官方资料与本站实测输出整理,证据等级见事实与版本页。
CORE CAPABILITIES
21 个 Skill 覆盖的四类投研任务
深度研究(5 个)
对一家公司做全方位研究:investment-research 走七步框架,investment-team 起四个 Agent 并行,另有管理层纵深、未上市公司、长文系列三个专项。
财报与筛选(8 个)
财报精读只读一手资料(earnings-review);行业侧有产业链全景、漏斗筛选(全市场 → ≤10 家 → 3 家)、7 条硬指标去劣、瓶颈猎手、时代 α 捕手、买入前 Checklist。
持仓管理(5 个)
买后纪律:portfolio-review 管仓位与集中度,thesis-tracker 跟论文是否被证伪,thesis-drift 对比两份论文,news-pulse 做十分钟异动归因。
数据与写作(3 个)
financial-data 规定分市场双源取数与复权口径,dyp-ask 用段永平的方式思考,wechat-article 三 Agent 协作产出可发布文章。
单个 Skill 的「场景 → 输入 → 输出 → 成本 → 什么时候不要用」五列对照在 Skill 场景页。
本板块依据 AI Berkshire 官方仓库 commit 55be4f7 与本站 2026-09-28 实测整理。
SETUP AND ROUTE
三条路线的真实前置条件
| 路线 | 要准备什么 | 真实入口 | 本站实测状态 |
|---|---|---|---|
| Claude Code | Node.js + npm install -g @anthropic-ai/claude-code + git | Windows 运行 scripts\install-claude-commands.bat | 本机未安装客户端,未端到端执行 |
| Codex | Codex 客户端(npm / brew / 官方 PowerShell 脚本)+ git | Windows 运行 scripts\install-codex-skills.bat | 本机未安装客户端,未端到端执行 |
| 本机技能路线 | 本机技能 + 各数据源自己的授权 | 下载安装后在技能目录中使用 | 本机 29 个技能已逐个核对 SKILL.md |
| 自建取数脚本 | Python 3.11 即可,仅需标准库 | tools\ashare_data.py(A 股)等零依赖脚本 | 本机实测可运行,取数需外网 |
Windows 安装脚本会覆盖式写入 %USERPROFILE%\.claude\commands 或 %CODEX_HOME%\skills(同名子目录先删除再复制)。这一点官方 README 没写,来自脚本源码核对。
集成状态说明:本机技能路线与本项目无已证实集成。装成本机技能不会让你获得 AI Berkshire 的 Skill,两条路线只能做任务级对照。
本板块依据 AI Berkshire 官方资料与本站实测输出整理,证据等级见事实与版本页。
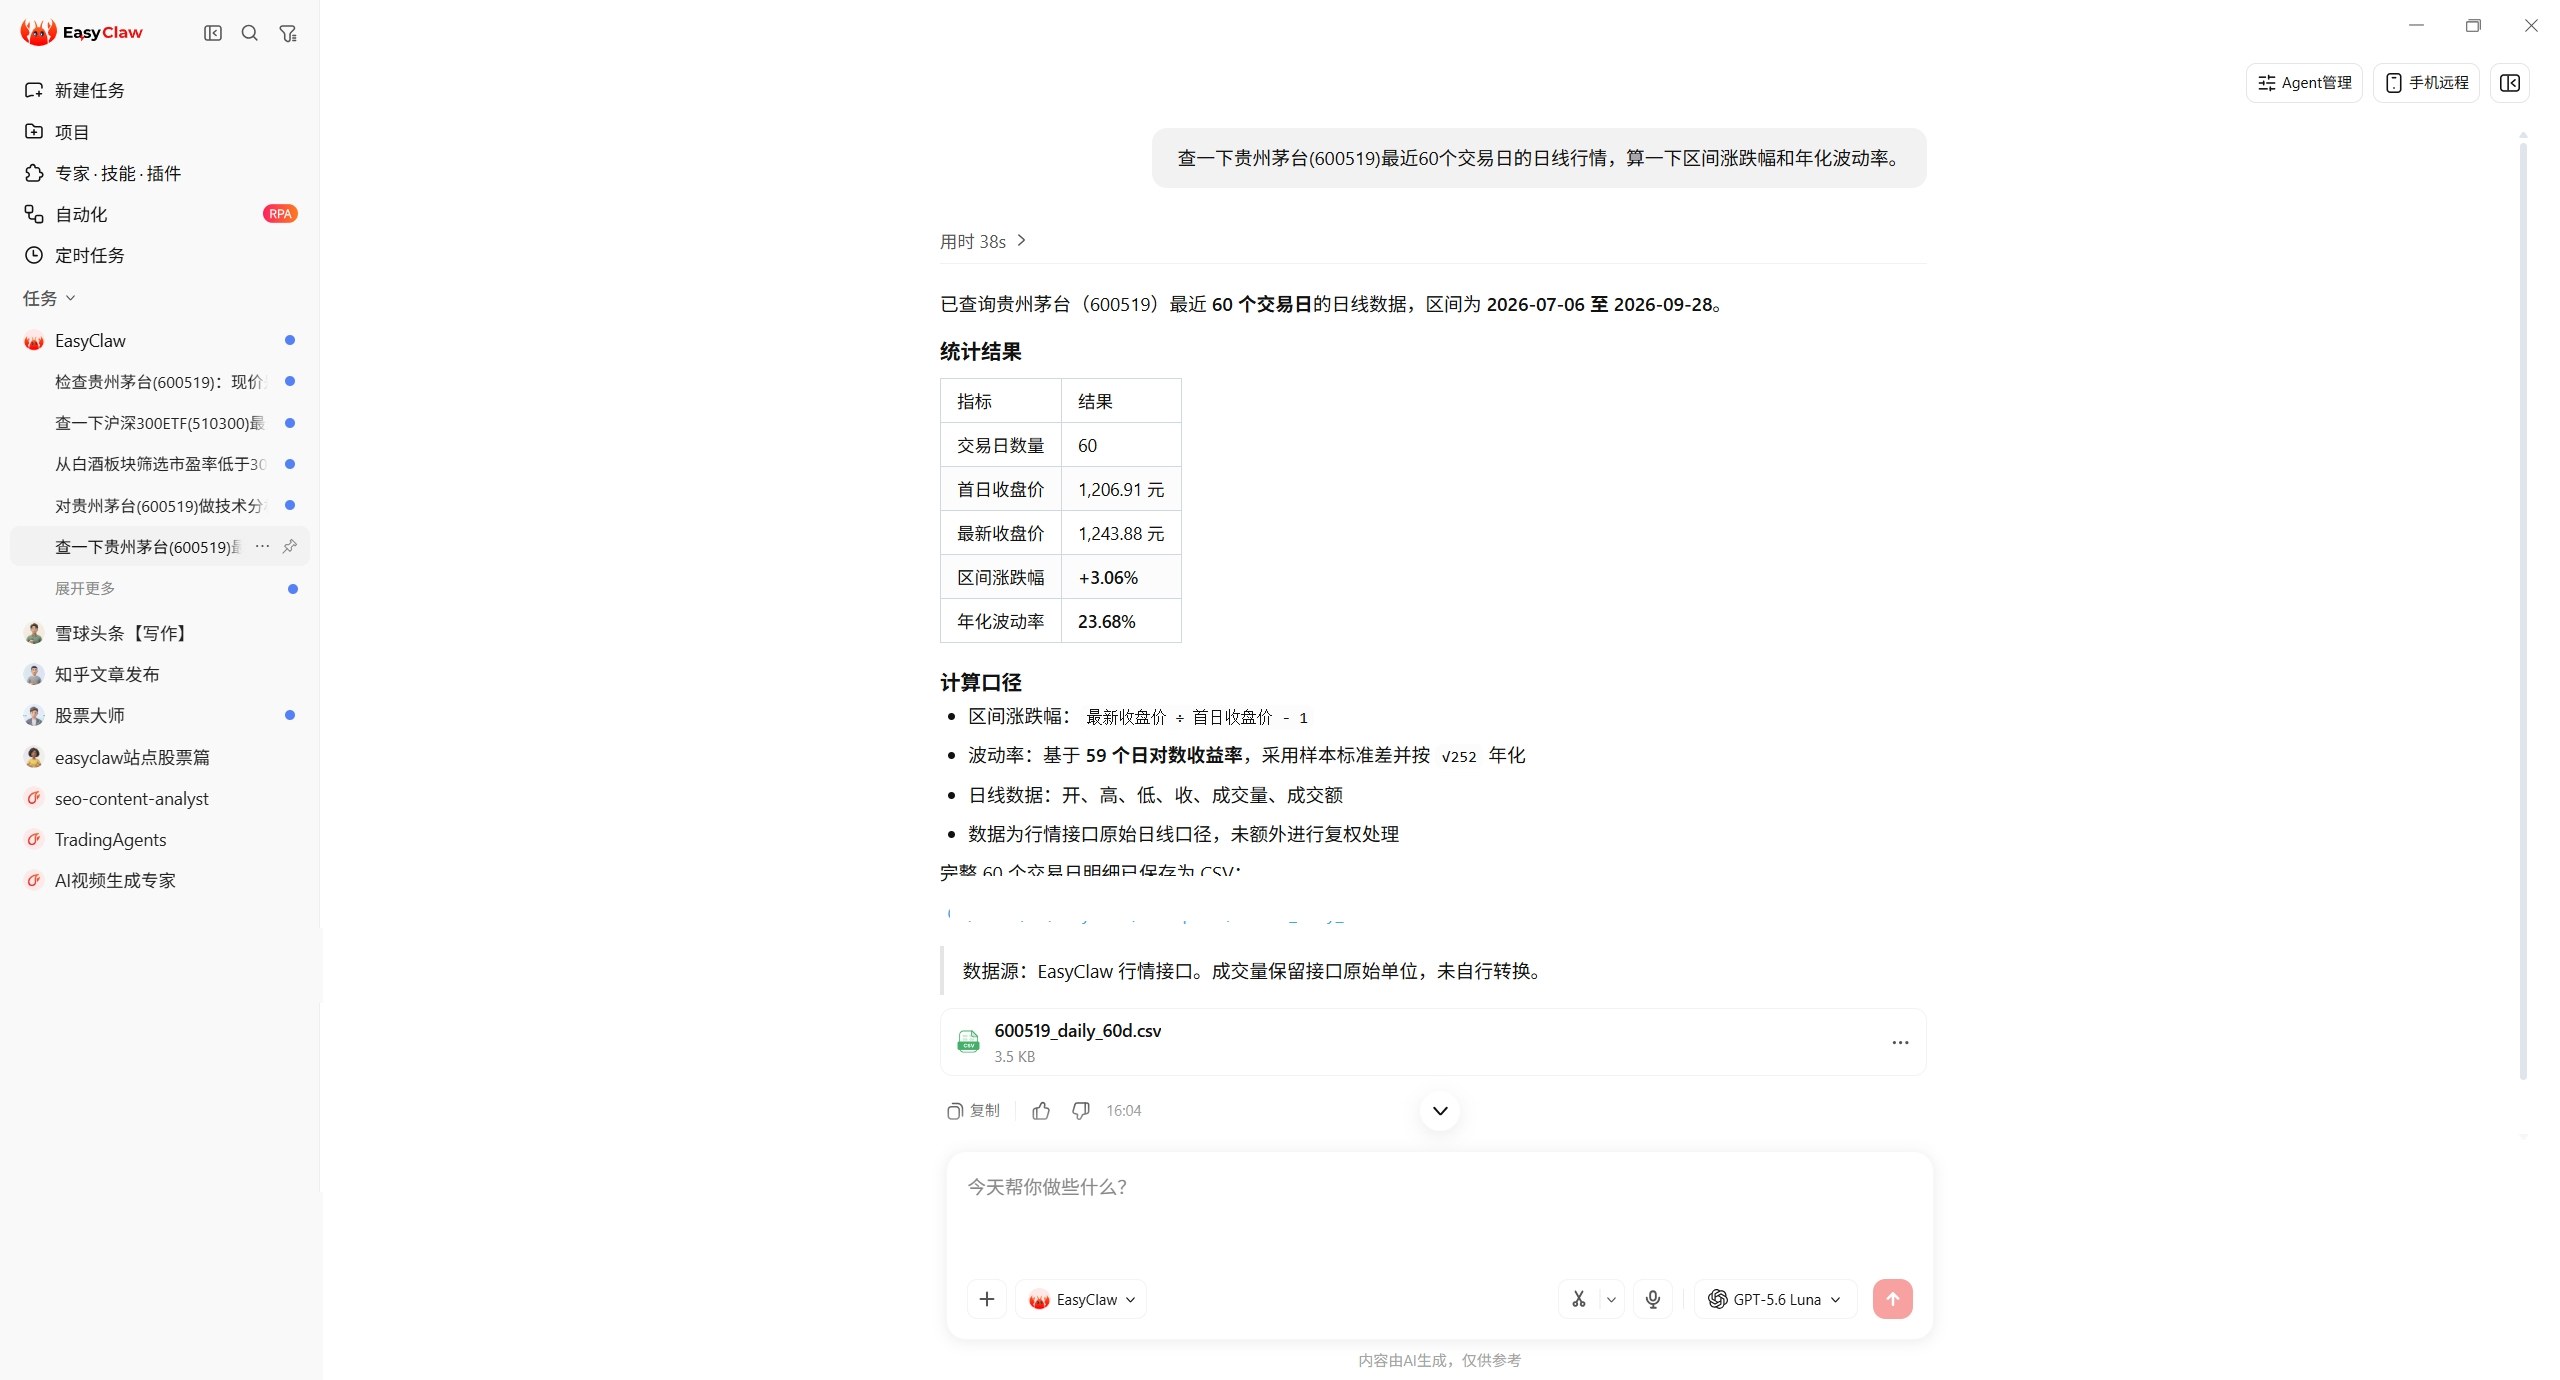
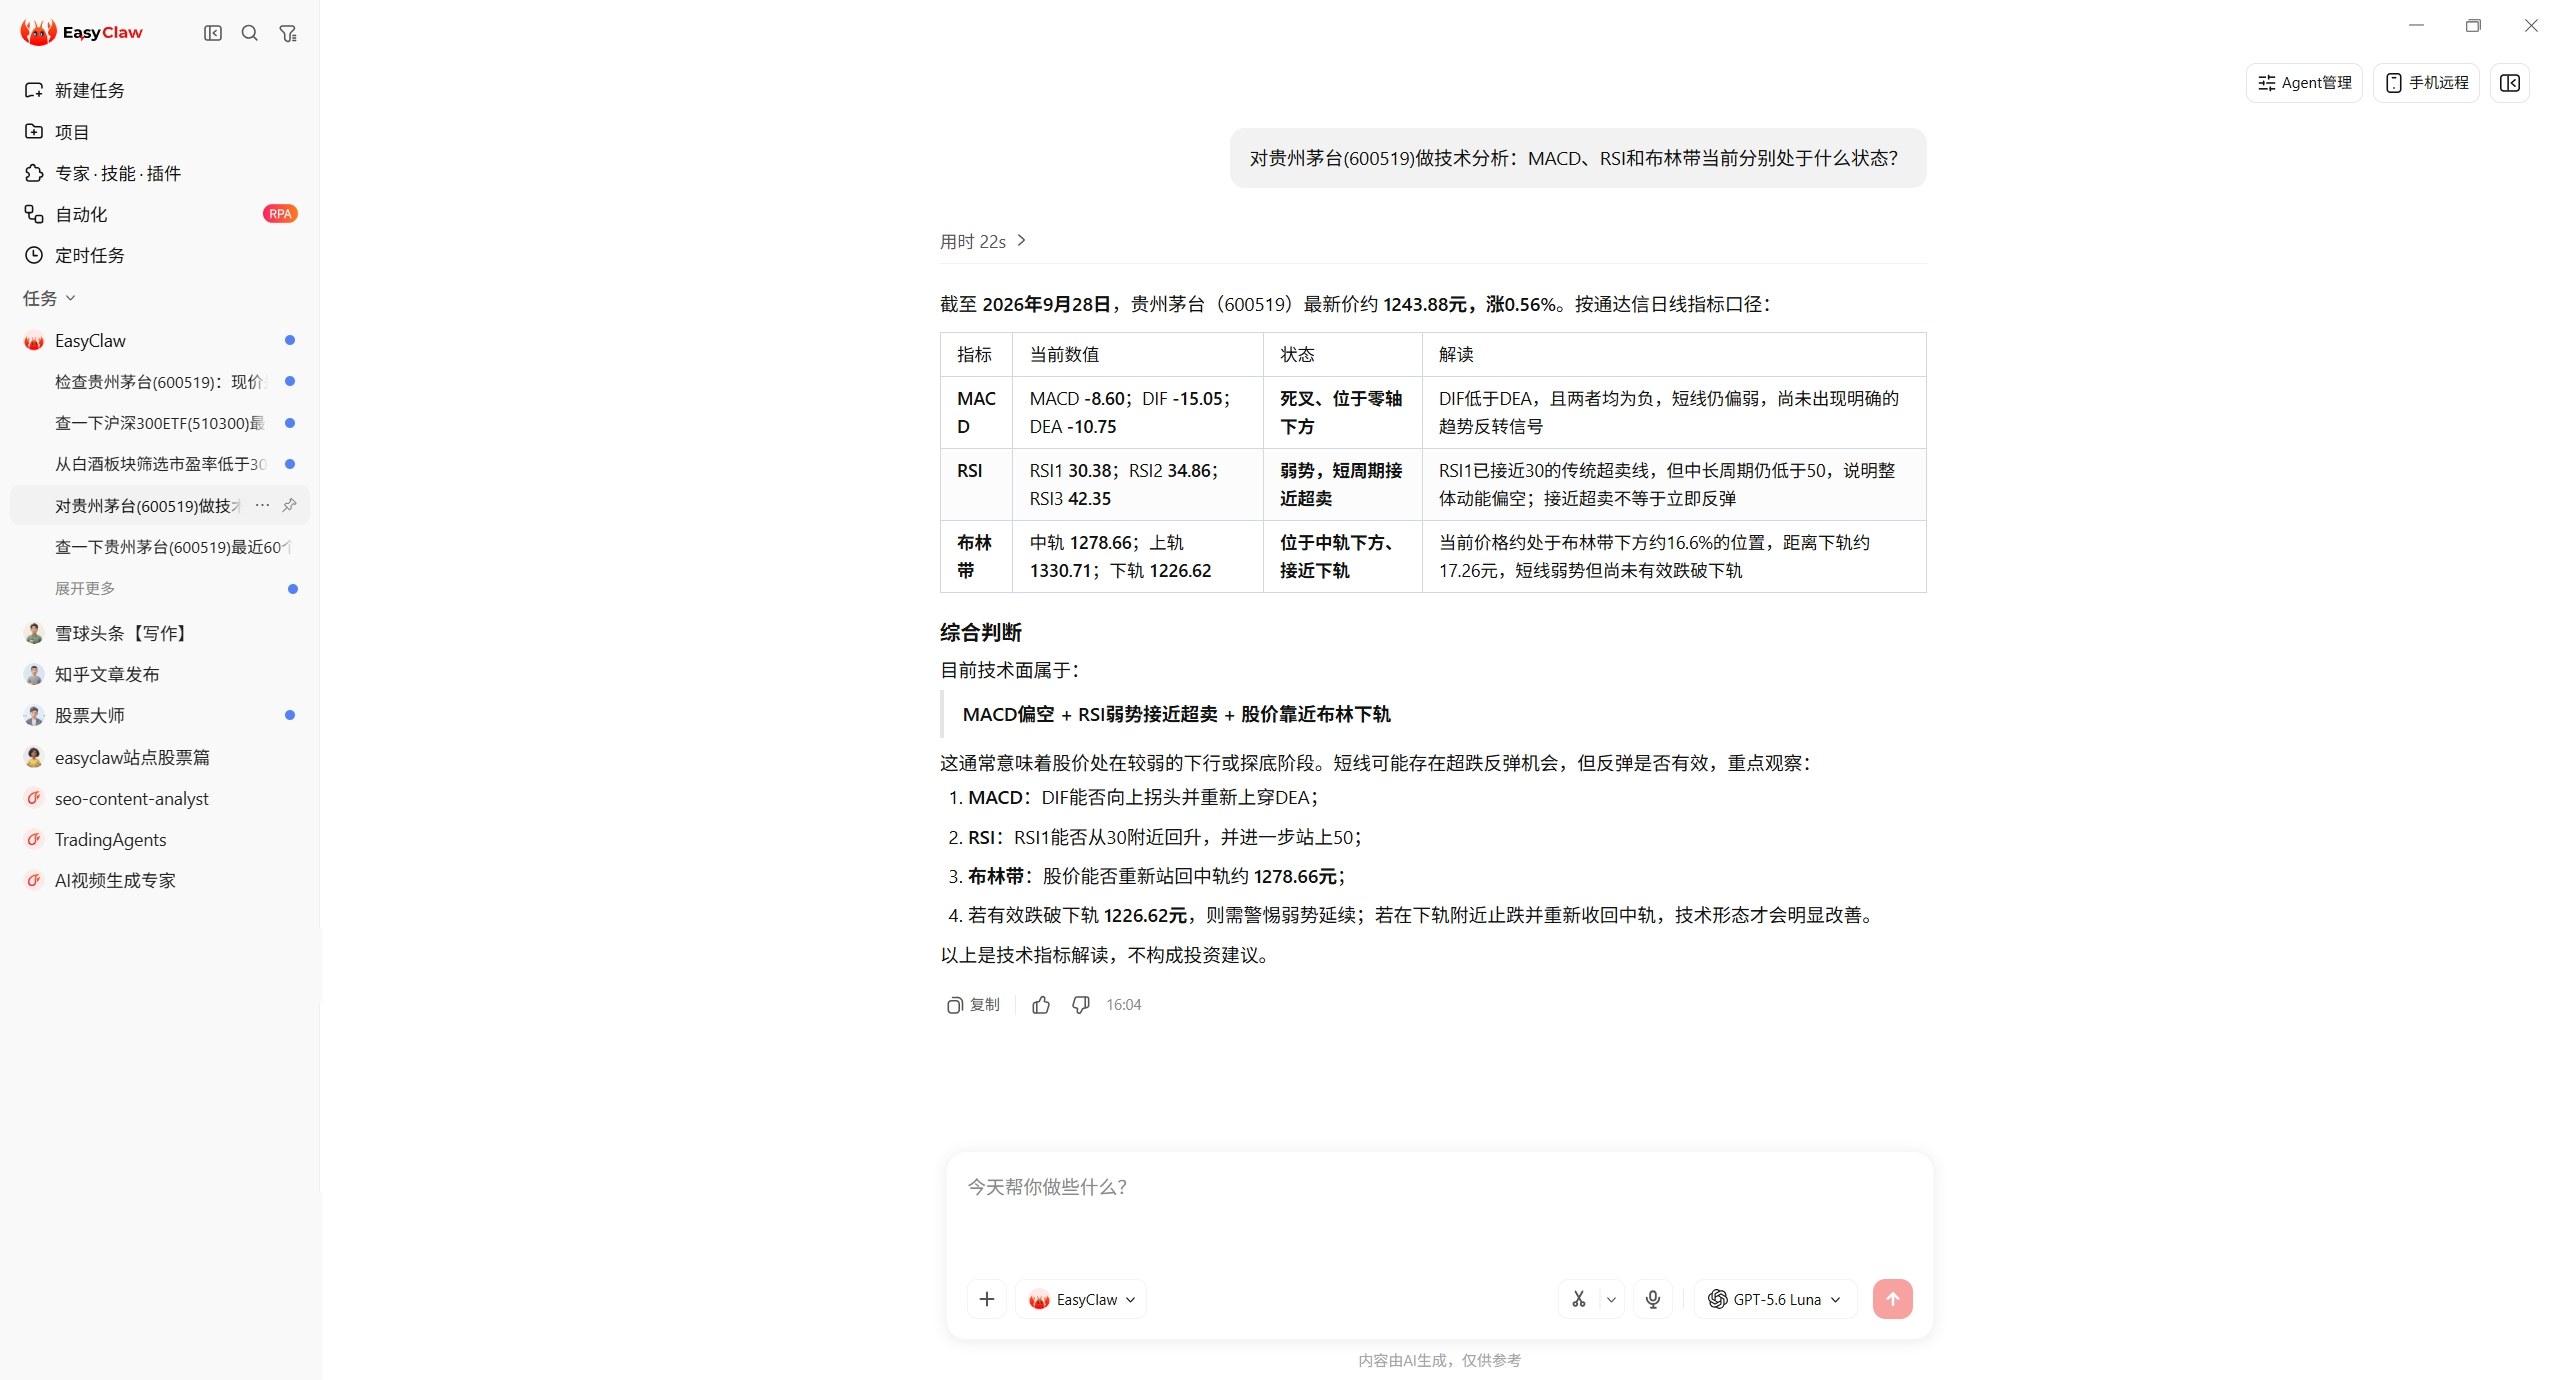
上面两张是本机真实运行截图(2026-09-28),不是效果图:提示词原文、耗时、返回表格都在图里,可以逐项核对。 请注意三件事。第一,它们证明的是本机技能路线能完成同类取数与技术面任务,不证明 AI Berkshire 的 Skill 已被对方调用——两者无已证实集成,装任一产品都不会自动获得另一方的能力,这也是本站全站标注该声明的原因。 第二,两张图里的数据只代表 2026-09-28 这一天的市场状态,行情会变,截图不会。 第三,第一张图明确写了「未做复权处理」——这正是本站「报告审计」页反复强调的口径问题:同一只股票,用不复权与前复权算出来的区间涨跌幅可以差出好几个百分点,报告里不写清口径就无法复核。 更完整的对照在做同一类任务时两条路线的差异,见对比页;每一步的命令与预期输出见任务教程页。
FIT CHECK
它适合谁,又明确不适合谁
| 如果你是… | 合适程度 | 原因 | 更该先看哪一页 |
|---|---|---|---|
| 已用 Claude Code / Codex,想要结构化投研流程 | 合适 | Skill 就是为这两个客户端写的,装完即可调用 | 开始上手 |
| 想要一套可复现、能被质疑的研究底稿 | 合适 | 八步框架 + 抽检准出就是为「可复核」设计的 | 报告审计 |
| 主要研究 A 股、希望取数全自动 | 部分合适 | 规范里 A 股主源是东方财富 + 巨潮,属手工访问而非自动接口 | AI 投研边界 |
| 完全不想装客户端、也不想配环境 | 不合适 | 项目没有网页版,也没有 pip 包可装 | 对比 |
| 想要能直接下单或给买卖信号的系统 | 明确不合适 | 只做研究不含交易执行,官方也写明不构成投资建议 | AI 投研边界 |
| 想要能读实时行情的数据终端 | 明确不合适 | 仓库不含行情数据,且没有 WebUI / REST API | 事实与版本 |
「部分合适」与两组「明确不合适」是本站按真实文件树与工具行为补的判断,官方 README 未做这类否定式说明——而这类「它不适合谁」恰恰是最缺、最有用的信息。
本板块依据 AI Berkshire 官方仓库 commit 55be4f7 与本站 2026-09-28 实测整理。
EVIDENCE SNAPSHOT
本站的核验口径:四级证据
report_audit.py 容差常量是 1%,.bat 会覆盖式安装。四级证据的判定标准,以及本站实测到的「上游文档与实现不一致」之处,都在 事实与版本页列出。
本板块依据 AI Berkshire 官方资料与本站实测输出整理,证据等级见事实与版本页。
WORKFLOW
从选标的到准出的一条完整链路
AI Berkshire 的一条完整投研链路
把上面的机制串成一条可复现的链路,每一步都能在本站其它页面找到对应的核对方法。
先确认这家公司属于 A/B/C 哪一级。信息充裕的公司更容易趋同于市场共识,信息稀薄的公司需要先做一手验证。
预期输出:报告开头必须出现信息丰富度评级与 AI 研究局限性声明。
python tools\financial_rigor.py cross-validate --field revenue --values '{"macrotrends": 7518, "stockanalysis": 7500}' --unit 亿美股用 macrotrends 主 + stockanalysis 副;港股用 aastocks 主 + macrotrends ADR 副;A 股用东方财富主 + 巨潮资讯副。偏差 >5% 必须回去查原始财报。
预期输出:本机实测输出「所有来源偏差 ≤ 2.0%, 数据一致」(注意工具默认容差是 2.0%,与规范的 1% 分档不一致)。
数据收集 → 生意本质 → 护城河 → 逆向思考 → 管理层 → 行业与文明趋势 → 估值与安全边际 → 综合决策备忘录。
预期输出:每一步末尾要出现对应大师的追问;反方证据不能被写成一句免责声明。
python tools\financial_rigor.py verify-market-cap --price 510 --shares 9.11e9 --reported 4.65e12 --currency HKD市值 = 股价 × 总股本。银行、保险等特殊行业的 PB 与 PE 要另算。
预期输出:本机实测输出「计算市值: 4.6461e+12 HKD」「偏差: 0.08%」「✅ 市值数据一致」。
python tools\report_audit.py extract --report <报告路径> --seed 42 --dry-run抽样提取数据点后人工回填两个来源,再跑 verdict 判决。含十年折现估值的报告还要再跑一次 terminal_value audit。
预期输出:本机实测:8 行×5 列的表格得到「总提取数据点: 40」「抽样: 6 个」;verdict 退出码 0 = 准出、1 = 打回。
至少记下五项:标的与市场、数据截止日、来源与口径、命令与参数、结论与置信度。缺了这几项,三个月后没人能重跑同一份研究,更没法判断是数据变了还是判断变了。本站的每一次实测输出都按这个格式留档在证据目录里。
预期输出:档案里能直接看到命令、退出码与原始输出三段。
用 thesis-tracker 把当季新披露的一手资料与原始研究论文逐条比对,再用 thesis-drift 区分「事实变了」「估值假设变了」「只是措辞变了」三种情况。这一步顺序不能颠倒:先记录发生了什么,再决定要不要改判断,否则容易先有结论后找理由。
预期输出:复盘记录里每一项变化都能指回一份公告或一份财报。
报告结尾必须分开写「AI 分析置信度」与「投资确定性」两件事:前者说的是证据够不够、口径清不清楚;后者说的是这笔生意本身有多确定。两者不能混成一句「整体看好」,也不能用确定性掩盖证据不足。
预期输出:结尾出现两段独立表述,且各带一条可核查依据。
本板块依据 AI Berkshire 官方仓库 commit 55be4f7 与本站 2026-09-28 实测整理。
FAQ
AI Berkshire 常见问题
AI Berkshire 是什么?一句话说清。
它是一套同时兼容 Claude Code 与 Codex 的投资研究 Skill 合集,把巴菲特、芒格、段永平、李录四位大师的方法论拆成 21 个可调用入口,并配一层精确计算与报告抽检工具,以 MIT 许可开源在 GitHub 的 xbtlin/ai-berkshire。它是研究工作流,不是「AI 炒股」工具,也不含交易执行能力。
它是免费的吗?
仓库本身 MIT 许可、免费、允许商用(GitHub API 的 license 字段为 MIT,仓库根有 LICENSE 文件)。但要注意两处额外成本:一是你必须自备 Claude Code 或 Codex 客户端;二是深度投研类 Skill 会进行多轮检索与交叉验证,token 消耗较高,官方在 README 里明确建议「优先调整 workflow,而不是期待完整深度研究变得便宜」。客户端与模型的费用不在本仓库范围内,具体价格以各官方定价页为准。
到底有 20 个还是 21 个 Skill?
按 commit 55be4f7 实测:skills/ 目录下有 21 个 .md 文件,而 README 的小标题写的是「Skills 一览(20个)」,同一张表实际列了 21 行。另外 codex-skills/ 有 22 个目录,多出的那个是 Codex 专用包,不计入这 21 个。这正是很多第三方文章写 16、18、20 个的原因——不同时间点抄了不同段落,也没有人去数文件。本站以文件实测为准。
装了 EasyClaw 就能用 AI Berkshire 吗?
不能,两者无已证实集成。它是另一套产品,它的技能目录里没有 AI Berkshire 的 Skill;反过来本站也没有验证过把 AI Berkshire 装进它的路径。本站对比页做的是任务级对照:同一个「研究一家公司」的任务,两条路线各自用什么、需要什么授权。我们不会把这种对照写成「替代安装」。
我该先跑哪个 Skill?
不建议一上来就 /investment-team。按成本从低到高:先用 /investment-checklist(六关快速筛选,10 分钟判断值不值得深入),再用 /quality-screen 或 /news-pulse 这类轻量入口,只有当结果值得继续深入时,才跑 /investment-research 或 /investment-team。这是官方给出的成本控制路径,具体步骤见任务教程页。