conda + pip→配 API keys→跑 notebook→读研报
灵活度高,但环境、多个数据源 key 与模型调用都要自己维护;流程本身不保证结果正确,数字仍要自己核对。
两条独立路线对比
同一个「金融研究」目标,两条准备成本完全不同的路线:FinRobot 要先选版本、装 uv 或 conda、配若干 API key,才能得到一份带溯源的研报;免部署路线装好客户端就能一句话提问。本页不只比功能,还把两条路线各自会在哪里卡住、以及什么情况下根本不该选 FinRobot 一起写清楚——两条路线互相独立,没有已证实集成关系。
从版本形态、准备成本、数据源、市场覆盖到估值能力逐项对比。判断列写的是「什么场景下这一项才是决定性的」,避免只比功能清单。先提醒一件事:FinRobot 自建路线不是一个单一形态——V2 是官方认定的生产系统(32 个纯 Python 算子 + 6 个审计算子 + 7 条流水线 + 13 章研报制品),V1 是自托管的研报 Web 应用,V0 是教学代码且官方明说没有确定性计算层与溯源跟踪。所以「自建」这个词对不同人意味着完全不同的准备成本。如果你只想要结论:以 A 股研究为主、不写代码,先从免部署路线开始;要固定环境、要交付他人复核,再考虑自建,并且直接按 V2 起步。
| 维度 | 自建路线 | 本机技能路线(免部署) | 适用场景 | 注意点 / 什么时候不适用 |
|---|---|---|---|---|
| 版本与形态 | 仓库里四代并存:V2 生产系统(桌面/浏览器/CLI)、V1 Web 应用、V0 教学代码、V3 开发中(无公开代码) | 单一形态,装好客户端即用 | 先确认你要的操作落在哪一代的文档里 | Web 教程大量停留在 V0 时代;用 PyPI 的 pip install finrobot 装不到 V2 |
| 准备成本 | 按版本分:V2 要 uv + Node 20+(或 macOS 桌面版);V1 要 FMP + OpenAI 两个 key;V0 要 conda Python 3.10/3.11 并在仓库根源码安装 | 安装客户端即可,无需配置环境 | 只需要偶尔做一次研究时,准备成本占比最高 | 自建路线的一次性准备时间无法省略,key 申请还要等审核 |
| 使用方式 | 跑 notebook / 写脚本 / 改智能体编排 | 一句话提问,结果直接返回 | 任务形态固定、想要可改可调时选自建 | 免部署路线的自由度低于自己写管道,别指望改内部逻辑 |
| 数据源 | FinnHub / FMP / SEC EDGAR / yfinance / finnlp | 本机已核验的财经数据类 Skill(akshare-finance、tushare-finance、yahoo-finance-github 等) | 数据源决定能研究什么,先按数据源选路线 | 两边数据源不同,同一指标口径可能不一致,别交叉当同一份数据用 |
| 市场覆盖 | 官方数据源以美股为主,A 股需自行适配 | 覆盖 A 股 / 港股 / 美股的 Skill 视具体技能而定 | 以 A 股研究为主时,免部署路线通常更省事 | 自建路线做 A 股要自己接数据源,不是改个参数就行 |
| 估值与研报 | DCF / DDM / LBO / WACC 等由纯 Python 算子确定性计算,模型负责叙述 | fp-dcf 等 Skill 可一句话发起 DCF 估值 | 要求数字可回溯、可复核时,先确认数字由谁算出 | 「有 DCF 输出」不等于口径一致;两边的假设输入都要自己核对 |
| 技术门槛 | 需要 Python 基础,能读代码与报错 | 不需要编程,但要会描述研究任务 | 不会写代码但要求结果时选免部署 | 免部署路线把复杂度转移到「怎么问清楚」,问题含糊时结果也会含糊 |
| 可复现性 | 高:环境、参数、数据版本都能固定下来 | 取决于技能与账号状态,复现需要记录提问与返回 | 要交付给他人复核、要跑第二遍验证时选自建 | 自建路线要额外维护 requirements / 镜像,否则半年后可能跑不动 |
| 维护与责任 | 环境、依赖、key 额度、模型变更都由自己维护 | 技能与模型由服务方维护,但要接受其能力边界 | 长期跑的生产管道选自建,临时研究选免部署 | 两者都不承诺收益,输出都是研究结果,不构成投资建议 |
这张表不是比功能,而是比「出问题时的表现」——很多人在真正开始做研究之前,卡的都是这些环节。左列是可执行动作,右列告诉你先验证什么,别等整套流程搭好才发现卡在起步环节。
| 环节 | 自建路线 | 本机技能路线 | 卡住的典型表现 | 先做哪一步验证 |
|---|---|---|---|---|
| 环境 | V2 需要 uv 与 Node 20+;V0 需要 conda 环境与指定 Python 版本 | 安装客户端,无环境步骤 | 环境装了一半、包冲突、换了机器又要重来 | 先用一条最小命令确认解释器与包都在同一环境 |
| 版本错配(实测) | 照旧教程执行 pip install finrobot:装到的是 2024-06-17 的 0.1.5,且零依赖,import finrobot 成功但一调用就报缺 finnhub、autogen | 不涉及 | 以为「包装上了」就能用,实际从未拥有 V2 的算子与流水线 | 先确认版本:V2 走 uv sync,V0 走仓库根 pip install -e . |
| 本地服务与端口(实测) | 浏览器模式由 dev.sh 拉起两个进程:Vite :5173 与 FastAPI :8321,且脚本会先杀掉占用这两个端口的进程(开着 FinRobot.app 也会被杀);浏览器模式下本地 API 无鉴权,同机其它进程可访问含密钥设置的接口 | 不涉及 | 端口被占导致启动失败,或误以为本地服务只有自己能用 | 启动前先确认两个端口空闲;共享机器优先用桌面 App |
| 密钥与授权 | V2 在 Settings 页写入系统钥匙串;V1 需要 config.ini 里的 FMP 与 OpenAI key;V0 需要两个配置文件(OAI_CONFIG_LIST + config_api_keys) | 由客户端侧统一处理,用户不接触 key | 某个 key 缺了不报错,只是结果为空 | 逐源做一次最小取数,看是否真的返回数据 |
| 成本 | 模型调用与数据源额度按量消耗 | 按服务方规则消耗,不需自己配支付 | 跑到一半额度用尽,任务中断且难判断原因 | 先用最小任务跑一轮,观察消耗速度再放大 |
| 出错定位 | 要自己看日志、区分是环境、权限还是数据问题 | 出错信息由客户端返回,但内部细节不暴露 | 把「数据没取到」当成「模型不行」,方向找错 | 先确认数据层是否有返回,再怀疑模型层 |
| 结果粒度 | 取决于你写的管道,可以细到单条中间结果 | 通常直接给结论性输出 | 想要中间数据却拿不到,只能重做一遍 | 先看输出里有没有可核对的原始字段 |
| 可复现 | 环境固定后结果可重跑 | 需要自己记录提问与返回 | 过了几天再问,结果对不上又说不清差在哪 | 把提问原文与返回同时留存,形成最小记录 |
| 维护责任 | 全在自己:依赖升级、模型下线、key 轮换 | 在服务方,用户接受其能力边界 | 依赖某一版本,升级后旧脚本跑不通 | 把环境版本写进文档,别只留在本机 |
官方文档通常只写「需要哪些 key」,从不给一张总账单。下面把成本拆成可以逐项确认的部分;具体价格与免费额度一律以各家官方定价页为准,本站不给数字。建议先用一个最小任务跑一轮,把消耗速度弄清楚再放大。
| 成本项 | 自建路线 | 本机技能路线 | 什么时候会失控 | 怎么控制 |
|---|---|---|---|---|
| 软件本体 | Apache-2.0 开源,无授权费 | 客户端本身免费下载安装 | 几乎不会在这项上花钱 | 先确认许可条款再谈其它成本 |
| 模型调用 | 需要自备模型 API key,按消耗计费 | 由客户端侧承担,用户不单独配模型 key | 把大量文本反复喂给模型、循环重试时 | 先用小范围任务试一轮,再决定是否放大 |
| 数据源 | FinnHub / FMP 等需申请 key,是否付费档以官方为准;yfinance 走公开接口 | 数据由内置技能提供,用户不单独付费 | 同一份数据反复拉取、或误用到付费档接口 | 优先用免费可得的数据源跑通流程 |
| 环境与依赖维护 | 时间成本为主:装环境、修依赖、换机器重来 | 几乎没有这项 | 把自建环境当一次性投入,忽略后续维护 | 把环境写进版本化文档,避免重复开荒 |
| 学习与调试 | 要理解四层结构与智能体编排才能改得动 | 主要是学习「怎么把问题问清楚」 | 用自建路线解决本可以一句话解决的问题 | 先判断任务是否真的需要自建 |
| 试错成本 | 每次试错都要重跑环境与数据链路 | 改一句提问即可重试 | 在自建路线上反复试参数,时间被大量消耗 | 把探索阶段放在免部署路线上先定方向 |
以下为本机技能目录已核验的既有路线,独立于 FinRobot。清单只说明「本机目录可见」,不代表已安装成功、也不代表已完成授权或运行验证。
| 本机技能 | 对应的自建路线能力 | 你什么时候会用到 | 注意点 |
|---|---|---|---|
| quant-analyst-skill-v1.0.0 | 量化分析与回测方法论 | 需要成体系的量化研究结论时 | 输出为研究方法参考,不是可交易信号 |
| a-stock-analysis | A 股深度分析(自建路线需自行适配) | 研究 A 股公司基本面与走势时 | A 股数据口径与美股不同,别直接套用美股结论 |
| fp-dcf | DCF 估值(对应自建路线的确定性计算) | 需要快速得到一份估值框架时 | 假设输入要自己核对,估值不等于目标价 |
| stock-technical-mastery | 技术分析与形态识别 | 做 K 线、指标层面的快速判断时 | 技术指标不预测未来,只描述历史 |
| akshare-finance / tushare-finance / yahoo-finance-github | 财经数据获取(对应自建路线的数据源层) | 需要行情、财报等基础数据时 | 各技能覆盖市场不同,取数前先确认市场 |
| tonghuashun-research-assistant | 研报检索与资料整理 | 需要二手资料与市场共识时 | 研报观点属于他人结论,需自行交叉验证 |
| iwencai / futuapi / mx-data / mx-select-stock | 选股、行情与条件筛选 | 按条件初筛一批标的时 | 筛选结果依赖条件口径,条件写错会静默返回空 |
| chart-image | 图表生成(对应自建路线里的研报配图) | 需要把数据画成图放进结论时 | 图只是呈现方式,口径仍要按数据源核对 |
| (部分数据类技能需自备 key 或特定环境) | — | 需要更完整的数据覆盖时 | 清单只说明目录可见,不代表已授权或已跑通 |
以下为本机客户端的实际使用截图:资金流向与形态识别,均为一句话发起。图片已等比缩小展示,点击左右箭头翻页。
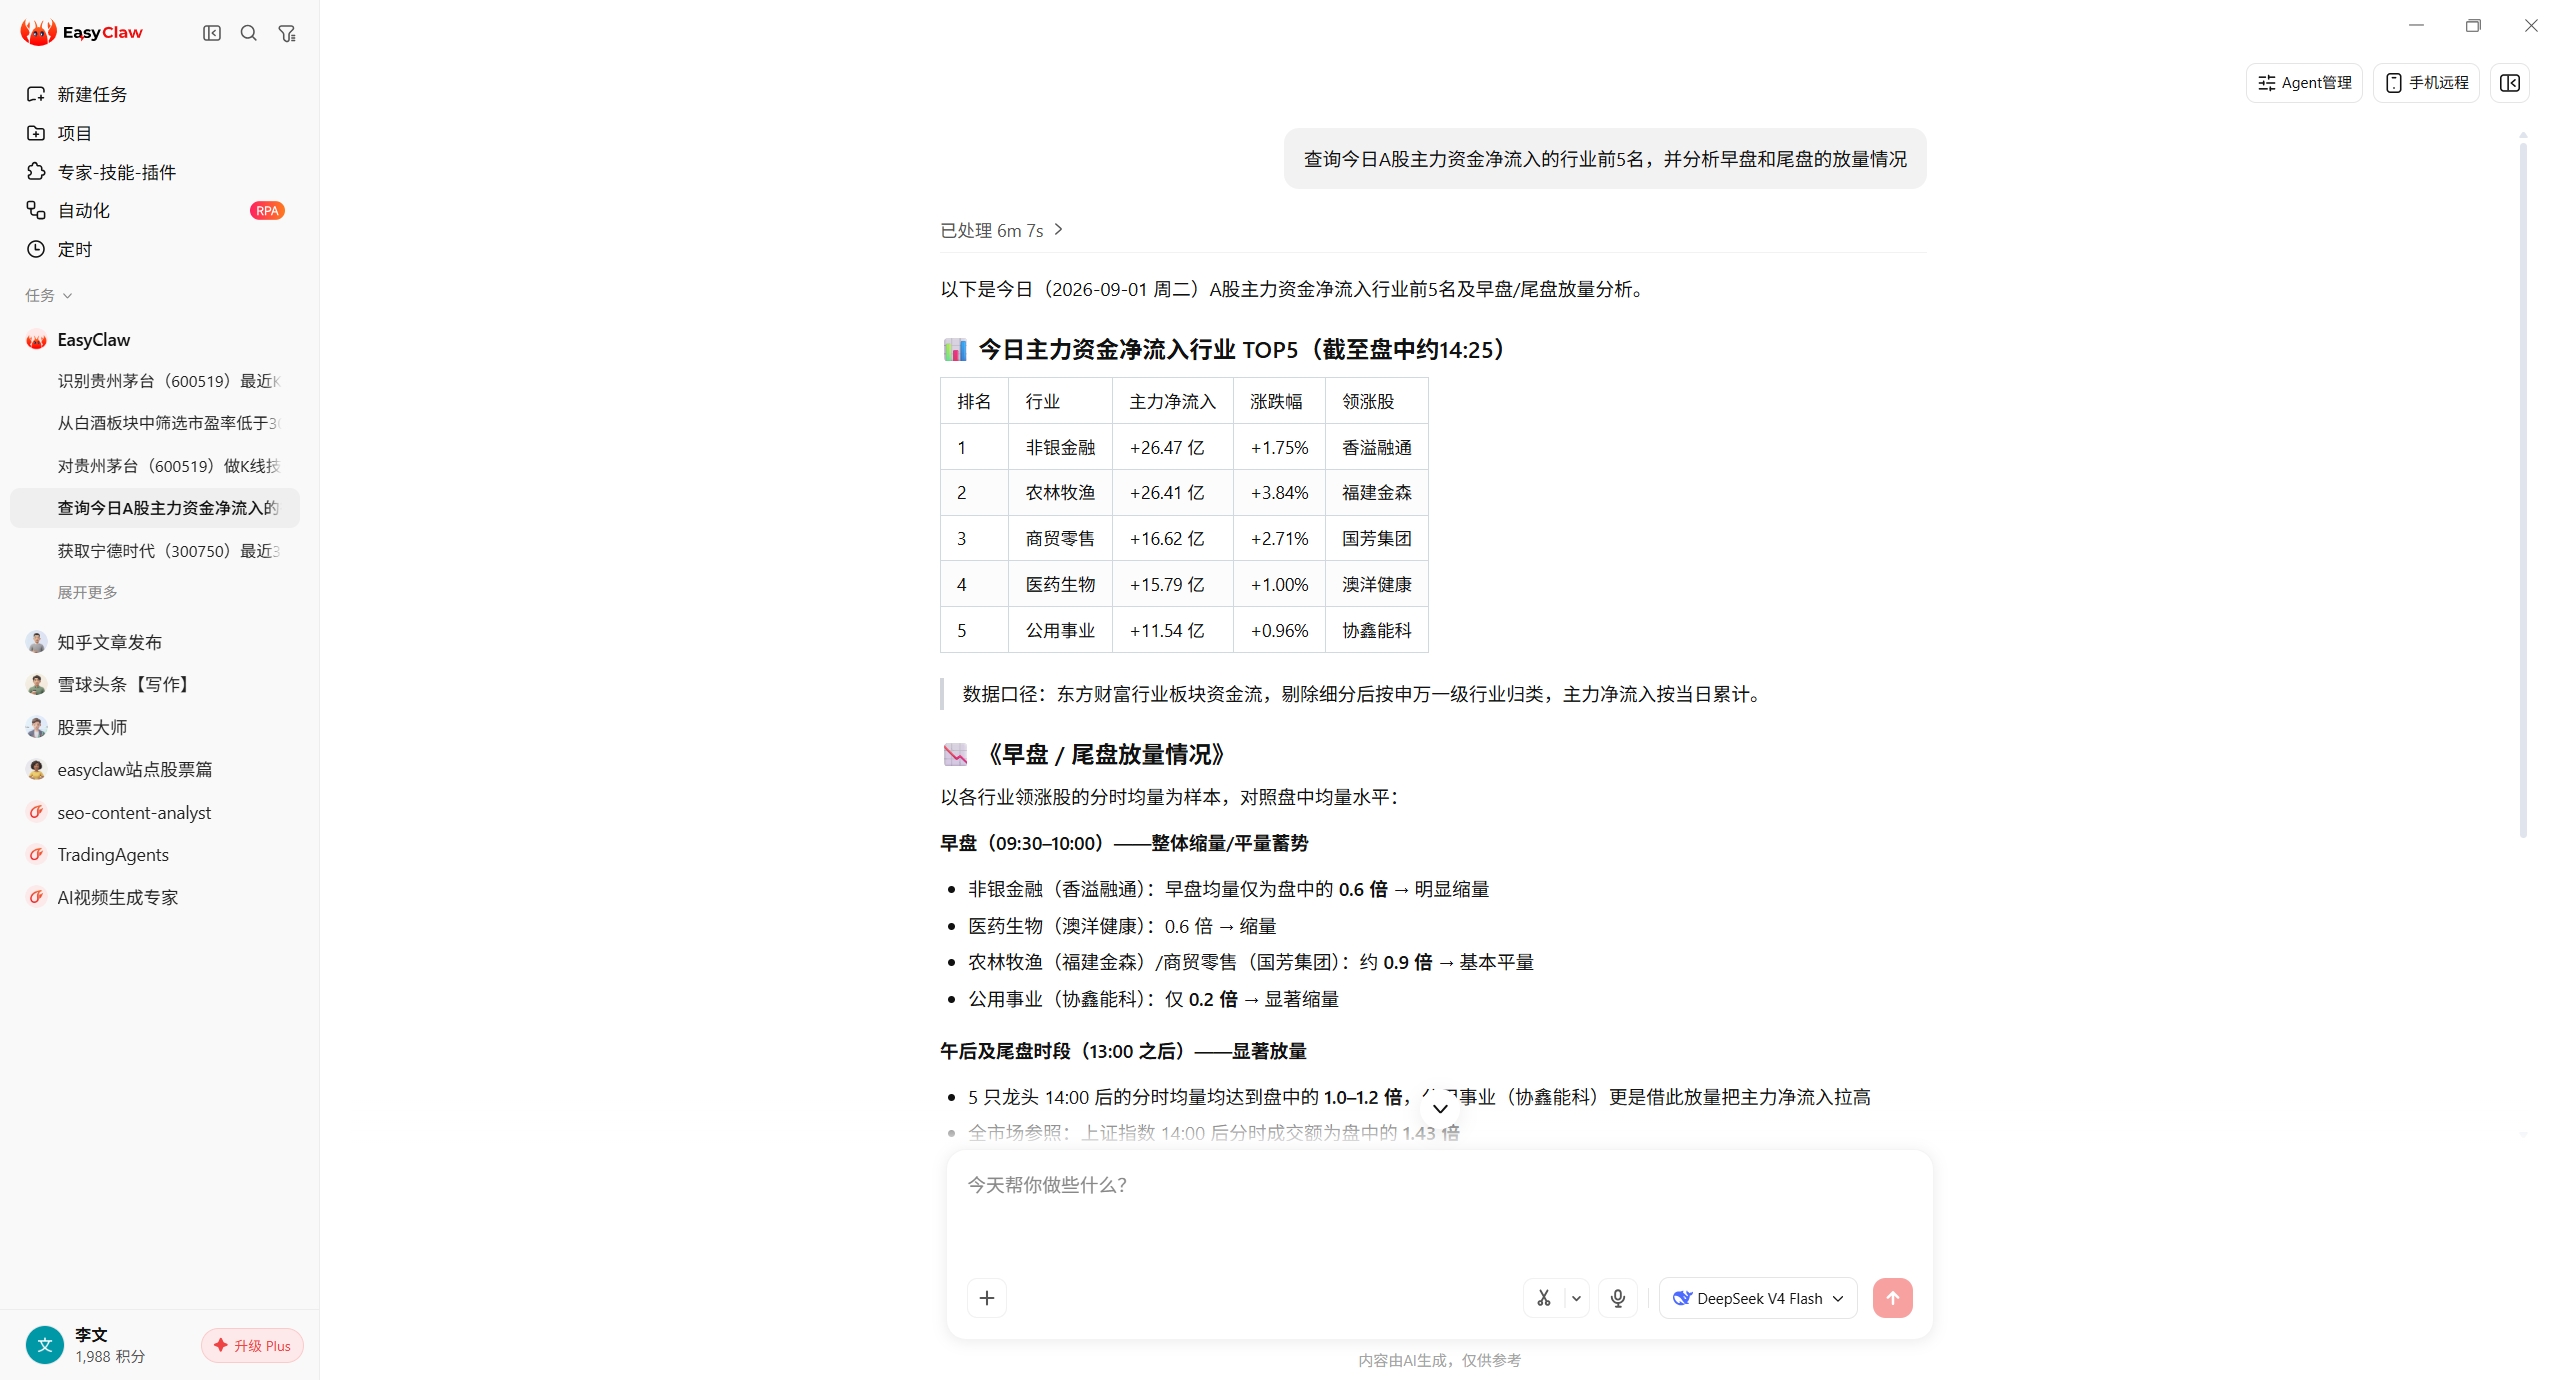
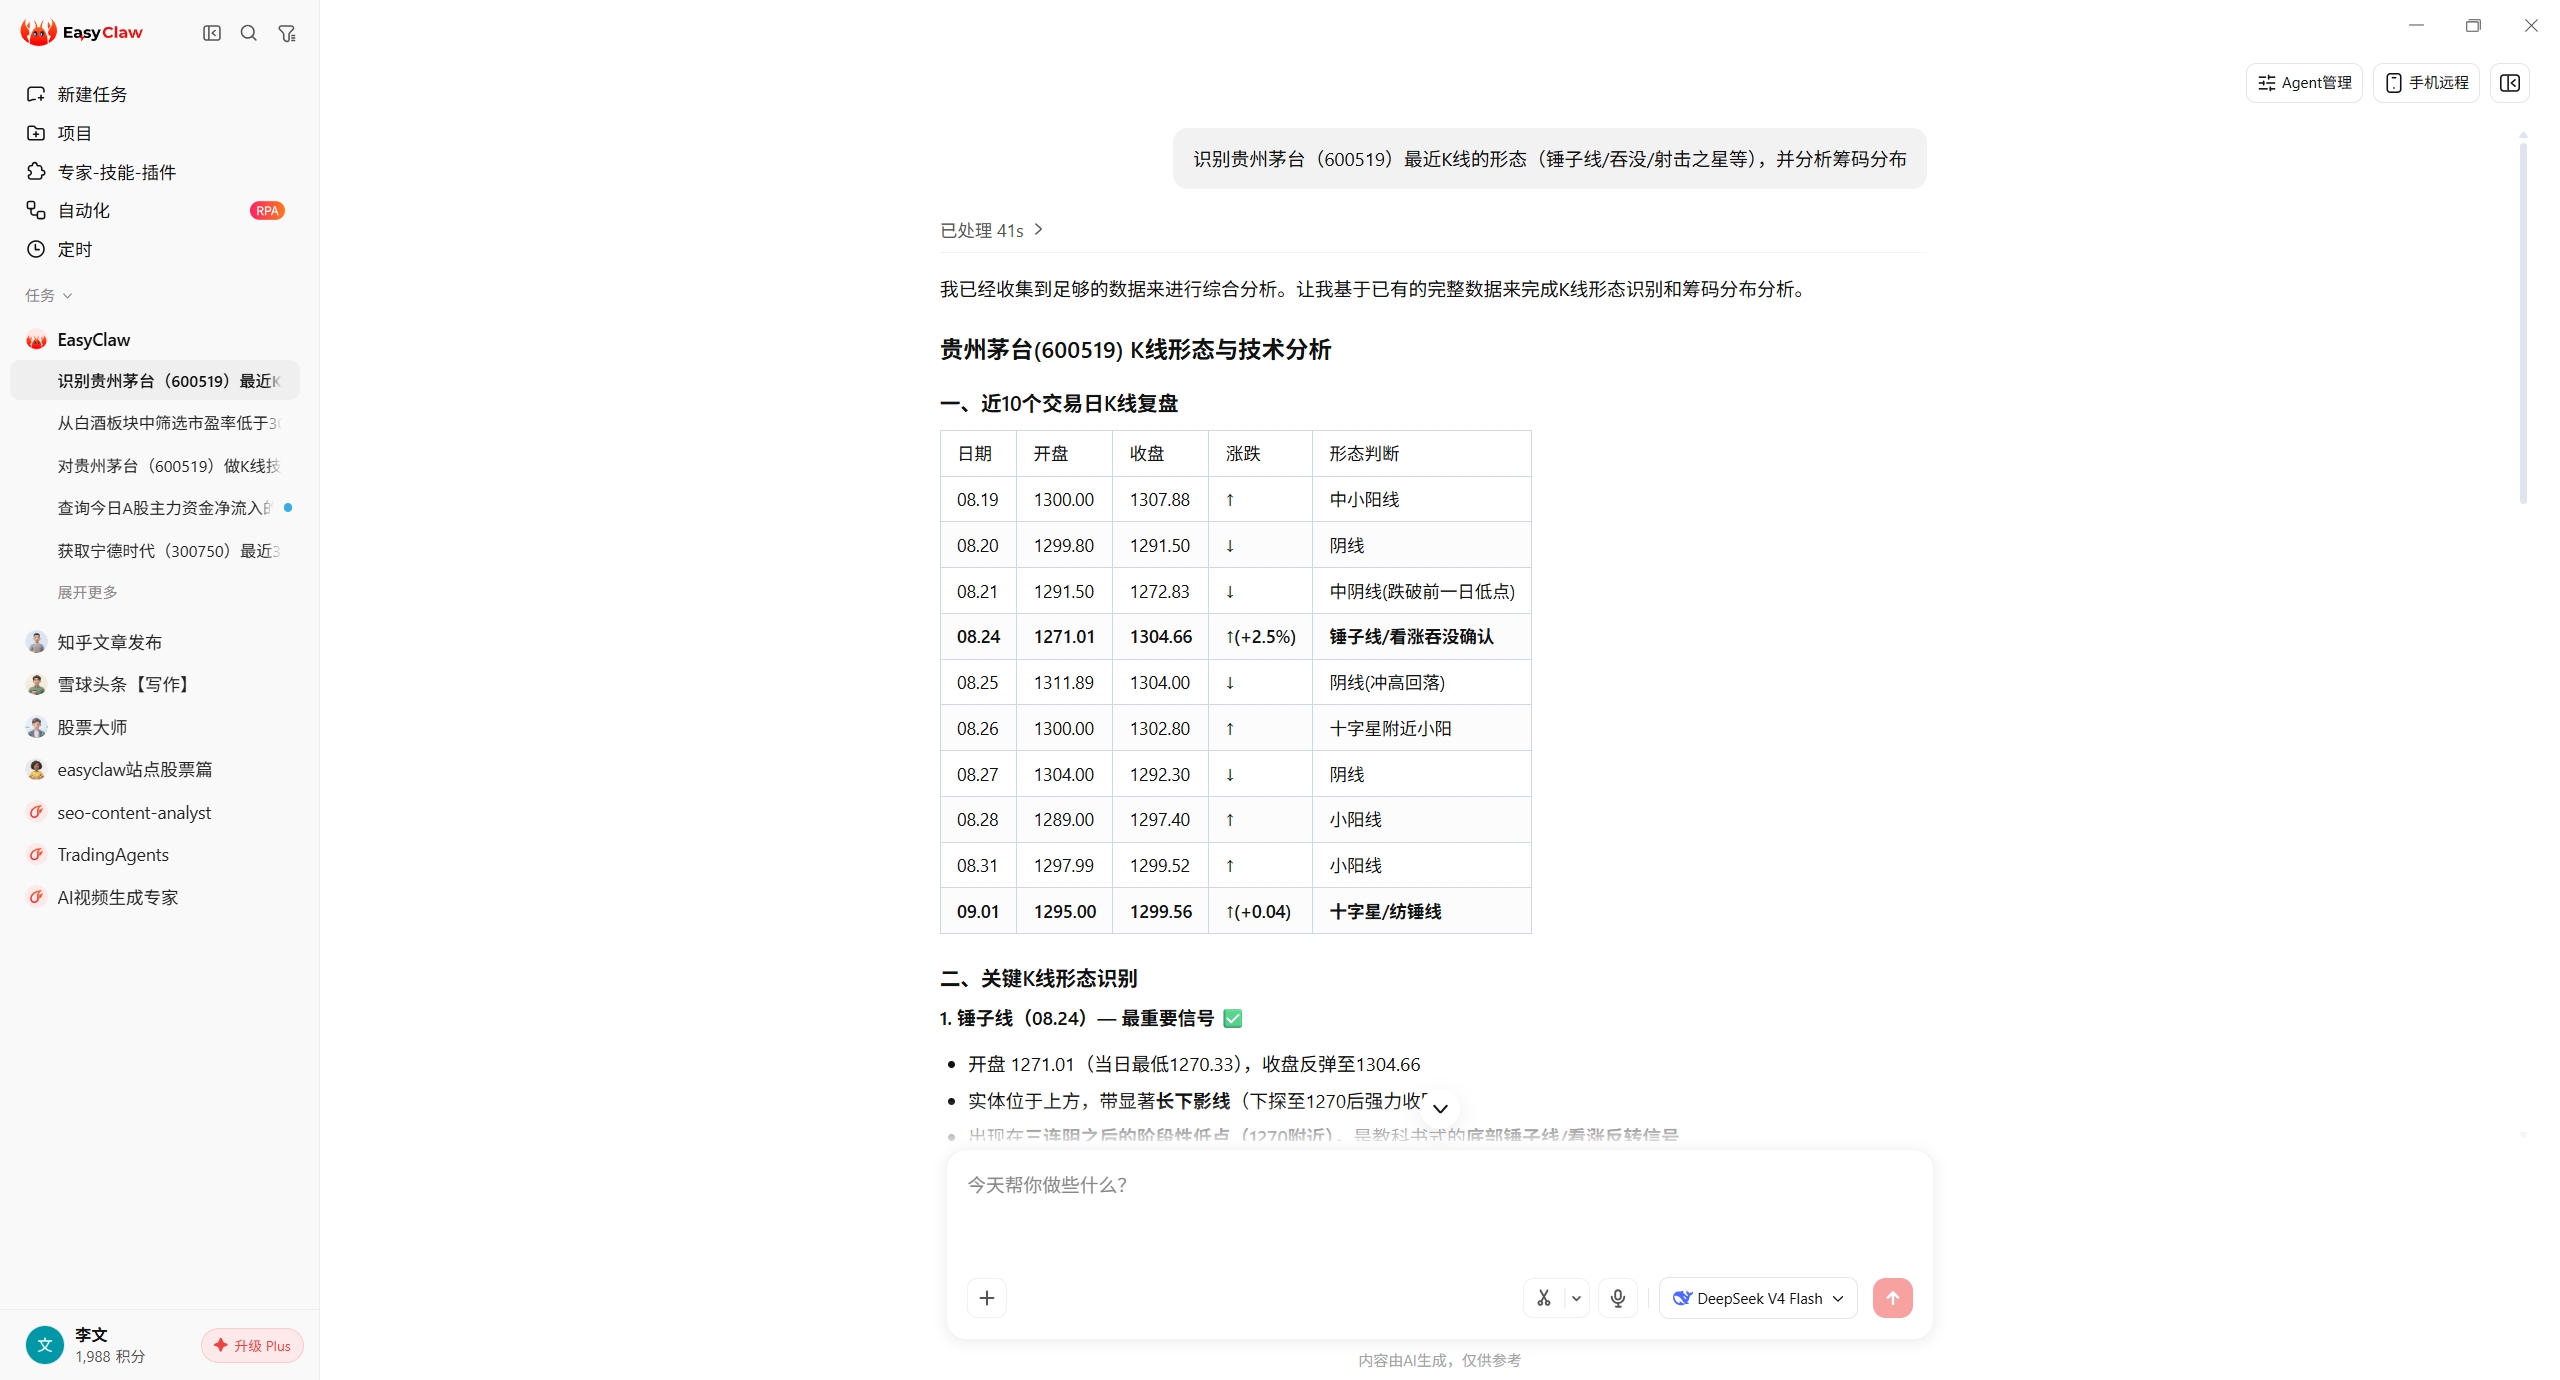
下面每行都给了「先做哪一步验证」——先花十分钟验证前置条件,比整套装完再发现方向不对要省得多。
| 你的情况 | 建议路线 | 理由 | 先做哪一步验证 |
|---|---|---|---|
| 有 Python 基础,研究以美股为主 | FinRobot 自建 | 官方数据源与四层结构正好匹配这类任务 | 先用一个最小任务确认数据源 key 可用 |
| 想复现论文级的多智能体研究管道 | FinRobot 自建 | 多智能体编排与调度是它的核心设计 | 先读四层架构,确认理解每一层职责 |
| 只查 A 股行情与技术面 | 免部署技能路线 | 自建路线做 A 股要自行适配数据源,成本更高 | 先用一个具体标的做一次技术面提问 |
| 需要一份 DCF 估值框架 | 看数字由谁算出再决定 | 自建路线用算子计算、模型叙述;免部署路线由技能给出 | 两边各跑一个最小例子,对比假设输入是否透明 |
| 要交付可复现、可复核的研究结论 | FinRobot 自建 | 环境与参数可以固定下来,便于他人复核 | 先把环境版本写进文档再动手 |
| 完全不写代码 | 免部署技能路线 | 自建路线的前置门槛会直接挡住后续所有步骤 | 先试着把一个研究问题写成一句话 |
| 团队协作、要版本管理 | FinRobot 自建(配 Git) | 管道与数据口径可纳入版本管理 | 先确认团队都能装起同一套环境 |
| 两种任务都有 | 两条路线并用 | 互不冲突:日常快速研究走免部署,长期管道走自建 | 先约定以哪一方的字段口径为准,避免结论打架 |
先把「不该自建」的情况说清楚,比堆功能更能帮你省时间。下面每一行都给「更合适的路线」,以及「什么条件下才值得回来用自建」。
| 你的需求 | 为什么不合适 | 更合适的路线 | 什么时候值得回来用 FinRobot |
|---|---|---|---|
| 只要行情、K 线与技术指标 | 它的价值在于把研究流程编排起来、并让每个数字可追溯;取一段行情、算一个指标不需要流水线,却要额外背上 uv/Node/密钥整套前置 | 行情与数据类工具,或免部署技能路线 | 当你需要把结论写成有章节、有口径说明、可交付复核的研报时 |
| 只做规则化策略回测 | 回测是可选依赖(需要额外的 backtest extra),撮合、滑点与手续费的精细度也不以回测为主业 | 专门的回测框架 | 当你需要「研究结论 → 回测验证 → 执行」三层分离里偏执行那一层的产物时 |
| 只想要一个金融领域语言模型 | 它是使用模型的平台,不训练金融大模型;定位是流程编排与验证 | 金融语言模型类项目 | 当你要把模型放进「数据源 + 算子 + 审计」的多步流程里时 |
| 需要实盘下单与风控 | 官方定位是研究与决策辅助,README 的免责声明也要求不把它当作实盘交易依据 | 交易执行与风控系统 | 当研究结论要交给执行侧、而你需要先保证结论可追溯时 |
| 只在 Windows 上想要装好即用的图形界面 | 官方桌面发行物只有 macOS Apple Silicon(M1/M2/M3 及以上);Windows 侧只能走浏览器模式或 CLI,本机实测卡在 uv 缺失 | 本机免部署技能路线 | 当你愿意装 uv + Node,或本来就有一台 Apple Silicon Mac 时 |
| 只是想试一次、看它能出什么 | 在缺 uv、缺密钥、端口未规划的情况下,比较可能的结局是卡在环境而不是看到结果 | 先用免部署路线拿到一次结果 | 当你确定要长期做可复现研究、并愿意维护环境与密钥时 |
| 以 A 股研究为主 | 官方数据链路与示例以美股为主;实测代码层接受 600519.SS、0700.HK 这类代码,但 7 个数据提供方里没有 A 股数据源 | 覆盖 A 股的数据类技能路线 | 当你自己接了 A 股数据源,并愿意处理复权、停牌、币种、交易日历等口径问题之后 |
这些误解通常不会让人当场上当,而是让人在装完环境之后才发现方向选错了。
| 常见误解 | 实际情况 | 怎么避免 |
|---|---|---|
| 两条路线是替代关系,选一个就行 | 它们解决的任务层级不同:一条是可编排的研究管道,一条是即用的研究入口 | 先按任务层级分组,再决定用哪条 |
| 有了即用路线就不需要自建 | 需要改动内部逻辑、固定环境、批量复现时,即用路线给不了这种控制力 | 先问自己「是否需要改内部流程」 |
| 跑通一条就等于跑通另一条 | 环境、数据源、口径都不同,经验不能平移 | 两边各跑一遍最小用例 |
| 开源就等于零成本 | 软件本体免费,但模型调用与部分数据源按量消耗 | 先跑一轮小任务观察消耗 |
| 有估值输出就等于估值可信 | 输出质量取决于假设输入与数据口径,两边都一样 | 核对假设输入,而不是只看结论数字 |
| 能出研报就可以直接照着做 | 两条路线的输出都是研究结果,不构成投资建议 | 把输出当线索,决策仍需自己负责 |
装上了 finrobot 这个包,就等于拥有 V2 的算子与流水线 | PyPI 上只有 2024 年的 V0 包(0.1.5),而且它一条依赖都没带;V2 的算子与流水线在 finrobot_desktop/ 里,要通过 uv sync 或桌面版获得 | 先确认自己装的是哪一代,再谈能力 |
| Web 上的中文教程可以直接照做 | 大量教程停留在 V0/AutoGen 时代(OAI_CONFIG_LIST、conda python=3.10、旧目录结构),按它操作 2026 年的仓库一上手就会失败 | 先判断教程属于哪一代,再决定是否照做 |
没有。FinRobot 与 EasyClaw 无已证实集成,本页是两条独立路线的证据对比;以各自官方文档为准。
看你目标:想复现多智能体研究管道、要固定环境与参数,选 FinRobot;想免部署直接出 A 股行情、估值、研报,免部署路线更省事。两者不是同一层级的工具。
本机技能目录含 fp-dcf 等技能,可一句话发起 DCF 估值,免去自建。具体口径与假设以该技能说明为准。
本机目录含 yahoo-finance-github 等技能覆盖美股数据;但各技能的数据源与覆盖市场各不相同,以各技能说明为准。
官方数据源以美股为主,A 股需要自行适配数据源,官方未内置 A 股接口;以官方 README 为准。
不冲突,但建议先把字段口径约定清楚:先用哪一方结果作为基准,另一方的结论只作参考,避免同一指标出现两个口径却说不清差在哪。
先看目标再选代:要拿到可追溯的结果,按 V2 操作(桌面版、浏览器模式或 CLI,命令形如 finrobot dcf);要一个能分享给同事的研报服务,按 V1 操作(两个必填 key + deploy.sh);想读懂金融智能体怎么接起来,按 V0 操作(conda + 仓库根源码安装 + notebook)。判别教程属于哪一代的最快办法:出现 OAI_CONFIG_LIST、tutorials_beginner 这类词的属 V0;出现 uv sync、dev.sh、finrobot research 的属 V2。两代的命令不要混在同一个环境里用,它们抢同一个导入名。
可以,而且这是比较稳妥的做法:先用免部署路线拿一次结果,确认你要的产出形态;再用 V2 的零依赖实验确认自建路线在你机器上能跑起来——直接调用官方确定性算子不需要密钥与联网,本站在 Windows + Python 3.11.9 上实测可跑出 WACC、隐含价与敏感性矩阵。两条路线互相独立、没有已证实集成,试的过程中不要混用同一份数据跨路线比较结论,口径不同会导致误判。