我只想快速跑通
先看版本选择页确认该装哪一代,再照安装实测页走一遍——那一页记的是本机真实结果,包括桌面版不支持 Windows、浏览器模式一上手就缺 uv 这类卡点。
金融 AI 智能体平台 / AI4Finance-Foundation
同一个 FinRobot 仓库里装着四代东西:V0 是 AutoGen 教学代码,V1 是自托管的研报 Web 应用,V2 才是官方当前的生产系统(PydanticAI + 桌面端 + CLI),V3 仍在开发中。照着两年前的中文教程装,很可能一上手就失败。本站按固定 commit 复核官方仓库,把「该用哪一版、在 Windows 上怎么真跑起来、哪些数字是代码算的、失败会怎么失败」逐页写清。
GitHub 仓库页面显示 8111 Star、1370 Fork,采集日期 2026-09-30;本站复核的固定 commit 为 2717499(2026-09-28,默认分支 master)。
 查看固定版本源码
官方 README 说得很直白:这几套代码不是同一个东西的几个版本在互相竞争,而是服务不同用途。同一件「出一份研报」,在不同版本里的做法差别很大——先选版本,再看怎么跑。下表是四代速览,完整版在版本选择页。
| 版本 | 目录 | 技术栈 | 官方定位 | 适合谁 | 在 Windows 上能否跑 |
|---|---|---|---|---|---|
| V2 | finrobot_desktop/ | PydanticAI + FastAPI + React + Tauri | Production(当前生产系统) | 要拿结果、且要数字可追溯的人 | 桌面安装包不支持;浏览器模式与 CLI 需先装 uv |
| V1 | finrobot_equity/ | OpenAI Agents SDK + FastAPI | Web app(自托管研报服务) | 要一个能被同事访问的研报服务 | 可以,但需 FMP + OpenAI 两个 key |
| V0 | finrobot_autogen/ | Microsoft AutoGen | Educational(教学与论文复现) | 想读懂智能体怎么接起来的人 | 可以(conda + Python 3.10/3.11) |
| V3 | 无公开目录 | DeepSeek-Harness | In development(开发中) | — | 无法运行:仓库里没有对应代码 |
先看版本选择页确认该装哪一代,再照安装实测页走一遍——那一页记的是本机真实结果,包括桌面版不支持 Windows、浏览器模式一上手就缺 uv 这类卡点。
重点看智能体与编排怎么分工,以及确定性估值引擎怎么把「数字由代码算、叙述由模型写」落到代码上。这两页决定了你的流程能不能被别人复核。
先看论文期四层设计跟当前仓库实现的对照,避免照着一张抽象图去猜现实;再顺着固定 commit 读智能体指令文件与算子目录。
pip install finrobot 在 PyPI 上装到的是 V0(0.1.5,2024-06-17),而且实测一条依赖都没带——装成功、import 也成功,但一调用就报缺 finnhub、autogen。要 V0 请从仓库根 pip install -e .;要 V2 走 uv sync。项目研究站常见的毛病是把转载当事实。全站按四级证据标注来源:能指向官方原文的、能在固定 commit 里核对到的、本站真跑出来的,以及本站没有实测的——最后一级也要写出来。
| 证据等级 | 含义 | 本站覆盖到的例子 | 状态 |
|---|---|---|---|
| 官方事实 | 可直接指向仓库 README、子目录 README 或发布页原文 | 版本线定义、四段式原则、13 章研报、V2 为生产系统的表述 | 有 |
| 源码核验 | 按固定 commit 取出仓库树逐项计数或读实现 | 26 个估值算子 / 6 个审计算子 / 7 个协调器 / 7 条流水线 / 7 个数据提供方 / 56 个技能文件 / 237 个测试文件 | 有 |
| 本站实测 | 在本机真跑官方代码并保留输出(含失败输出) | 确定性算子的 WACC 与隐含价、敏感性矩阵、蒙特卡洛分位数、四道估值闸门与两类输入校验的报错原文、PyPI 安装结果 | 有(部分输入为本站构造的合成数据) |
| 本站未实测 | 本机条件不足、无法验证,页面如实标注 | V1 需要 FMP + OpenAI 密钥;桌面版仅面向 macOS Apple Silicon,Windows 无法验证;商业产品条款未核 | 缺,已在对应页面标注 |
| 社区经验 | 来自第三方文章、未回到官方或代码核对 | 不作为本站结论引用;仅用于识别「老教程讲的其实是哪一代」 | 不采用 |
2717499(2026-09-28,默认分支 master),采集日期 2026-09-30。实测环境:Windows 10.0.26200 + Python 3.11.9 + Node 24.18.0 + npm 11.16.0;uv 与 Docker 在本机未安装——这条本身就是 Windows 用户会最先碰到的卡点。失败与报错原文集中在失败案例页,你可以逐条自己复现。它的定位是金融研究流程编排与辅助分析框架——不是行情服务器,不是纯回测框架,也不是自动下单系统。反过来看「什么情况下别用它」,比看功能列表更能省时间。
| 你的需求 | 为什么它不合适 | 更合适的路线 | 什么时候它才合适 |
|---|---|---|---|
| 只要行情与指标 | 它不生产行情,数据全部来自外部提供方,多一层编排反而更慢 | 直接用行情类或数据类工具取数 | 取数之后还要把分析、建模与成稿串成流程时 |
| 只做规则回测 | 它的强项是研究与叙述编排,回测能力放在可选扩展里、不是主线 | 专门的事件驱动或向量化回测框架 | 回测放在研究链路末端、需要把结论写成材料时 |
| 只要一个金融语言模型 | 它把模型当大脑用,本身不做模型训练与微调 | 面向金融的模型项目,或自家微调管线 | 模型之外的流程、验证与溯源才是你的痛点时 |
| 需要实盘下单 | 它是研究工具,不含交易执行与风控链路 | 交易系统 + 独立风控 | 只做研究材料、由人工决策时 |
| 只想先快速试用 | 自建要先选版本、装 uv 或 conda、再配若干密钥 | 先看官方示例与托管入口,或免部署的技能路线 | 确认要长期复用同一套研究流程之后 |
| 要生产级研究输出 | 可以,但需要承担数据、权限、日志与验证的运维责任 | 选 V2,并审查数据源与密钥管理 | 团队里有人能持续维护环境与流程时 |
一句话:这个项目不训练大模型,而是把大语言模型当作智能体的大脑,去感知环境、做金融链式推理,再调用工具把研究任务做完。还要先分清一件事:仓库里并存四代——V0 是可读的教学代码、V1 是自托管 Web 研报应用、V2 才是当前生产系统、V3 仍在开发中;旧文章常把 V0 的做法当成全部。下面把几条容易被混为一谈的路线摆在一起看。
| 对比维度 | FinRobot(智能体平台) | FinGPT / 传统量化框架 | 适用场景 | 注意点 / 什么时候不用它 |
|---|---|---|---|---|
| 版本形态 | 仓库里并存四代:V0 教学 / V1 Web 应用 / V2 生产 / V3 开发中 | 模型类项目多为单一代码库 | 先确定你要哪一代再谈能力 | 照旧中文教程操作,很可能讲的是 V0 |
| 核心形态 | 多智能体平台:编排 LLM、工具与确定性计算 | FinGPT 是单个金融大模型;vnpy / backtrader 是规则与事件驱动框架 | 要把「数据 → 分析 → 研报」串成可复现流程 | 只想要一个预测模型,或只想跑回测时,不必上智能体平台 |
| 主要产物 | 研究流程、结构化分析结果与研报 | 模型输出(情感/预测)或回测绩效与交易信号 | 投研自动化、文档与研报生成 | 要直接下单调仓、做实盘执行,本项目不是交易系统 |
| 要不要 GPU | 非必需:主要调用云端 LLM API 与数据接口 | 训练与微调常需要 GPU;量化回测通常不需要 | 机器只有 CPU 也想先跑通流程 | 要自己训模型才需要算力;这条与它关系不大 |
| 你主要写什么 | 提示词、任务编排与工具调用配置 | 微调脚本与数据集,或策略与指标代码 | 想用自然语言驱动研究任务 | 不接受 LLM 参与推理环节的场景,仍应走纯代码路线 |
| 新增的准备工作 | LLM API key + 数据源 API key + Python 环境 | 算力预算与训练数据,或历史行情数据 | 已经有数据源账号的团队 | 不想申请任何 key 的人,得先评估这一步成本 |
| 市场默认覆盖 | 官方数据源以美股为主(FMP / FinnHub / SEC / yfinance) | 取决于你自备的数据 | 研究美股与美股文档 | A 股需自行适配数据源,官方未内置 |
围绕「投资研究自动化」,本项目把数据获取、多智能体分析与研报生成串成一条可追溯的链路。下面先看任务类型,再看每类任务落到哪一层、需要哪些前置条件。
结合历史行情与文本信号做走势研究,官方定位是「研究」而非「预测信号」。这类输出只作为判断起点,不构成投资建议。
解析年报、公告、SEC 文件等金融文档,产出结构化摘要与成稿研报。适合把「翻文件」这一步先自动化,再人工复核结论。
DCF / DDM / LBO / WACC 由纯 Python 算子计算,LLM 只负责叙述与串联。这意味着关键数字来自代码,而不是模型「随口生成」。
用智能体做策略思路的探索与对比(例如均线类规则的参数区间比较),输出研究级结论,不承诺任何收益表现。
一个任务可以拆给多个角色:取数的、算数的、写结论的各司其职,再由调度器决定用哪个模型做哪一段,官方称之为 Smart Scheduler。
把 FinnHub、FMP、SEC EDGAR、yfinance 等来源封装成统一的取数入口,供智能体在感知阶段调用,省掉逐源写适配代码的时间。
| 你想做的事 | 落到哪一层 | 需要哪些前置条件 | 适用场景 | 注意点 / 什么时候不用 |
|---|---|---|---|---|
| 生成一份个股研究报告初稿 | 智能体层 + 数据层 + 文档分析 | LLM API key、数据源 key | 需要大量重复性的初稿产出 | 结论必须人工复核,不能直接对外发布 |
| 算 DCF / WACC 等估值指标 | 确定性计算(纯 Python 算子) | 财报数据来源 | 需要可复现、可核对的估值过程 | 假设参数由你负责,换一组假设结果就变 |
| 批量整理行情并做技术面描述 | 数据层 + 智能体描述层 | 行情数据源 key 或公开接口 | 先把描述性工作自动化 | 它不做信号回测与风控,别把它当回测框架 |
| 解析年报/公告并抽取要点 | 文档分析 + LLM 叙述 | 文档来源(部分走 SEC EDGAR) | 文档量大、人工翻页成本高 | 长文档的抽取准确率需抽样核对 |
| 比较多套策略思路 | 智能体编排 + 你的回测工具 | 历史数据与自己的回测环境 | 做思路筛选的早期阶段 | 绩效验证仍要回到专门的回测框架 |
| 把研究流程固化成可复现脚本 | 全链路(四层都用上) | Python 3.10 环境 + 密钥管理习惯 | 团队需要重复执行同一套研究流程 | 密钥要按最小权限管理,不要写进公开仓库 |
「怎么装」在 2026 年已经不是一个动作,而是四个不同的动作:V2 要 uv、V1 要两个密钥、V0 要 conda 且必须在仓库根安装。下表把每条路线的最小命令、前置条件与预期输出放在一起——先对号入座,再去安装实测页看本机跑出来的真实结果。
| 路线 | 最小命令 | 前置条件 | 预期看到什么 | 常见失败 |
|---|---|---|---|---|
| V2 · 命令行 | uv sync 后执行 finrobot research <ticker>,另有 dcf / comps / ic-memo / ask 子命令 | uv、Python 3.11+、一个 LLM key | 命令行输出估值与研报结果,含 WACC、假设与章节内容 | 本机在这一步就卡住(没装 uv);取数与推理都需要联网 |
| V2 · 浏览器模式 | uv sync → (cd desktop && npm install) → ./dev.sh,打开 :5173 | uv、Node 20+ | 浏览器出现研究界面,后端跑在 :8321 | dev.sh 会先杀掉 :8321 与 :5173 上的进程;浏览器模式下本地接口未鉴权 |
| V2 · 桌面 App | 从官方发布页下载安装包 | macOS Apple Silicon | 原生窗口 + 内置后端,用户机器上不需要 Python 环境 | Intel Mac、Windows、Linux 没有发行版;未 notarize,首次打开需按官方说明放行 |
| V1 · Web 应用 | 填 config.ini(FMP + OpenAI)→ ./deploy.sh start → :8001 | FMP 与 OpenAI 两个 key | 浏览器出现表单,输入 ticker 生成 HTML/PDF 报告 | 忘记从 example 复制配置,直接改 example 文件 |
| V0 · AutoGen | conda 建 Python 3.10 环境 → 在仓库根执行 pip install -e . → 跑 tutorial notebook | conda、LLM key 与数据源 key | notebook 逐步执行并产出中间结果 | 用 pip install finrobot 代替源码安装(依赖全空);notebook 要在自己目录里跑,否则读不到配置 |
| 装完先自检 | 正常表现 | 异常表现 | 下一步怎么做 |
|---|---|---|---|
| 选的是哪一代 | 能说清你要的是 V2 还是 V0,并知道对应目录 | 记不清、随手 pip install finrobot | 先看版本选择页,再决定装什么 |
| 版本与环境是否匹配 | V2 用 3.11+;V0 用 3.10/3.11(PyPI 包限定 <3.12) | 在 3.12 上装 V0、或在 3.10 上装 V2 | 按对应约束重建环境,一个版本一个环境 |
| 依赖是否真的装上 | 能 import 到智能体与数据源模块 | 只 import 到顶层包,一调用就缺第三方库 | 改用源码安装(仓库根),不要用 PyPI 那条路 |
| LLM 密钥是否被读到 | 任务能返回文本结果 | 提示缺少模型或 key | 桌面与浏览器模式在设置页填;V0 走配置文件 |
| 数据源是否可达 | 能取到实际行情或财报字段 | 返回空表或权限类报错 | 逐个源单独验证,先只留一个能用的 |
| 结果能否被复核 | 关键数字能对应到算子输出 | 只有结论文字、找不到数字来源 | 用估值引擎页的实测表对一次口径 |
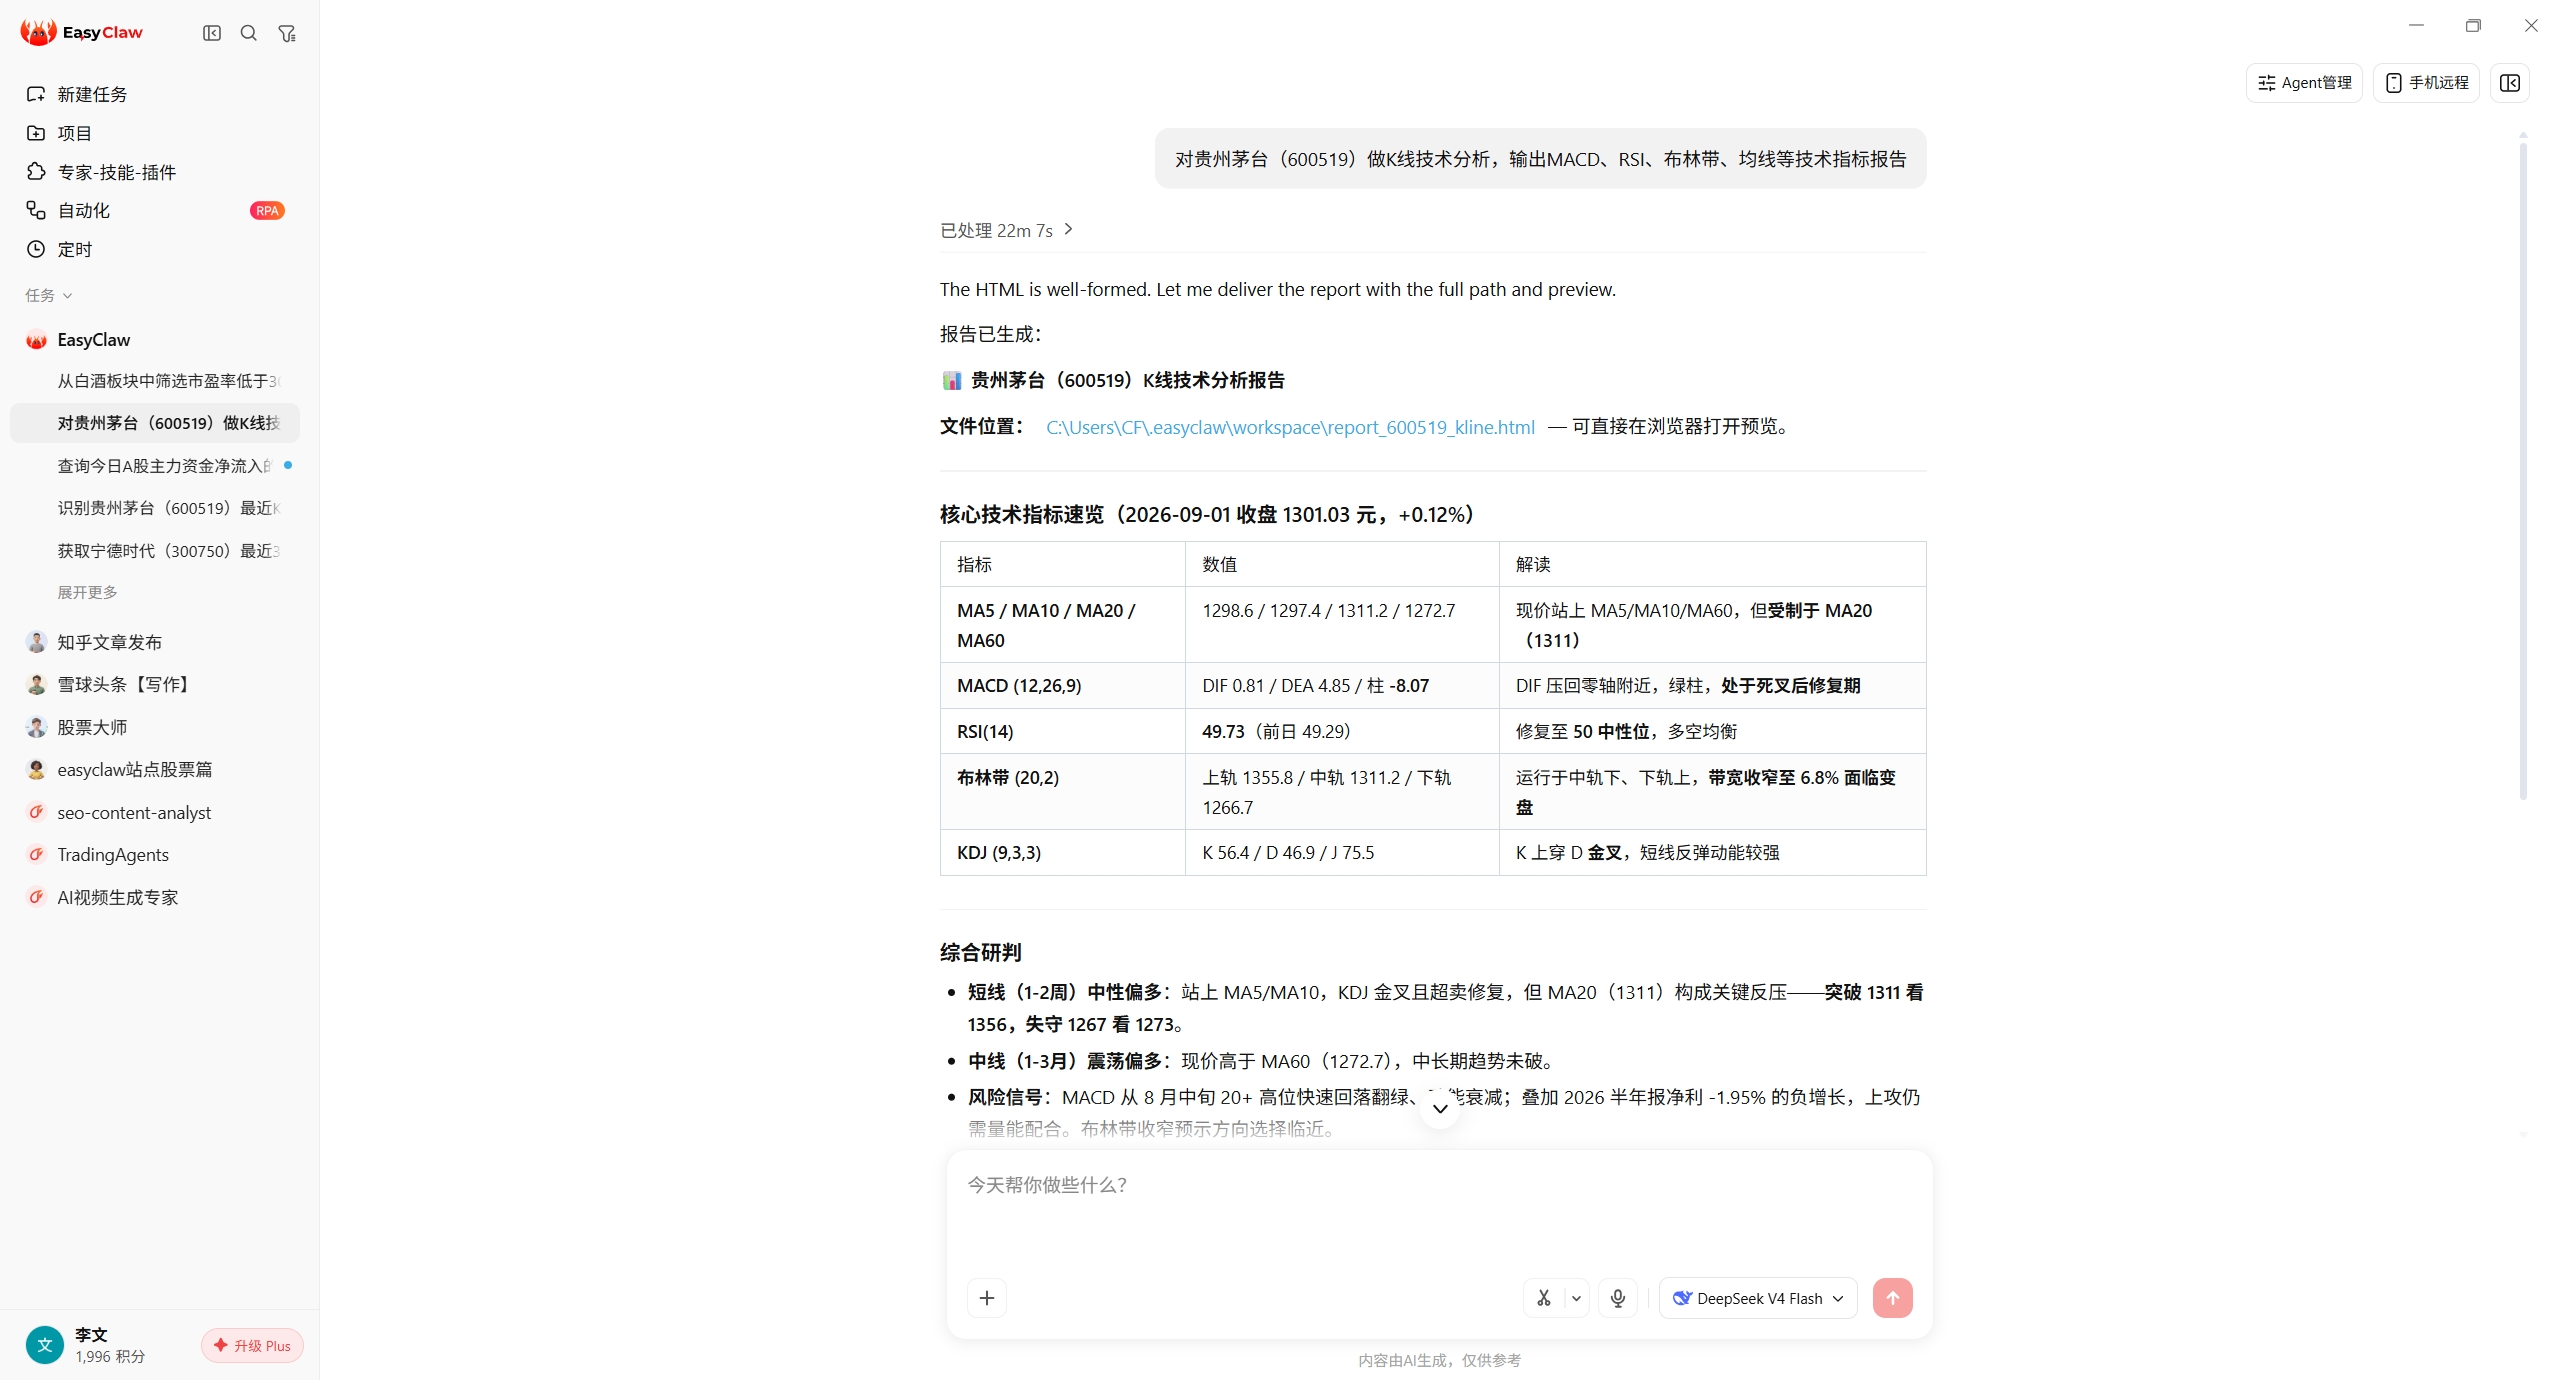
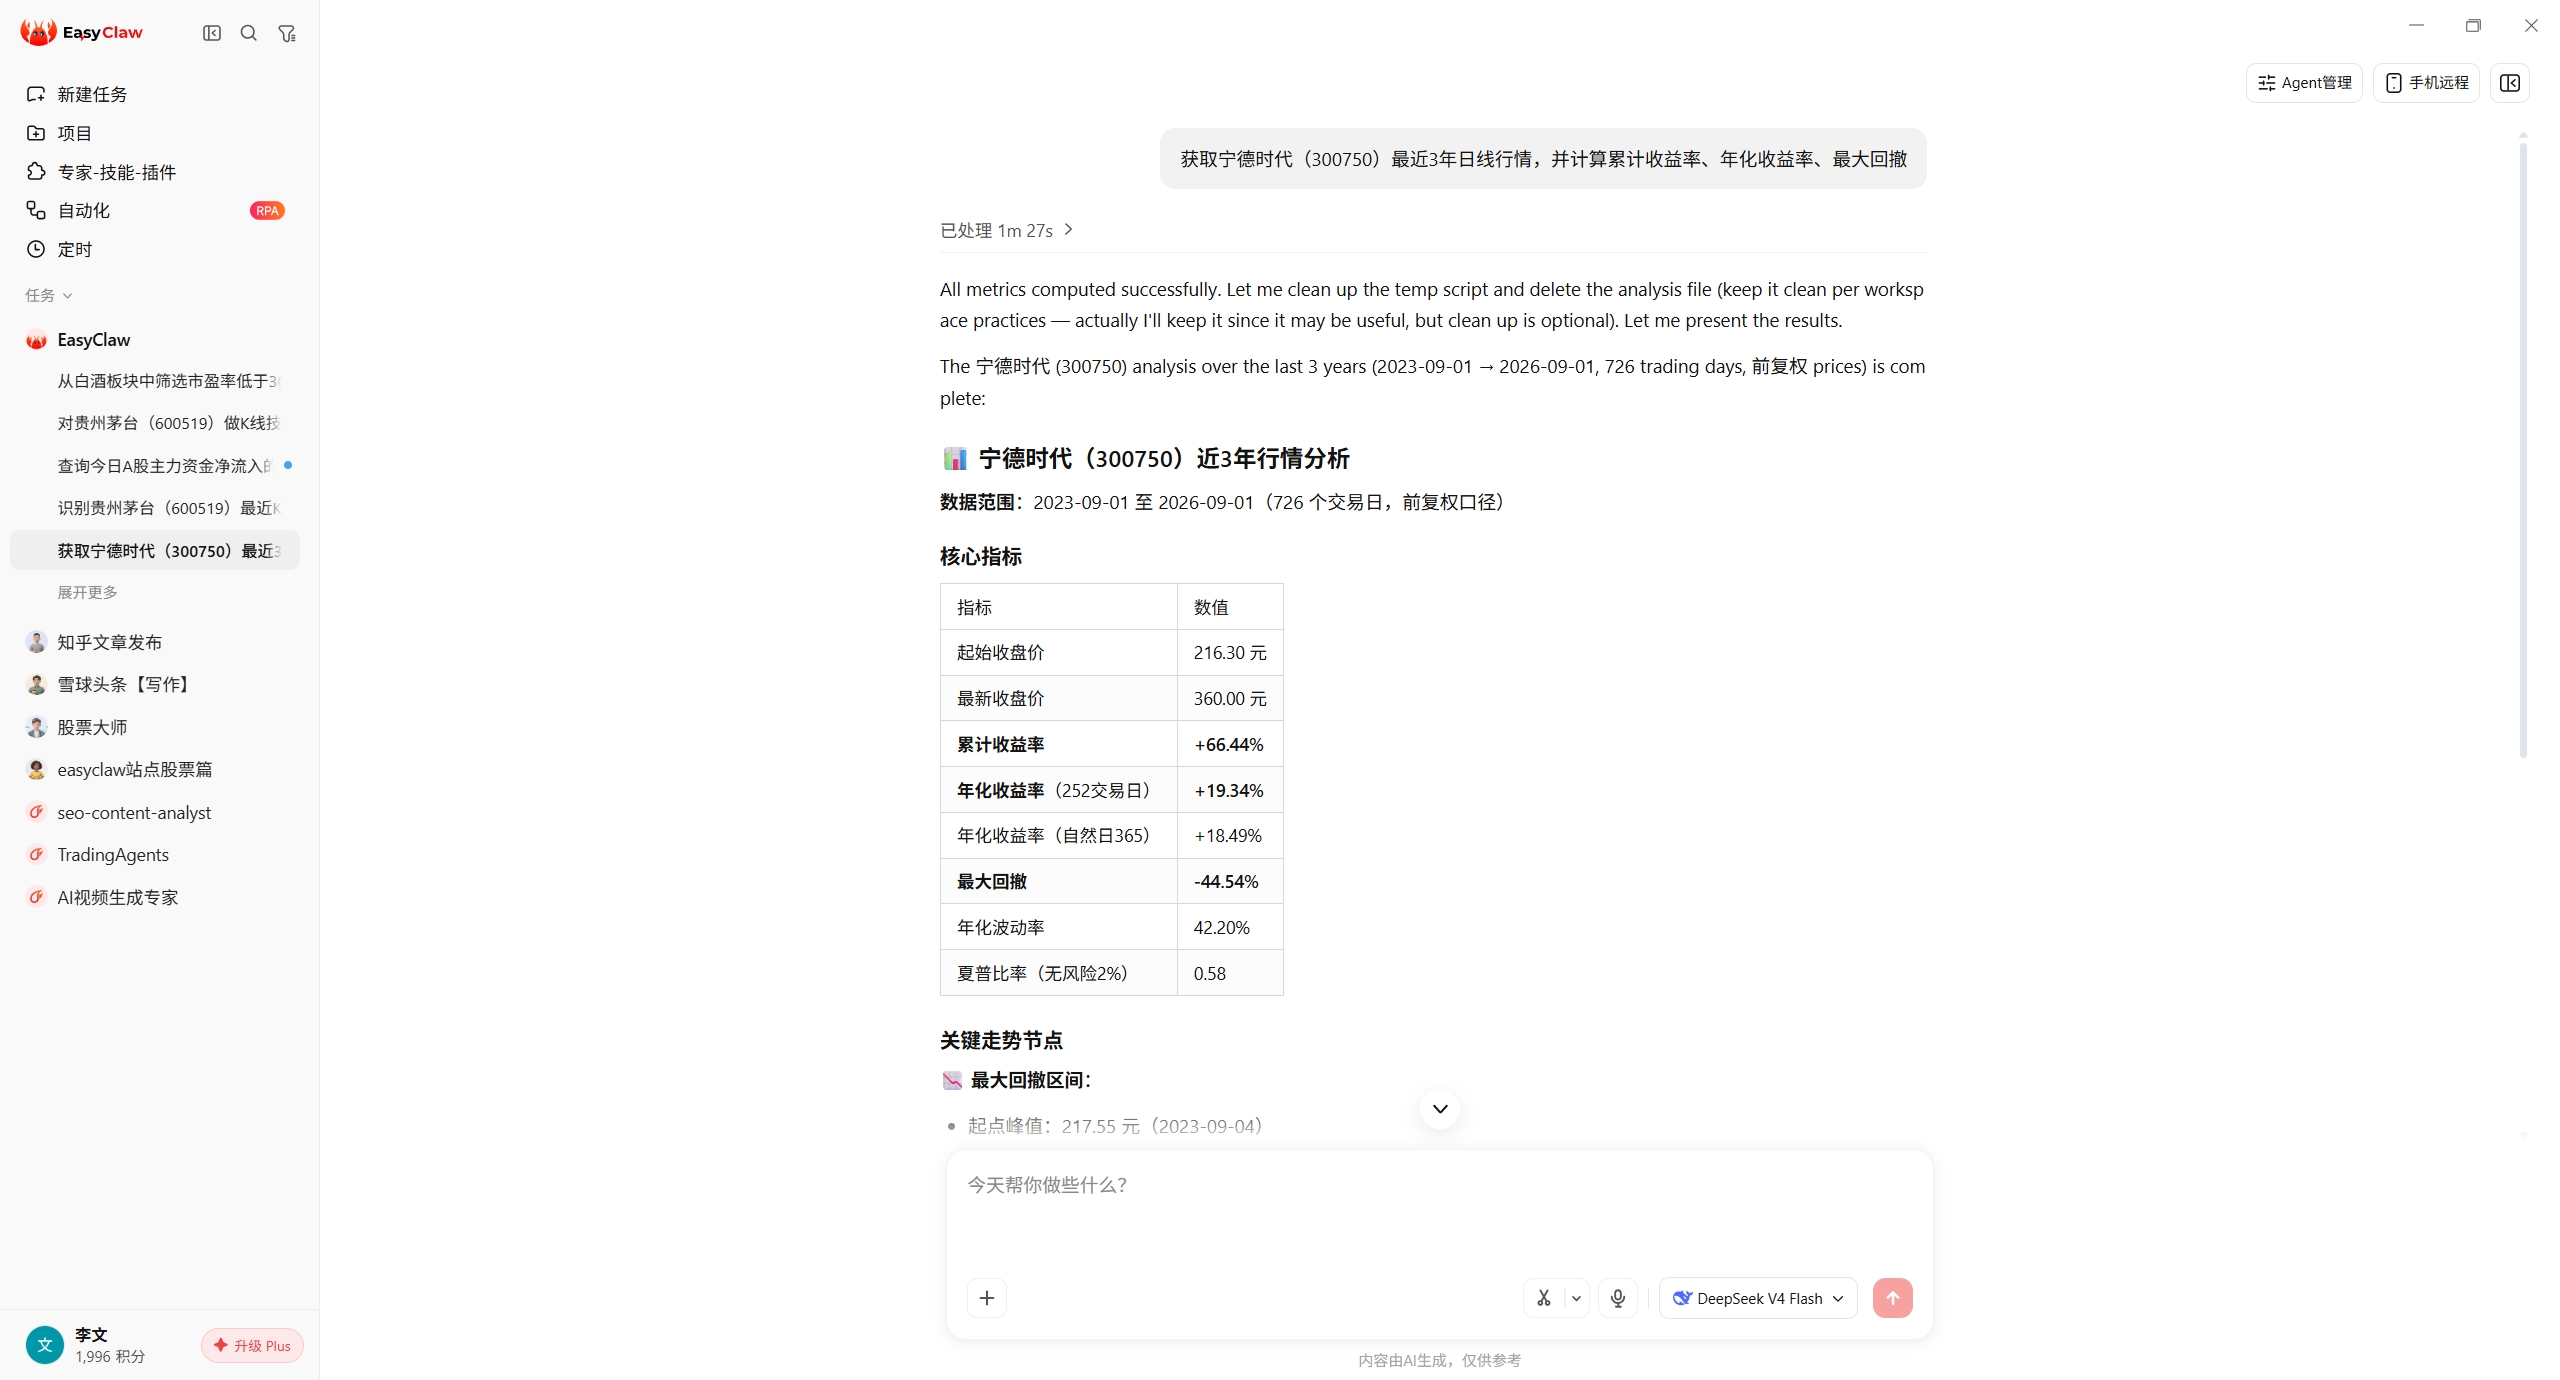
uv sync,而本机没有安装 uv,所以在这台机器上这两条路一上手就停;③ pip install finrobot 装到的是 2024 年的 V0 且零依赖,import 能过、用起来就断。先确认这三条都不成立,再开始装,能省掉大量「以为是代码坏了」的时间。同一件「把金融研究做出来」的事,两条路线的准备动作完全不同。左边要装环境、配密钥、跑 notebook;右边装好客户端,用一句话把任务说清楚即可。下面把两条路的成本与边界对称摆开。
灵活度高,但要自己维护环境、多个数据源密钥与模型调用成本。
两条路线彼此独立:本机技能路线的数据源、额度与市场覆盖各不相同,也不代表这个项目已经被其集成。
以下为本机技能路线的实际使用截图(左右翻页查看):一句话做 K 线技术分析、获取收益指标,即返回结构化结果。截图演示的是免部署路线,不是本项目自身的运行结果。
FinRobot 本体是 Apache-2.0 开源、免费使用,但「能跑起来」和「装好了」是两件事:LLM 调用与数据源接口通常各自计费,官方 README 不会给出一张总账单。下表把常见支出项拆开,方便你先算清再决定投入。
| 支出项 | 是否必需 | 免费与否(大致口径) | 怎么控制成本 | 注意点 |
|---|---|---|---|---|
| 项目本体(代码与许可) | 必需 | Apache-2.0 开源,可免费使用 | 直接按官方仓库获取即可 | 许可条款与商标使用以仓库 LICENSE 为准 |
| 零依赖实验(直接跑官方算子) | 非必需 | 免费:不需要 LLM key,也不需要联网 | 想先验证「数字是不是代码算的」,就跑这一条 | 输入要你自己准备;本站实测用的是构造的合成数据 |
| LLM API 调用 | 必需(智能体推理靠它) | 按量计费,价格以各家官方定价页为准 | 先用小样本跑通流程,再放大任务量 | 长文档与多轮推理最容易把费用推高 |
| 数据源:FMP / FinnHub | 视任务而定 | 通常有免费额度与付费档,分级以各自官网为准 | 先只开通任务真正需要的那一个源 | 免费额度通常伴随频率与字段限制 |
| 数据源:SEC EDGAR | 视任务而定 | 公开数据,通常无需付费 key | 主要用于美股公告与文件类任务 | 访问频率与使用方式请遵守官方规则 |
| 数据源:yfinance | 可选 | 走公开接口,通常无需付费 | 适合先把流程跑通 | 稳定性与限流不受项目控制,不适合当作单一数据来源 |
| 运行环境(机器/环境) | 必需 | 自备:本地机器或云主机 | CPU 机器即可起步,官方未要求本地 GPU | 要自训模型才会产生算力开支,与日常使用是两回事 |
| 桌面客户端(可选) | 可选 | 官方提供 Desktop 版;具体获取与授权方式以官方说明为准 | 先用命令行/notebook 验证流程,再考虑桌面版 | 官方 README 记 Desktop v0.1.0 仅支持 macOS Apple Silicon,且非 Apple-notarized |
下面这八个问题几乎每个刚开始接触 FinRobot 的人都会遇到,官方 README 通常只答其中一部分。每条给「一句结论 + 还需自己确认的边界 + 去看哪一页」,不替官方下结论。
| 你可能会问 | 一句结论 | 需要继续确认的边界 | 细节页 |
|---|---|---|---|
| 该装哪一版? | 按目标选:要结果选 V2,要 Web 服务选 V1,要读源码选 V0 | PyPI 上只有 2024 年的 V0 且零依赖,别用它起步 | 版本选择 |
| 要不要 GPU? | 日常使用不需要,官方安装说明只要求 Python 环境 | 自己训练/微调模型时另算 | 安装部署 |
| 能不能分析 A 股? | 官方数据源以美股为主,A 股要自行适配 | 适配方式属于二次开发,非官方内置能力 | 数据源与密钥 |
| 有没有中文文档? | 官方以英文 README 与示例为主 | 中文资料多来自社区,准确性需回到官方核对 | 四层架构 |
| 能不能直接做交易/实盘? | 它的定位是研究与研报,不是交易执行系统 | 涉及下单执行需另配交易系统 | 定位与区别 |
| 和 FinGPT 什么区别? | 一个是智能体平台,一个是金融大模型 | 「官方称超越单模型方式」属官方自述,需自行验证 | 定位与区别 |
| 为什么要装 conda,用 venv 行不行? | 官方安装说明写的是 conda 流程 | 换工具链属自担风险,遇问题先回到官方流程复现 | 安装部署 |
| 需要几个 API key? | 至少一个 LLM key,加任务所需的数据源 key | 需要哪些源取决于你的任务 | 数据源与密钥 |
| 不写代码能用吗? | 这个项目主要面向能跑 Python 的使用者 | 想完全不写代码,可以考虑免部署的本机技能路线 | 路线对比 |
它是 AI4Finance-Foundation 的开源金融 AI 智能体平台:用大语言模型作大脑,通过「感知 → 大脑 → 行动」工作流完成金融研究、估值与研报等任务。具体能力与目录结构以官方 README 为准。
仓库里并存四代:V0(AutoGen,教学与论文复现)、V1(OpenAI Agents SDK,自托管 Web 研报应用)、V2(PydanticAI,官方标注为生产系统,含桌面端与 CLI)、V3(开发中,无公开代码)。要拿去用的研究结果走 V2;只想读懂结构走 V0。版本线的正式定义以官方 README 为准。
因为 PyPI 上是 2024-06-17 的 0.1.5(V0),而且实测不带任何依赖:包元数据里没有依赖声明,结果就是「装得上、import 得过、一调用就报缺 finnhub 或 autogen」。要 V0 请从仓库根源码安装,要 V2 请用 uv。这条是本站在本机隔离环境里实测到的,不是推测。
前者是智能体平台,把多个智能体、工具调用与确定性计算统一成工作流;后者是金融大模型,走单模型微调路线。哪条更适合你取决于任务是「要一套流程」还是「要一个模型」,结论以官方 README 为准。
需要 Python 环境(官方安装说明用 conda + Python 3.10),并要配置 LLM 与数据源 API key;日常使用主要调用云端接口,本地 GPU 非必需。具体版本与依赖以官方 README 为准。
官方数据源以美股为主(FMP / FinnHub / SEC EDGAR / yfinance),A 股需要自行适配数据源;输出为研究结果,不构成投资建议。数据源清单以官方 README 与代码目录为准。
代码与许可免费(Apache-2.0),主要开支是 LLM API 调用与部分数据源接口,公开源(如 SEC EDGAR、yfinance)通常无需付费。具体价格与免费额度以各家官方定价页为准;先缩小数据范围与任务次数是最有效的省钱方式。
不能相互替代。FinRobot 与 EasyClaw 无已证实集成:一边是自建的 Python 智能体管道,一边是免部署的研究入口,适合的场景不同。两条路线的取舍见对比页,能力边界以各自官方资料为准。