StockSight:股票新闻情绪与异动分析,从数据到可复现报告
给一只股票、一批新闻、一个情绪分数,讲清楚它们各自怎么来的、能证明什么、不能证明什么。同名仓库有三个,本站在第一屏就帮你分清。
本站不把情绪评分包装成涨跌预测。所有结论都标证据等级:本机实测、官方文件、还是仅由文件推导的示意。
项目来源
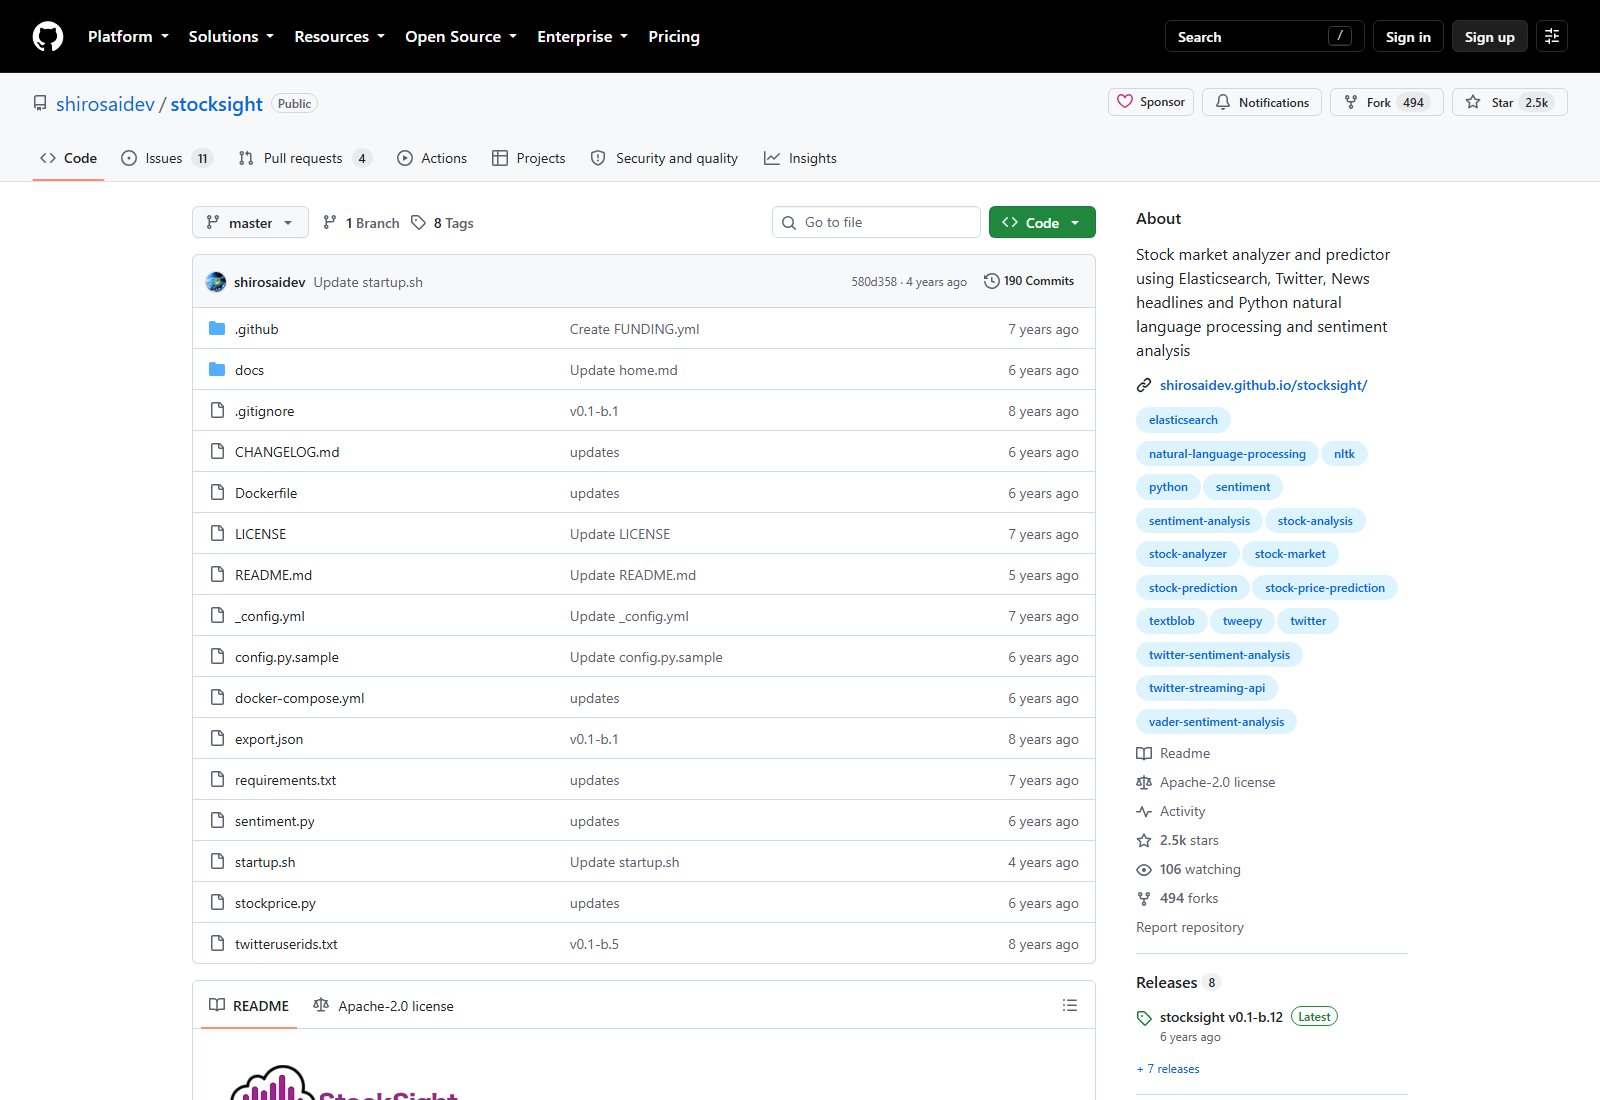
Star 约 2.5k · Fork 494 · Apache-2.0 · 最新 release v0.1-b.12(2026-09-30 匿名采集,数字会随社区变化)
 查看源码 ↗
StockSight 跑一次,你会拿到什么东西?
这一节先回答结果,再谈原理。老版 stocksight 的产出不是「涨跌判断」,而是一批结构化的舆情数据和一个可视化入口。
一条命令决定「要盯哪只票、用哪些关键词过滤推文」,另一条命令把价格也灌进同一个索引。
- Elasticsearch 索引
stocksight里的三类文档:tweet、newsheadline、stock - 每条文档带
polarity(情绪极性)、subjectivity(主观度)、sentiment(positive / neutral / negative)三个字段 - 7 个 Kibana saved object:1 个仪表盘 + 1 个保存的搜索 + 5 个可视化
- 终端里持续打印的抓取计数、过滤比例与情绪摘要
| 你以为它会给你 | 它实际给你 | 为什么容易误会 |
|---|---|---|
| 买入 / 卖出信号 | 正面 / 中性 / 负面的文本分类统计 | 项目描述里出现了 predictor 这个词,但仓库内没有任何预测模型代码 |
| 一张股票走势预测图 | Kibana 里的情绪分布与词云 | 官方截图展示的是仪表盘,容易被读成「预测结果页」 |
| 自动交易 | 什么交易接口都没有 | 项目定位是「分析 + 存储 + 可视化」,不含下单逻辑 |
| 覆盖所有市场 | Twitter 内容 + 新闻标题 + Yahoo 价格 | 三个采集源都围绕英文语境,没有 A 股数据源 |
| 安装即用 | 需要先跑通 Elasticsearch、Kibana、Twitter 凭据 | README 的步骤写得没错,但在今天的环境里会在 pip 阶段就断掉 |
| 一份可交付的分析报告 | 终端打印 + Kibana 面板 | 老版没有报告渲染这一层;报告能力属于另一条 Skill 路线 |
| 可回放的证据 | 数据存在索引里,可反复查询 | 这是它真正的优势:查询能力比一次性输出强得多 |
| 中文内容的情绪判断 | 两个英文词典模型的平均值 | 没有中文分词与中文情感词典,结果需要实测才知道 |
三个同名仓库是什么关系?技术与产出物差在哪
中文资料常把它们当成同一个项目。下面这张对照按官方文件逐项核对,只看你能观察到的事实。
Elasticsearch 舆情平台
shirosaidev/stocksight2017 年开源,用 Elasticsearch 存推文与新闻标题,再用 Kibana 做情绪与价格的可视化面板。
- Star 约 2.5k,Apache-2.0
- 最后推送 2023-12-05
- 两个脚本 + 一个索引三种文档
新闻情绪 Skill
gaaiyun/stocksight-skill抓 A 股 / 美股个股新闻,用四个 backend 逐条打分,再聚合成一个方向信号。
- Star 0,无 LICENSE 文件
- 最后推送 2026-05-30
- 命令行 news / analyze / sentiment
异动分析 Skill
GearVoid/StockSight-Skillv0.6.0,面向 Agent:多数据源取行情、洗可疑字段、检测异动、渲染 Markdown / HTML 报告并支持快照回放。
- Star 0,MIT
- 最后推送 2026-06-11
- 160 个单测,快照路径可离线跑
| 观察项 | Elasticsearch 舆情平台 | 新闻情绪 Skill | 异动分析 Skill |
|---|---|---|---|
| 运行形态 | 两个 Python 脚本 + 两个服务容器 | 命令行工具 | Agent Skill + 命令行 |
| 存储 | Elasticsearch 索引 | 可选 JSON 落盘 | 快照 JSON + 生命周期账本 |
| 可视化 | Kibana 仪表盘(7 个 saved object) | 无 | 自包含 HTML 报告 |
| 情绪模型 | TextBlob + VADER 平均,可选外挂服务 | VADER / TextBlob / SnowNLP / FinBERT | 不做新闻情绪,做量价与技术指标 |
| A 股支持 | 无 | 有(走 akshare) | 有(腾讯 / 东财 / 新浪 / 可选 AkShare) |
| 维护状态 | 2020 年后基本停滞 | 2026-05 后无新提交 | 2026-06 后无新提交 |
| 本机能否跑通 | 依赖链已断(见安装页) | 主流程可跑,测试缺依赖 | 快照路径 exit 0,160 个单测全过 |
| 命令行入口 | 两个独立脚本,参数较多 | 单一入口 + 四个子命令 | 单一入口 + 多种渲染模式 |
| 首次看到结果 | 需先修依赖,再起两个服务 | 装 4 个依赖即可,但取数依赖第三方接口 | 离线快照即可出报告,无需任何密钥 |
| 中文内容支持 | 无 | 有中文情感模型与 A 股新闻源 | 报告本身为中文,但不分析中文文本情绪 |
| 输出形态 | 终端日志 + 可查询索引 | 命令行输出 JSON,可落盘 | Markdown / 自包含 HTML,可长截图 |
| 可复现机制 | 靠索引与脚本版本 | 无内置快照 | 快照保存与回放是官方主推路径 |
三条路线的 Star 数差异很大,但本站不对它们做优劣排序:老项目功能最全、依赖最重、维护最旧;两个 Skill 路线更贴合 Agent 场景,但社区验证几乎为零。选择取决于你想解决的问题。
StockSight 主实体的仓库状态怎么样?数字怎么自己核对
本站主体围绕 shirosaidev/stocksight 展开。本页 hero 右侧那张仓库页截图在 2026-09-30 匿名访问采集,任何人可以复现;下表把截图里读到的数字逐项写明出处。
| 观察项 | 数值 | 来源 | 读的时候要注意什么 |
|---|---|---|---|
| Star / Fork / Watch | 2,541 / 494 / 106 | GitHub API | Star 高说明「被收藏得多」,不等于今天仍能跑 |
| 许可证 | Apache-2.0 | 仓库 LICENSE(11,345 字节) | 允许商用与修改,但需保留声明 |
| 最后推送 | 2023-12-05 | GitHub API | 与 CHANGELOG 末条(2020-06-08)相差三年半 |
| 代码内版本常量 | 0.1-b.12 | sentiment.py 第 35 行 | 版本号从 0.1 起就没进过 1.0 |
| 发布与标签 | 8 个 release / 8 个 tag | 仓库页面 | 最新 release 页面标注「6 年前」 |
| 文件总数 | 24 个条目 | git tree API | 没有 tests、没有 setup.py、没有 CI |
| open issue | 15 | GitHub API | 按「最后推送 2023」推断,大概率不会被处理 |
| 仓库体积 | 约 3.1 MB | GitHub API | 不含依赖与数据;真正的体积在 Elasticsearch 索引上 |
| 默认分支 | master | GitHub API | 不是 main,clone 与 raw 链接写错分支会 404 |
| 订阅人数 | 106 | GitHub API | 订阅数比 Star 更能反映「真在跟进」的人数 |
evidence-matrix.md。本站所有数字都能在那里查到出处。表里的每一项都建议你自己抽验一次:打开仓库页刷新 Star 数、点进 Releases 看最新版本号、下载 LICENSE 确认许可证类型。这三步大约两分钟,比引用任何二手总结都可靠——尤其是 Star 数与「最近一次提交时间」这两项,它们最容易被旧教程的截图误导。
为什么本站每条结论都要带证据等级?
这个主题的中文内容高度同质:把 README 翻译一遍,再补一句「可以预测涨跌」。本站改用五级证据标注。
| 等级 | 含义 | 本站实例 | 适用场景 |
|---|---|---|---|
| 本机实测 | 在本机环境真实执行过,有日志或产物 | 依赖链四层失败点、160 个单测结果、三个模型的分值 | 可以直接当作结论引用 |
| 官方文件 | 取自仓库内的 README / 源码 / 配置文件 | 算法公式、索引文档类型、Kibana saved object 名单 | 引用时必须写明是哪个文件哪一行 |
| 文件推导示意 | 根据官方文件画出的结构图,不是运行截图 | 首页与各子页的示意图 | 只能说明结构,不能证明运行 |
| 待核验 | 官方文档未明确,或本机条件不具备 | Docker 路径(本机无 Docker)、FinBERT 分值 | 必须写出「未验证」字样 |
| 不采信 | 与官方文件冲突或无法追溯 | 「可精准预测涨跌」类表述 | 本站不出现 |
示例:本机在 Windows + Python 3.11.9 的全新隔离环境里执行官方 README 的安装命令,得到 metadata-generation-failed;这一条属于「本机实测」,因此本站会给出完整报错原文与可行顺序,而不是照抄 README 的步骤。
报告里的每个数字,来源在哪一步?
这是 StockSight 系列最值得保留的设计:把「可确认 / 推导 / 历史计算 / 不可用」直接写在报告上。
| 标签 | 含义 | 本机实跑中的例子 | 为什么要标 |
|---|---|---|---|
| 可确认 | 供应商字段直接给出,未做加工 | 实时行情、成交活跃度、量比 | 这类数据可以直接进入判断 |
| 推导值 | 由其他字段算出,误差随假设变化 | 换手率 = 成交量 ÷ 流通股本 | 流通股本口径不同会导致数值不同 |
| 历史计算 | 用历史 K 线算出,依赖窗口长度 | MACD、RSI、BOLL、KDJ | 历史 K 线不足时该标签会变成「不可用」 |
| 不可用 | 字段缺失或明显异常,强制留空 | 本机快照样例里 BOLL20 与 KDJ9 显示「数据不足」 | 宁可留空,也不让坏数据带偏结论 |
| 时间戳 | 行情时间与指标截止日必须可见 | 报告顶部固定两行 | 没有时间戳的报告无法判断是否过期 |
| 来源链 | 列出实时源、历史源、兜底源与 K 线条数 | 快照模式下显示为 example snapshot | 换源会改变数值,来源必须可追溯 |
需要提醒的是:这些标签目前主要出现在异动分析 Skill 路线里。老版 Elasticsearch 平台没有该机制,它只写入 polarity / subjectivity / sentiment 三个字段。
另外一个容易被忽略的区别是「时间戳」。老版写入索引时用的是抓取当下的时间(源码里调用的是 UTC 当前时间),而不是新闻或推文的原始发布时间;异动分析 Skill 则把「行情时间」与「历史指标截止日」分成两行放在报告顶部。前者在你回溯历史数据时会把所有记录压成同一时刻,后者虽然更啰嗦,但至少让「这份结论基于哪一天的数据」这件事可查。做严肃研究时,时间戳的设计比字段数量更重要。
最低成本的一次成功体验怎么做?
如果你想先看到东西再决定要不要深入,走「异动分析 Skill 的快照路径」:不需要网络、不需要任何 API Key。
克隆并装依赖
这个仓库的依赖只有
requests与一个 urllib3 的上限补丁,是本机三个仓库里唯一「一条命令装完」的。用自带快照渲染报告
不联网、不取实时行情,直接读
examples/a-share-detailed.json生成 HTML 与 Markdown。本机实测产出 HTML 73,498 字节、Markdown 5,730 字节。先看报告里「空的地方」
本机实跑时,「最终判断」与「关注维度」两张表只有表头没有数据行,成交额被渲染成
RMB 389,400,000万。这些不是本站的结论,是你可以自己复现的现象。再决定要不要接真实数据源
接实时行情需要装
requests之外的东西,并接受部分字段显示为「数据不足」——BOLL 与 KDJ 在样例里就是如此。
如果你更想走老版 Elasticsearch 路线,请先读「安装与运行」页:本机实测显示官方依赖清单在 2026 年的 Python 环境里会在 pip 解析阶段断掉,且断点有四层。
最后提醒一句成本:快照路径的价值在于「零成本看到产物形态」,而不是「验证了策略」。它用的是仓库自带的示例数据,与你的标的、你的时间段、你的数据源都没有关系。看到报告格式符合预期之后,第二步应该是换成你自己的数据重跑一次,而不是直接采信示例里的任何数字。
不搭数据库、不写代码,能不能先拿到同类结果?
上面两条路线的共同门槛是「先跑起来」。如果你只是想先看行情、算一个波动率,本机已装的中文技能可以免部署走一遍——下面是对话实拍,左右翻页查看。
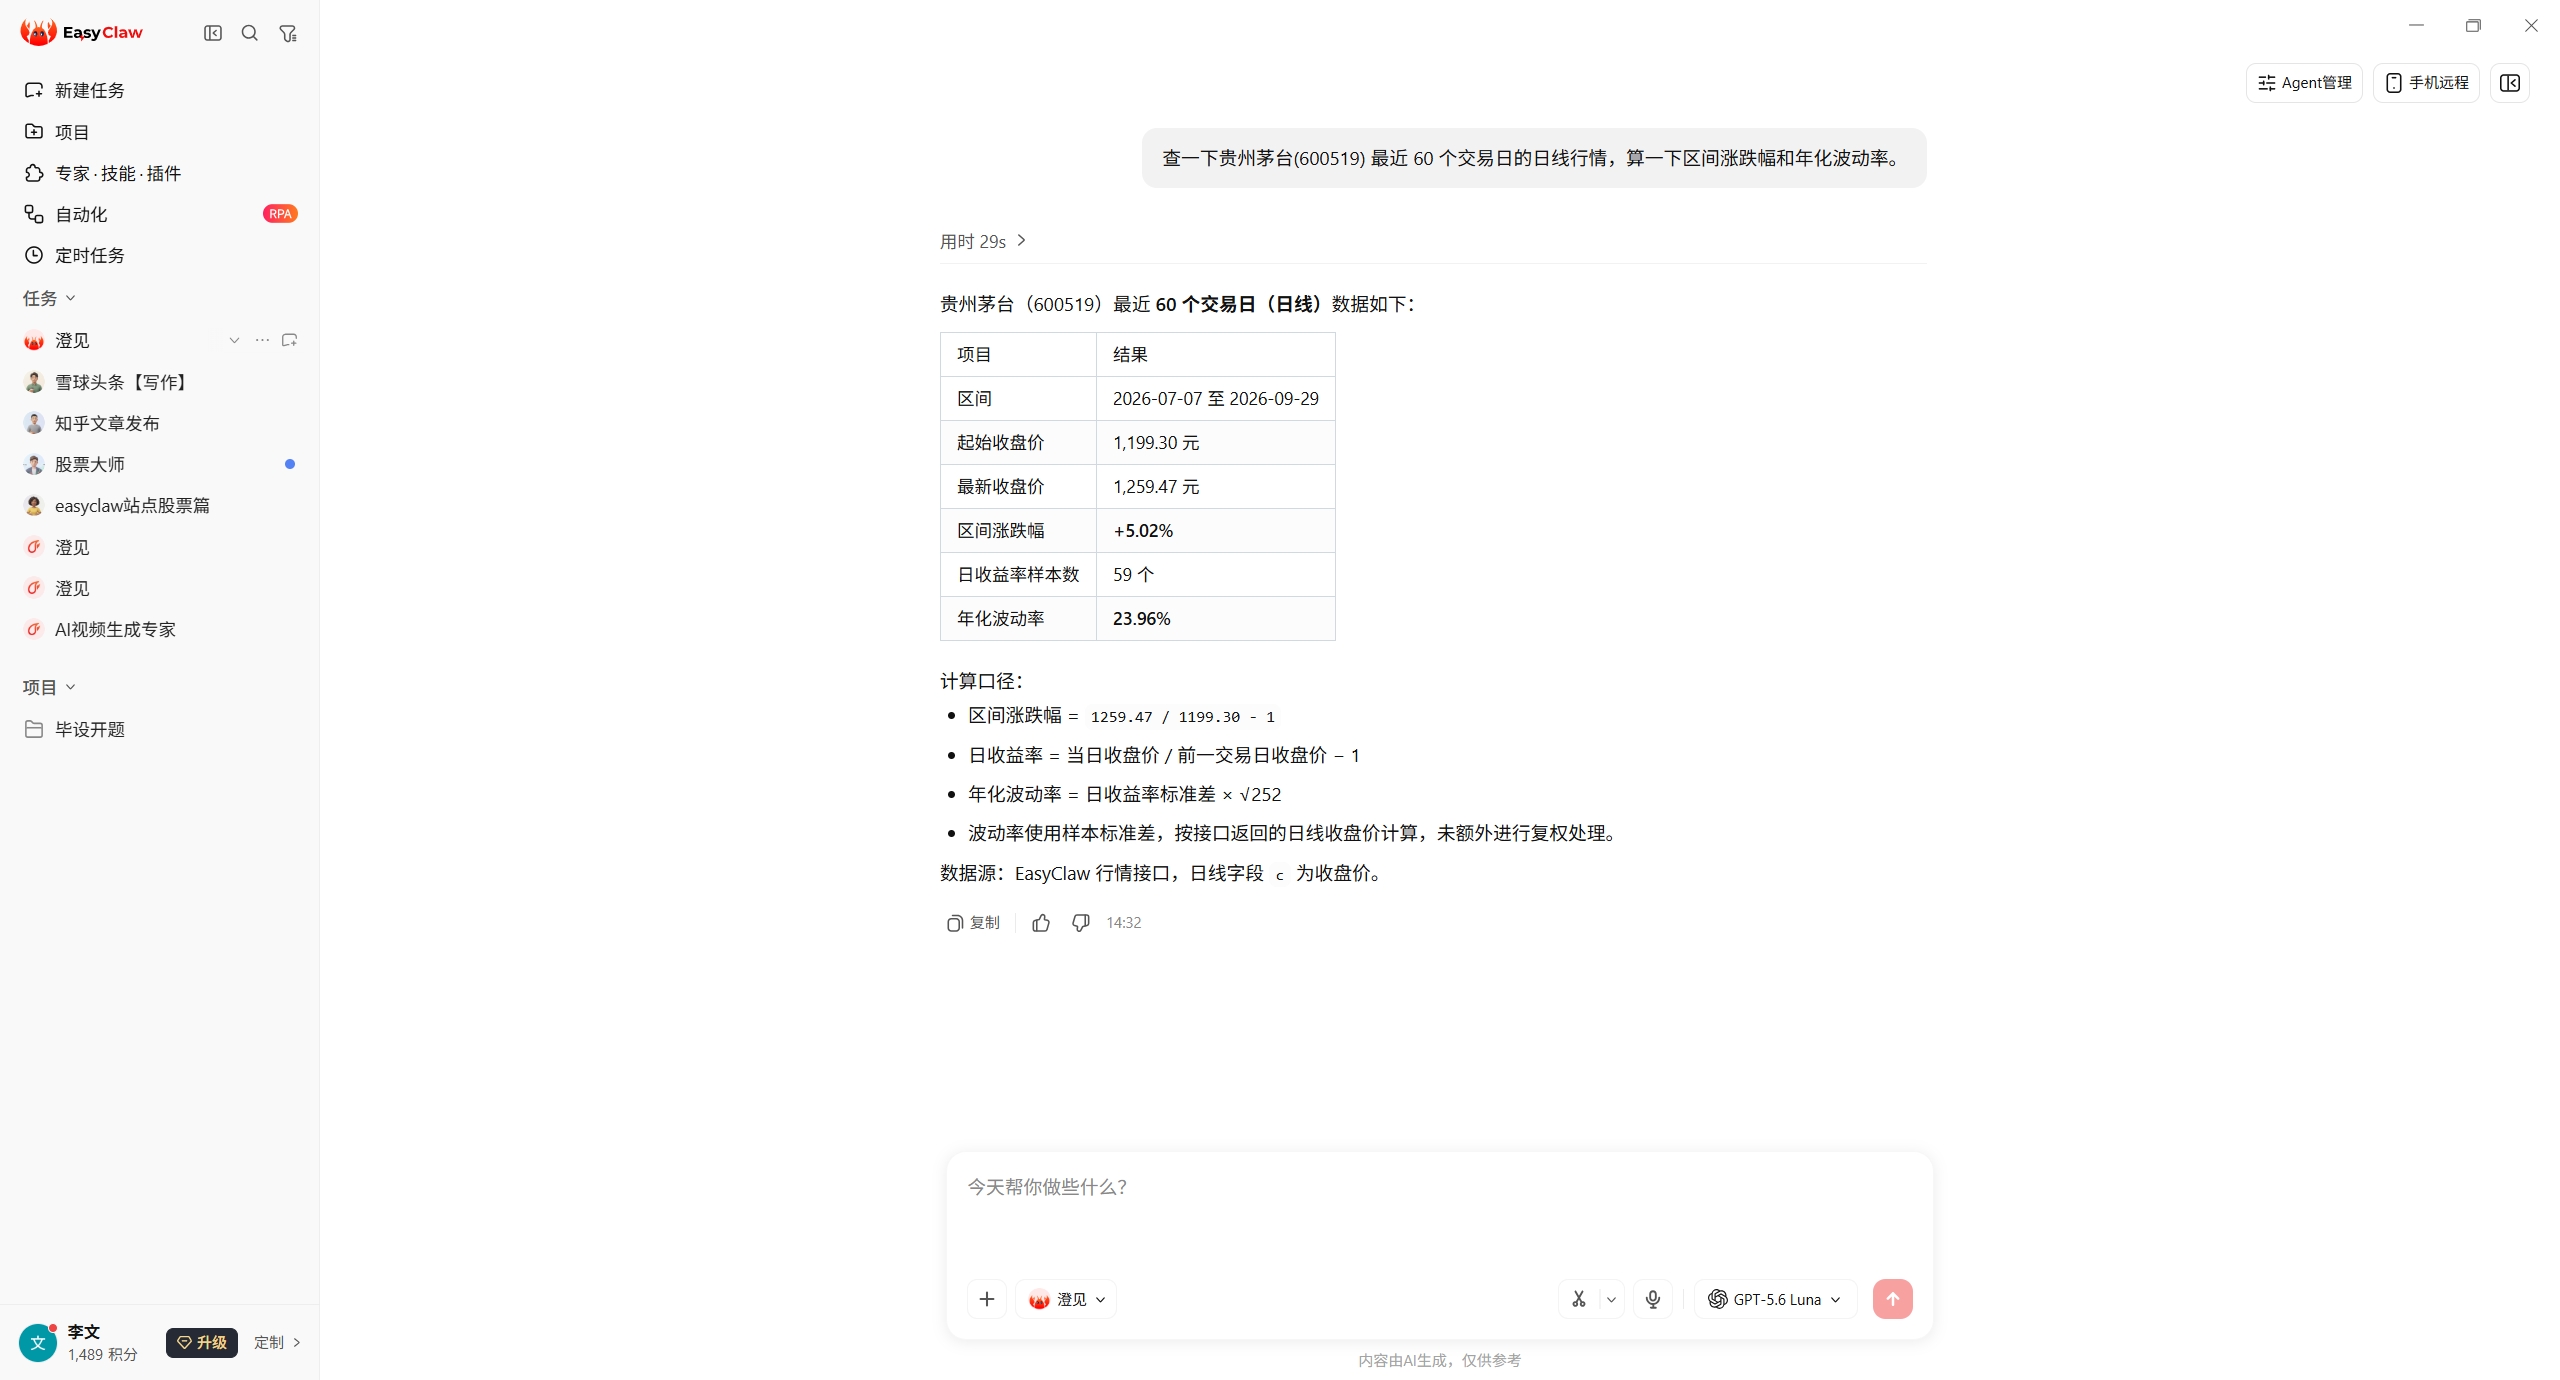
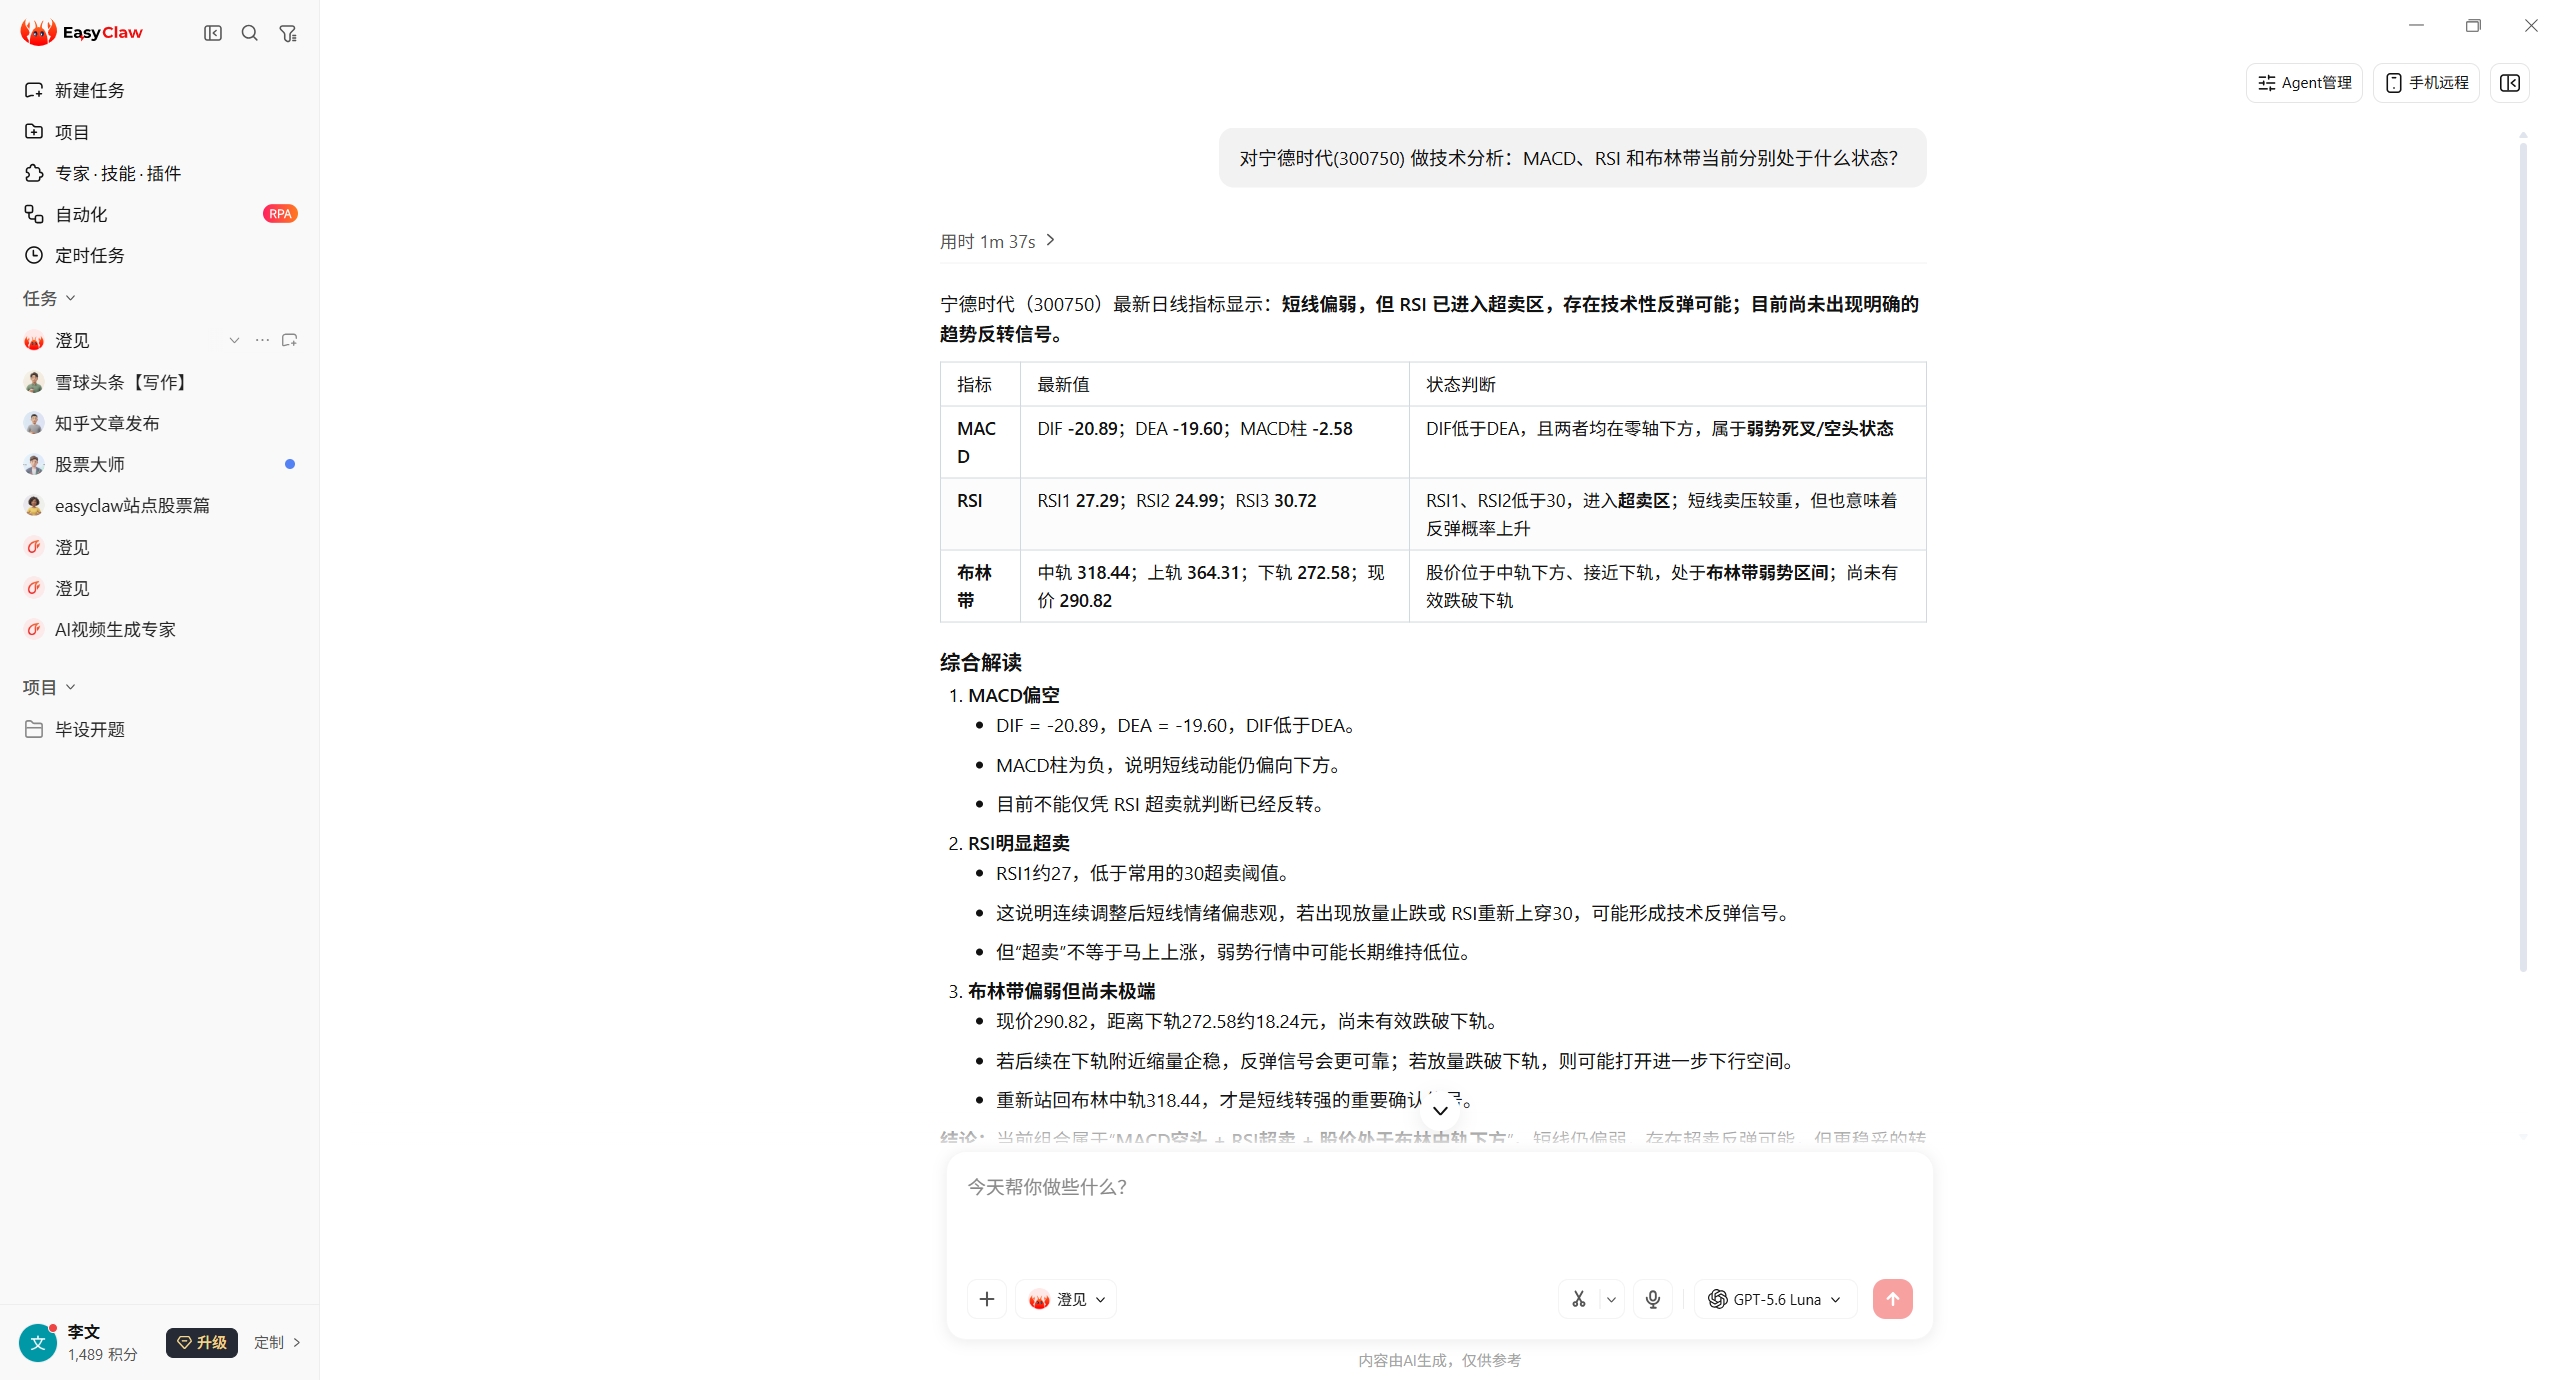
这两张是本机技能路线的实拍,不是 StockSight 的运行结果:图中的数据来自 EasyClaw 的行情接口,StockSight 老版依赖的是 Yahoo 行情接口与 Elasticsearch 索引,两套数据源没有任何调用关系。把它们放在这里,是为了让你先看清「免部署路线一次对话能拿到什么」,再决定要不要投入时间去修自建那条路线的依赖。
看这两张图时,建议把注意力放在三处,而不是数字本身:一是口径有没有被写出来——第一张把「日收益率 = 当日收盘价 ÷ 前一交易日收盘价 − 1」「年化波动率 = 日收益率标准差 × √252」两条公式都列了出来,第二张则写明 RSI 的具体取值与超卖阈值;二是边界有没有被承认——第二张主动补了一句「超卖不等于马上上涨」;三是数据源有没有被交代——第一张写了字段含义(日线字段 c 为收盘价)。这三点恰好对应本站「信号审计」页的四道检查,也是判断任何一份自动生成的分析能不能采信的主要依据。
反过来说,这两张图也不能用来证明这条路线更准:样本只有一只股票、一个时间段,没有样本外检验,也没有交易成本。它们证明的只有一件事——免部署路线今天确实能产出结构清晰、口径可查的结果,而这正是自建路线需要你先修好四层依赖才能达到的起点。
最后给一个可执行的对照动作:把上面任意一个数字自己复算一遍。例如第一张里的区间涨跌幅,用起止两天的收盘价相除再减一,一分钟就能验证;年化波动率则需要先算出每日收益率序列再取标准差。能自己算出来,说明这份输出至少口径是自洽的;算不出来,就该先问清楚它的公式与数据来源,再谈要不要采用。
什么人适合用 StockSight,什么人别碰
下面每一个「适合」都对应本站的一个页面,每一个「不适合」都能在正文里找到理由。
适合:想研究舆情平台架构
你关心的是「推文和新闻标题怎么落库、怎么用 Kibana 看情绪分布」,愿意自己起 Elasticsearch 与 Kibana。老版路线给你一套 2017 年设计、组件职责清晰的样本。
先看「链路解剖」,再决定要不要真的装。
适合:要给 Agent 一行结果
你想要的是一句「这只票最近新闻偏正还是偏负」,或者一份带来源链与可信度标签的报告,不想维护数据库。两个 Skill 路线更贴近这个需求。
注意:两个 Skill 仓库当前 Star 均为 0,社区验证接近于零。
不适合:想靠情绪分数下单
本机实测里,10 条中文财经标题在旧算法下全部被判为中性;英文标题里「申请破产保护」也被判中性。把它当交易信号会直接踩坑。
先读「情绪模型」与「信号审计」两页再决定。
三张卡片对应三种完全不同的验收标准:研究架构看的是数据模型是否清晰,要 Agent 结果看的是输出是否可复现,做交易决策看的是信号是否通过样本外检验。先确定自己属于哪一类,再看对应页面,能省掉大量无效阅读。
中文资料里的哪些说法与实际不符
下面左列是搜索时最常看到的表述,右列是本站按官方文件与本机实测得到的结论。每一条都能在证据清单里查到出处。
| 中文资料里的常见说法 | 本站核验结论 | 依据 |
|---|---|---|
| 「基于 Elasticsearch、Twitter 和新闻标题做股票预测」 | 前半句对,后半句没有代码支撑:仓库内没有预测模型、训练代码或回测代码 | 24 个文件的完整清单 |
| 「用 TextBlob 和 VADER 做情绪分析,效果不错」 | 确实用这两个模型,但本机实测在 20 条中英财经标题上有明显漏判,中文全部落中性 | 本机实测分值表 |
| 「装上就能用,有 Docker 一键启动」 | 官方给了 docker-compose,但本机在 pip 解析阶段就失败;Docker 路径因本机无 Docker 未验证 | 本机安装日志 |
| 「支持 A 股」 | 老版没有任何 A 股数据源与中文分词;只有两个 Agent Skill 路线补上了 A 股 | 依赖清单与源码扫描 |
| 「项目还在维护」 | 老版最后推送 2023-12-05、CHANGELOG 停在 2020-06;两个 Skill 仓库分别在 2026-05 / 2026-06 后无新提交 | GitHub API 与三个仓库的提交记录 |
这五条并不是要否定这个项目。它的索引设计、字段结构与「把可确认 / 推导 / 历史计算 / 不可用写在报告上」的思路,放到今天依然值得借鉴,问题只出在这些说法把「设计意图」当成了「当前可用状态」。
判断一个开源项目今天能不能用,本站建议顺序固定为四步:①看依赖清单里有没有「多年未更新的包」(老版有,而且不止一个);②看核心依赖有没有钉版本(老版只钉了 elasticsearch,结果 tweepy 被解析到不兼容的 4.x);③看仓库自己有没有 CI 与实际跑得通的测试命令;④看许可证文件是否齐全。这四步不需要读一行源码,几分钟就能完成,却能过滤掉大部分「看起来能用」的项目。
关于 StockSight,最常被问到的八个问题
下面这些问题都来自真实检索与实测过程;每条答案都标了依据来源与边界,口径与测试环境见本页「本站的做法」一节。
StockSight 和 StockSight-Skill 是同一个项目吗?
不是。三个仓库只共享名字:shirosaidev/stocksight 是 2017 年的 Elasticsearch 舆情平台(约 2.5k Star,Apache-2.0),gaaiyun/stocksight-skill 与 GearVoid/StockSight-Skill 是 2026 年两个 Agent Skill 仓库(Star 均为 0)。它们的语言都是 Python,但技术栈、依赖与产出物完全不同,也没有代码继承关系。以各仓库自身文件为准。
它能预测股价吗?
不能。仓库描述里出现了 predictor 一词,但 24 个文件的清单里没有任何预测模型、训练代码或回测代码,实际做的是「抓取文本 → 情绪打分 → 存进 Elasticsearch → Kibana 可视化」。本站不采信任何「精准预测涨跌」的表述,以官方实现为准。
现在照着 README 能装好吗?
大概率不行。本机在 Windows + Python 3.11.9 + pip 24.0 的全新隔离环境里实测:pip install -r requirements.txt 直接失败(metadata-generation-failed),且失败点有四层。正确顺序与完整报错原文写在「安装与运行」与「报错库」两页,以官方 requirements.txt 与各依赖的当前发布状态为准。
情绪分析的结果准不准?
取决于语言和模型。本机对 10 条中文财经标题做了实测:旧算法(TextBlob 与 VADER 取平均)全部判为中性;SnowNLP 能分出 4 正 5 负,但会把「拟回购股份」判成负面。英文侧,VADER 把「申请破产保护」判为中性。任何模型都不能单独支撑交易决策,以各模型自身文档为准。
本站和 EasyClaw 是什么关系?
EasyClaw 提供的是本机可安装的金融 AI Skill 路线(如资讯检索、异动监控、行情取数)。本机 29 个技能目录里没有任何一个是专门的新闻情绪打分技能,也没有覆盖 Elasticsearch 舆情仓库与仪表盘。StockSight 与 EasyClaw 无已证实集成,本站在对比页只做能力对照。以各 Skill 的官方说明为准。
为什么本站没有运行截图?
因为关键界面(Elasticsearch、Kibana 仪表盘)需要 Docker 起两个 5.6 版容器,而本机没有安装 Docker;Twitter 侧凭据在当前条件下也不可用。按「不伪造证据」原则,本站只用两类图:可复现的 GitHub 仓库页截图,以及明确标注为「示意图 / 示例输出」的结构图。所有实测结论都以命令日志与产物文件形式留档。
三个仓库里,哪一个是「官方」的?
没有官方与非官方之分,它们是三个独立作者的项目,只是重名。如果按流行度看,shirosaidev/stocksight 有约 2.5k Star 与 Apache-2.0 许可;另外两个仓库的 Star 均为 0。但 Star 只说明关注度,不说明今天的可用性——真正该看的是它的依赖清单、最后提交时间与许可证文件是否齐全。
本站的结论会不会很快过时?
会,而且这是有意的。所有实测结论都绑定了明确的环境(Windows / Python 3.11.9 / pip 24.0)与日期(2026-09-30),因为同一份依赖清单在不同 Python 版本下的解析结果完全不同。依赖升级、包被修复或仓库重新活跃,都会让安装页与报错库的结论失效。核对时请以你运行时的实际输出为准。
我想把情绪分数用在自己的选股流程里,从哪一页开始?
从「情绪模型」看分数的真实表现,再从「A 股适配」处理时间对齐与去重,最后用「信号审计」的四道检查判断它值不值得进入流程。跳过前两步直接做回测,多半会得到无法复现的结果——原因在信号审计页的「常见翻车点」里逐条列了。