几十行验证一个想法
把策略写成几十行 Python,用历史 OHLCV 数据跑一遍,就能看到净值、回撤与胜率等统计。它适合先判断「这个想法值不值得继续做」,而不是直接拿去交易;统计口径以官方实现输出为准。
Backtesting.py / kernc
Backtesting.py(kernc/backtesting.py)是一个用 Python 回测交易策略的开源库,它把「写策略、跑历史数据、看统计、扫参数、画交互图」压缩成 Backtest + Strategy 两个类。本站不翻译官方文档,而是把「能跑通」和「结果可信」分成两件事:一边给可复现的最小代码,一边用本站实测告诉你同一份代码在不同成本、口径与时点假设下能差多少——实测中 6 只 A 股样本 0 只跑赢买入持有,98 组参数在样本内 89 组赚钱、样本外 0 组赚钱。
项目页面显示约 8.9k Star / 1.5k fork;该数字会随社区活动变化,采集日期为 2026-09-08。
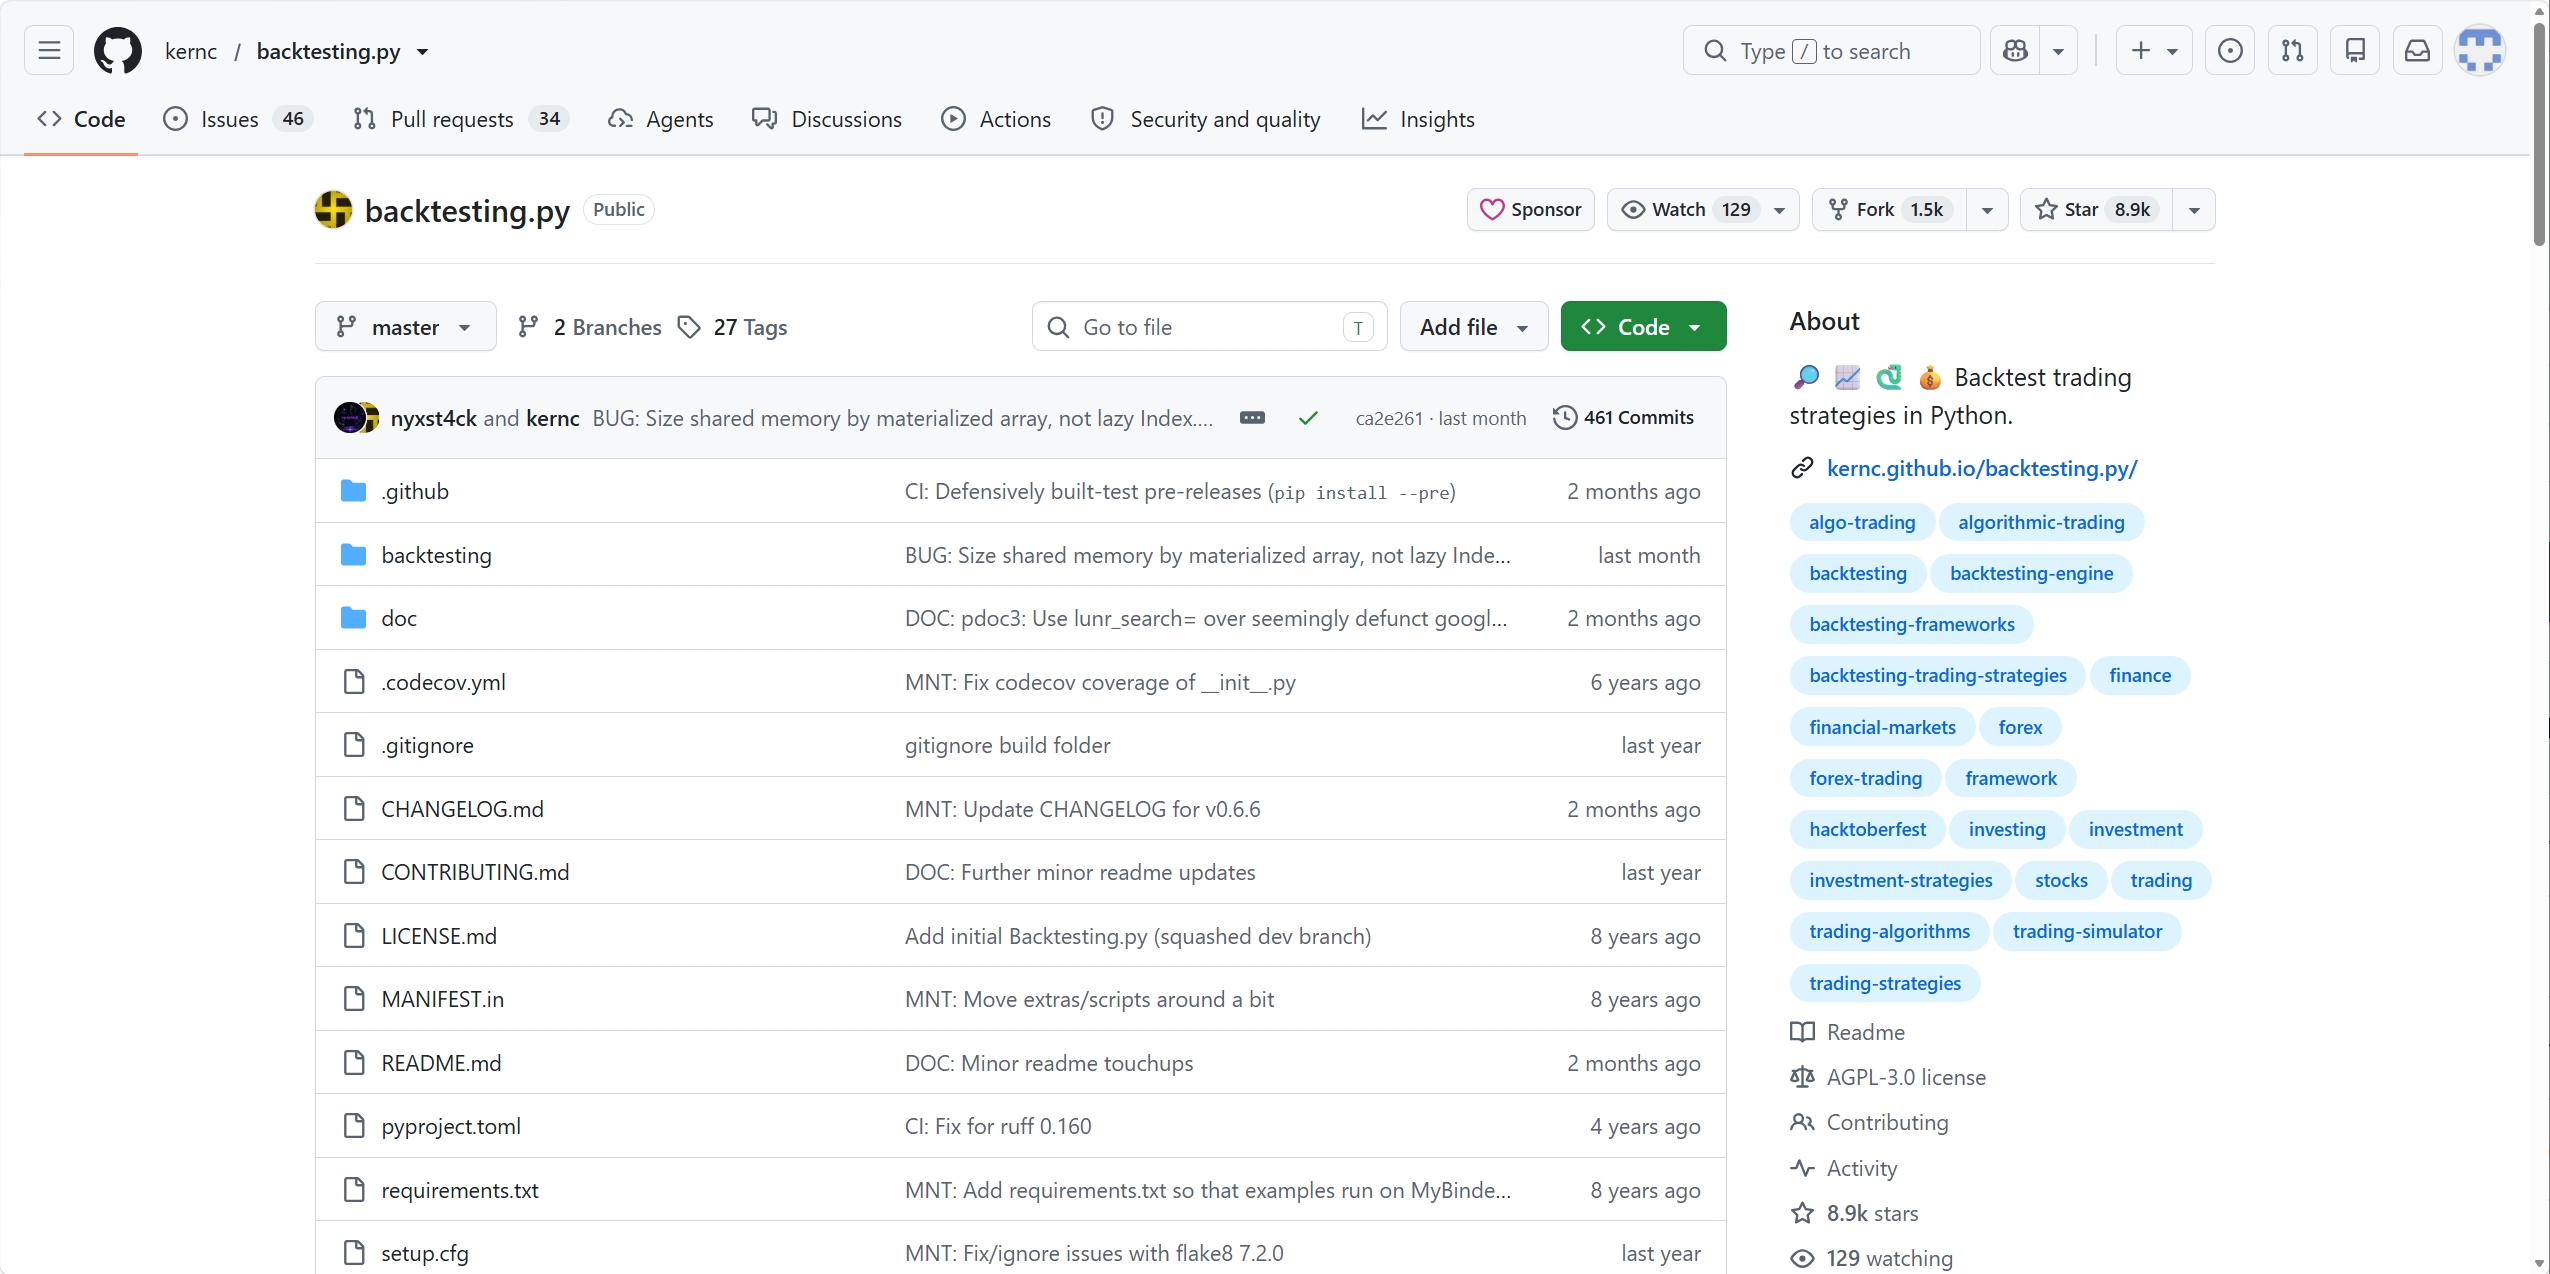 查看固定版本源码
它把「策略想法 → Python 策略类 → 历史数据回测 → 参数优化与结果评估」整理成一条可复现的量化研究链路,让单标的策略验证变得轻量:不用自己写撮合与统计,但仍要自己写策略、备数据、看结果。
把策略写成几十行 Python,用历史 OHLCV 数据跑一遍,就能看到净值、回撤与胜率等统计。它适合先判断「这个想法值不值得继续做」,而不是直接拿去交易;统计口径以官方实现输出为准。
内置优化器可以对策略参数做网格搜索,并用热力图呈现不同参数组合的表现。要看的重点是参数邻域是否稳定成片,而不是单个最高点——孤立的高点通常只是历史偶然。
基于 bokeh 输出交互式图表,买卖点会标在价格曲线上,可以缩放和悬停查看每笔交易;回测结果同时以 Series / DataFrame 返回,方便自己写二次绩效统计。
指标库无关:talib、pandas 或自己写的函数算出的指标都能直接喂进策略。代价是数据质量、复权口径与指标正确性需要你自己负责,出错时也不会替你做数据体检。
下面四步按顺序做,每步都给出真实命令或代码、一句话说明与可验证的预期结果。命令与参数取值以官方 README 与文档为准,替换标的与区间即可复现。
用 pip 安装,之后先确认能导入再往下走。官方 README 与 PyPI 标注了 Python 版本与依赖要求,换环境或换 shell 时以官方说明与实际终端提示为准。
pip install backtesting
python -c "import backtesting; print('ok')"预期:安装过程没有报错,第二条命令打印出 ok。若这一步失败,多半是 Python 版本或依赖冲突,先按官方 README 核对环境,别急着往下写策略。
需要一份带时间索引、含 Open / High / Low / Close / Volume 列的 DataFrame。库内置了示例数据便于跑通流程;换成自己的数据时,列名大小写与索引类型要自己核对。
from backtesting import Backtest
from backtesting.test import GOOG

print(GOOG.tail())预期:打印出末尾若干行「日期 → 开高低收量」。字段名与内置示例的可用性以你安装的版本为准;用自备数据时,常见的失败是索引不是时间类型或缺少 Volume 列。
继承 Strategy 类,在 init 里算指标、在 next 里写买卖逻辑,然后把数据、策略与资金参数交给 Backtest。注意 next 是「逐根 bar 调用」,逻辑要按当时能看到的信息来写。
from backtesting import Strategy

class SmaCross(Strategy):
    def init(self):
        self.ma1 = self.I(SMA, self.data.Close, 10)
        self.ma2 = self.I(SMA, self.data.Close, 20)
    def next(self):
        if crossover(self.ma1, self.ma2):
            self.buy()
        elif crossover(self.ma2, self.ma1):
            self.sell()

stats = Backtest(GOOG, SmaCross, cash=10000, commission=.002).run()预期:run() 返回一份统计结果,可以按名字取到收益、回撤、交易次数等字段。字段名与计算口径以官方实现为准;结果出现明显异常时,先回头查数据与信号逻辑,而不是先怀疑统计。
把想扫的参数交给内置优化器,用热力图看不同组合的表现;再画出交易图检查买卖点是否符合预期。这两步是「从跑通到能用」的分界线。
stats = bt.optimize(ma1=range(5, 20, 5), ma2=range(20, 60, 10))
bt.plot()预期:得到一组参数结果与一张交互式图表。参数名、取值范围写法与返回结构以官方 API 文档为准;扫描结果只代表历史区间表现,需要用样本外区间复核,也不构成投资建议。
下表按「能力 / 具体做法 / 适用场景 / 注意点」整理,判断列写的是使用条件而不是功能宣传;默认值与字段名一律以官方 README 与 API 文档为准。
| 能力 | 具体做法 | 适用场景 | 注意点 |
|---|---|---|---|
| 策略编写 | 继承 Strategy 类,init 算指标、next 写买卖逻辑 | 规则明确、可用代码描述的单标的策略 | next 逐根 bar 调用,逻辑要按当时可见信息写 |
| 回测执行 | Backtest 接收数据、策略与资金、佣金等参数,run 出统计 | 快速判断一个想法是否值得继续 | 参数名与默认值以官方 API 文档为准 |
| 参数优化 | 内置优化器对参数做网格搜索,配合热力图观察 | 寻找稳定的参数区间而非单点最高 | 网格越大越容易过拟合,需样本外复核 |
| 可视化 | 基于 bokeh 输出交互式图表,标注买卖点 | 人工检查信号是否出现在合理位置 | 需要浏览器环境,图多时注意输出体积 |
| 指标接入 | 指标库无关,talib 或 pandas 自算指标都能接入 | 已有自己的指标代码或研究习惯 | 第三方指标库需单独安装,版本需自行核对 |
| 结果返回 | 统计结果以 Series / DataFrame 形式返回 | 写自定义绩效统计或批量对比实验 | 字段与口径以官方实现输出为准 |
| 数据输入 | 任意 OHLC(V) 蜡烛数据,单资产 | 日线或更小周期的单标的回测 | 数据自备,复权口径与缺失值需自己处理 |
| 许可 | AGPL-3.0 | 学习、研究、内部验证 | AGPL 有传染性,商用集成前先读官方 LICENSE |
下表是本站用同一套双均线策略(SMA 10/20)在官方内置样例与真实 A 股、港股上跑出来的结果。它回答的是最具体的问题:这套规则在真实市场上到底跑赢还是跑输?
| 样本 | 策略收益 | 买入持有 | 交易笔数 | 结论 |
|---|---|---|---|---|
| 官方内置 GOOG(2004-08-19~2013-03-01) | +469.86% | +607.37% | 94 | 跑输基准 137.51pp(官方样例本身就跑输) |
| 贵州茅台 600519(A 股成本) | -69.16% | +107.61% | 123 | 在长牛标的上大幅亏损 |
| 贵州茅台 600519(零成本) | -64.44% | +107.61% | 123 | 去掉成本仍巨亏:不是费用问题 |
| 贵州茅台 600519(收盘成交假设) | -35.22% | +107.61% | 123 | 只改成交时点就差 33.94pp |
| 腾讯 00700(零成本) | +5.03% | +1.43% | 113 | 看似跑赢,但优势只有 3.6pp |
| 腾讯 00700(计费用) | -20.91% | +1.43% | 113 | 计入费用后「跑赢」消失 |
| 宁德时代 300750(6 只里收益居前的一只) | +319.46% | +725.90% | 113 | 看似翻三倍,实际仍跑输基准 406pp |
| 6 只 A 股整体(前复权 + A 股成本) | 0 只跑赢 | 6 只全为正 | 平均 119 | 这套规则在 A 股上没有稳定优势 |
下面八条对应使用 Backtesting.py 时最常见的需求与误解,先做一次自检能省掉装完才发现方向不对的时间。
| 你的需求 | 是否适合 | 说明 |
|---|---|---|
| 验证单标的规则策略(均线、突破、通道) | 适合 | 结构与官方示例一致,几十行代码即可跑通 |
| 做多资产组合、跨品种对冲 | 不适合 | 官方说明不支持多资产组合,需换组合类框架 |
| 需要分数股或按比例分批建仓 | 不适合 | 官方说明不支持分数股交易,下单数量按整股处理 |
| 先判断一个想法值不值得继续 | 适合 | 回测与统计开箱可用,前期成本低 |
| 扫描参数并看稳定性 | 适合 | 内置优化器与热力图,注意样本外复核 |
| 需要 tick 级或特殊撮合规则 | 不适合 | 面向 bar 级回测,撮合假设偏向简化 |
| 沿用自己现有的指标代码 | 适合 | 指标库无关,可接 talib 或 pandas 自算 |
| 不想写代码,只要一句结论 | 不适合 | 它是库不是软件,需写 Python;可参考本站技能路线 |
下面六个案例都来自本站实测,按「现象 → 实测证据 → 教训」排列。它们的共同点是:代码没错、结果能跑出来,但结论不可信。
| 失败案例 | 实测证据 | 教训 |
|---|---|---|
| 双均线在真实市场上跑输买入持有 | 6 只 A 股 0 只跑赢,5 只亏损;官方 GOOG 样例也跑输 137.51pp | 先做基准对照,再看绝对收益 |
| 「跑赢」被交易成本吃掉 | 腾讯 00700:零成本 +5.03% 对基准 +1.43%,计入费用 -20.91% | 成本不是尾部修正,它可能翻转结论 |
| 样本内漂亮、样本外失效 | 98 组参数:样本内 89 组赚钱,样本外 0 组赚钱;样本内收益最高的那一组 +461.23% → 样本外 -22.86% | 参数要过样本外,否则只是历史巧合 |
| 复权口径改变结论 | 同一策略:前复权 -69.16%/基准 +107.61%;不复权 -71.90%/基准 +70.73%(差 36.88pp) | 口径必须写进结论,否则无法复现 |
| 执行时点假设支配结果 | 同策略同标的:默认撮合 -69.16%,trade_on_close=True -35.22%(差 33.94pp) | 把「按哪个价格成交」当结论的一部分 |
| 用了未来信息却更好看 | 全序列 z-score -65.21% vs 扩展窗口 -93.91%,差 +28.70pp,且无任何报错 | 前视偏差是静默的,必须自查 |
下面八行是本站各组实测的复现清单。它回答的不是「收益多少」,而是「换一个人来跑,需要知道哪些条件才能得到同一个数量级的结果」。数据、成本与口径三项缺任何一项,数字都不可比。
| 实验 | 数据与区间 | 数据获取方式 | 策略与假设 | 输出物 | 已知局限 |
|---|---|---|---|---|---|
| 官方样例基线 | 内置 GOOG,2004-08-19~2013-03-01 | from backtesting.test import GOOG,无需联网 | SmaCross(10/20)、cash=100000、commission=0.002 | 统计 Series、交易明细、HTML 图表 | 只用于验证 API 与链路,不代表任何市场表现 |
| 6 只 A 股双均线 | 2018-01-02~2026-09-18 日线前复权 | 新浪接口按代码取日线,落地为本地表后读入 | SmaCross(10/20)、A 股成本 callable、exclusive_orders=True | 逐标的收益 / 基准 / 笔数、权益曲线 | 样本只有 6 只,区间固定,未覆盖退市股 |
| 港股对照(00700) | 同期日线前复权 | 同上,港股代码单独取数 | 同一策略与同一成本口径 | 零成本 / 计费用两版结果 | 港股交易规则与 A 股不同,成本假设只做近似 |
| 成本敏感性 | 600519,同一区间 | 复用上表的本地数据 | 成本从 0 加到 20bp(佣金 / 印花税 / 过户费分项) | 四档成本下的收益与费用总额 | 只有佣金与税费,不含冲击成本与排队损失 |
| 成交时点对照 | 600519,同一区间 | 复用上表的本地数据 | 默认撮合 vs trade_on_close=True | 两版收益与笔数对照 | 两种口径都只是近似,真实成交还取决于盘口 |
| 复权口径对照 | 600519,同一区间 | 同一接口分别取前复权与不复权 | 策略与成本保持不变,只换数据口径 | 收益 / 基准双口径对照 | 不复权数据含除权跳空,与真实可交易价格并不等同 |
| 参数网格与样本外 | 样本内 2018-01-02~2022-12-30,其后为样本外 | 复用本地数据,按日期切分 | n1 / n2 网格 98 组,maximize 用默认目标 | 参数热力图、样本内 / 样本外收益对照 | 只做一次切分,非 walk-forward;网格范围有限 |
| A 股规则模拟 | 6 只 A 股,同一区间 | 本地数据 + 交易日历 | T+1、涨跌停与停牌的可成交判定 | 不可成交笔数与当日往返笔数 | 用当日 OHLC 阈值近似,一字板与部分成交无法还原 |
exclusive_orders=True + finalize_trades=True。数据用新浪接口日线(前复权)落地为本地表,策略规则、成本 callable 与区间都写在对应表格附近;原始脚本与输出随本项目研究材料归档(lab/ 目录),未随网页发布。未实测的部分(幸存者偏差、冲击成本、实盘成交差异)已在对应页面标注为「本站未实测」,只给方法与检查清单,不做数字层面的推断。同一个研究目标,两条路线的准备成本差别很大:一条是把环境与代码都握在自己手里,另一条是先拿到结论再决定要不要自建。
换来的是完整可控:策略、数据、成本假设都能改,结果可复现、可版本管理;代价是环境、数据与指标都要自己维护,出错时也要自己排查。
# 最小链路
pip install backtesting

class SmaCross(Strategy):
    def init(self):
        self.ma1 = self.I(SMA, self.data.Close, 10)
        self.ma2 = self.I(SMA, self.data.Close, 20)
    def next(self):
        if crossover(self.ma1, self.ma2):
            self.buy()

bt = Backtest(GOOG, SmaCross, cash=10000, commission=.002)
bt.run()本机已核验的量化相关技能覆盖行情数据、技术分析、条件选股与风险指标等方向,但数据源、Token、网络与市场覆盖各不相同;它不能替代自建回测库的可复现性,也不代表本项目已被其收录或可在其中调用。
前置条件:需先安装客户端;部分数据源需要 Token 或账号;输出仅供研究,不构成投资建议。
下面这张截图来自本机对话的真实使用,用于对照 Backtesting.py 自建路线「装环境 + 写策略 + 备数据」的准备成本;它演示的是技能路线,不是本项目的运行结果。
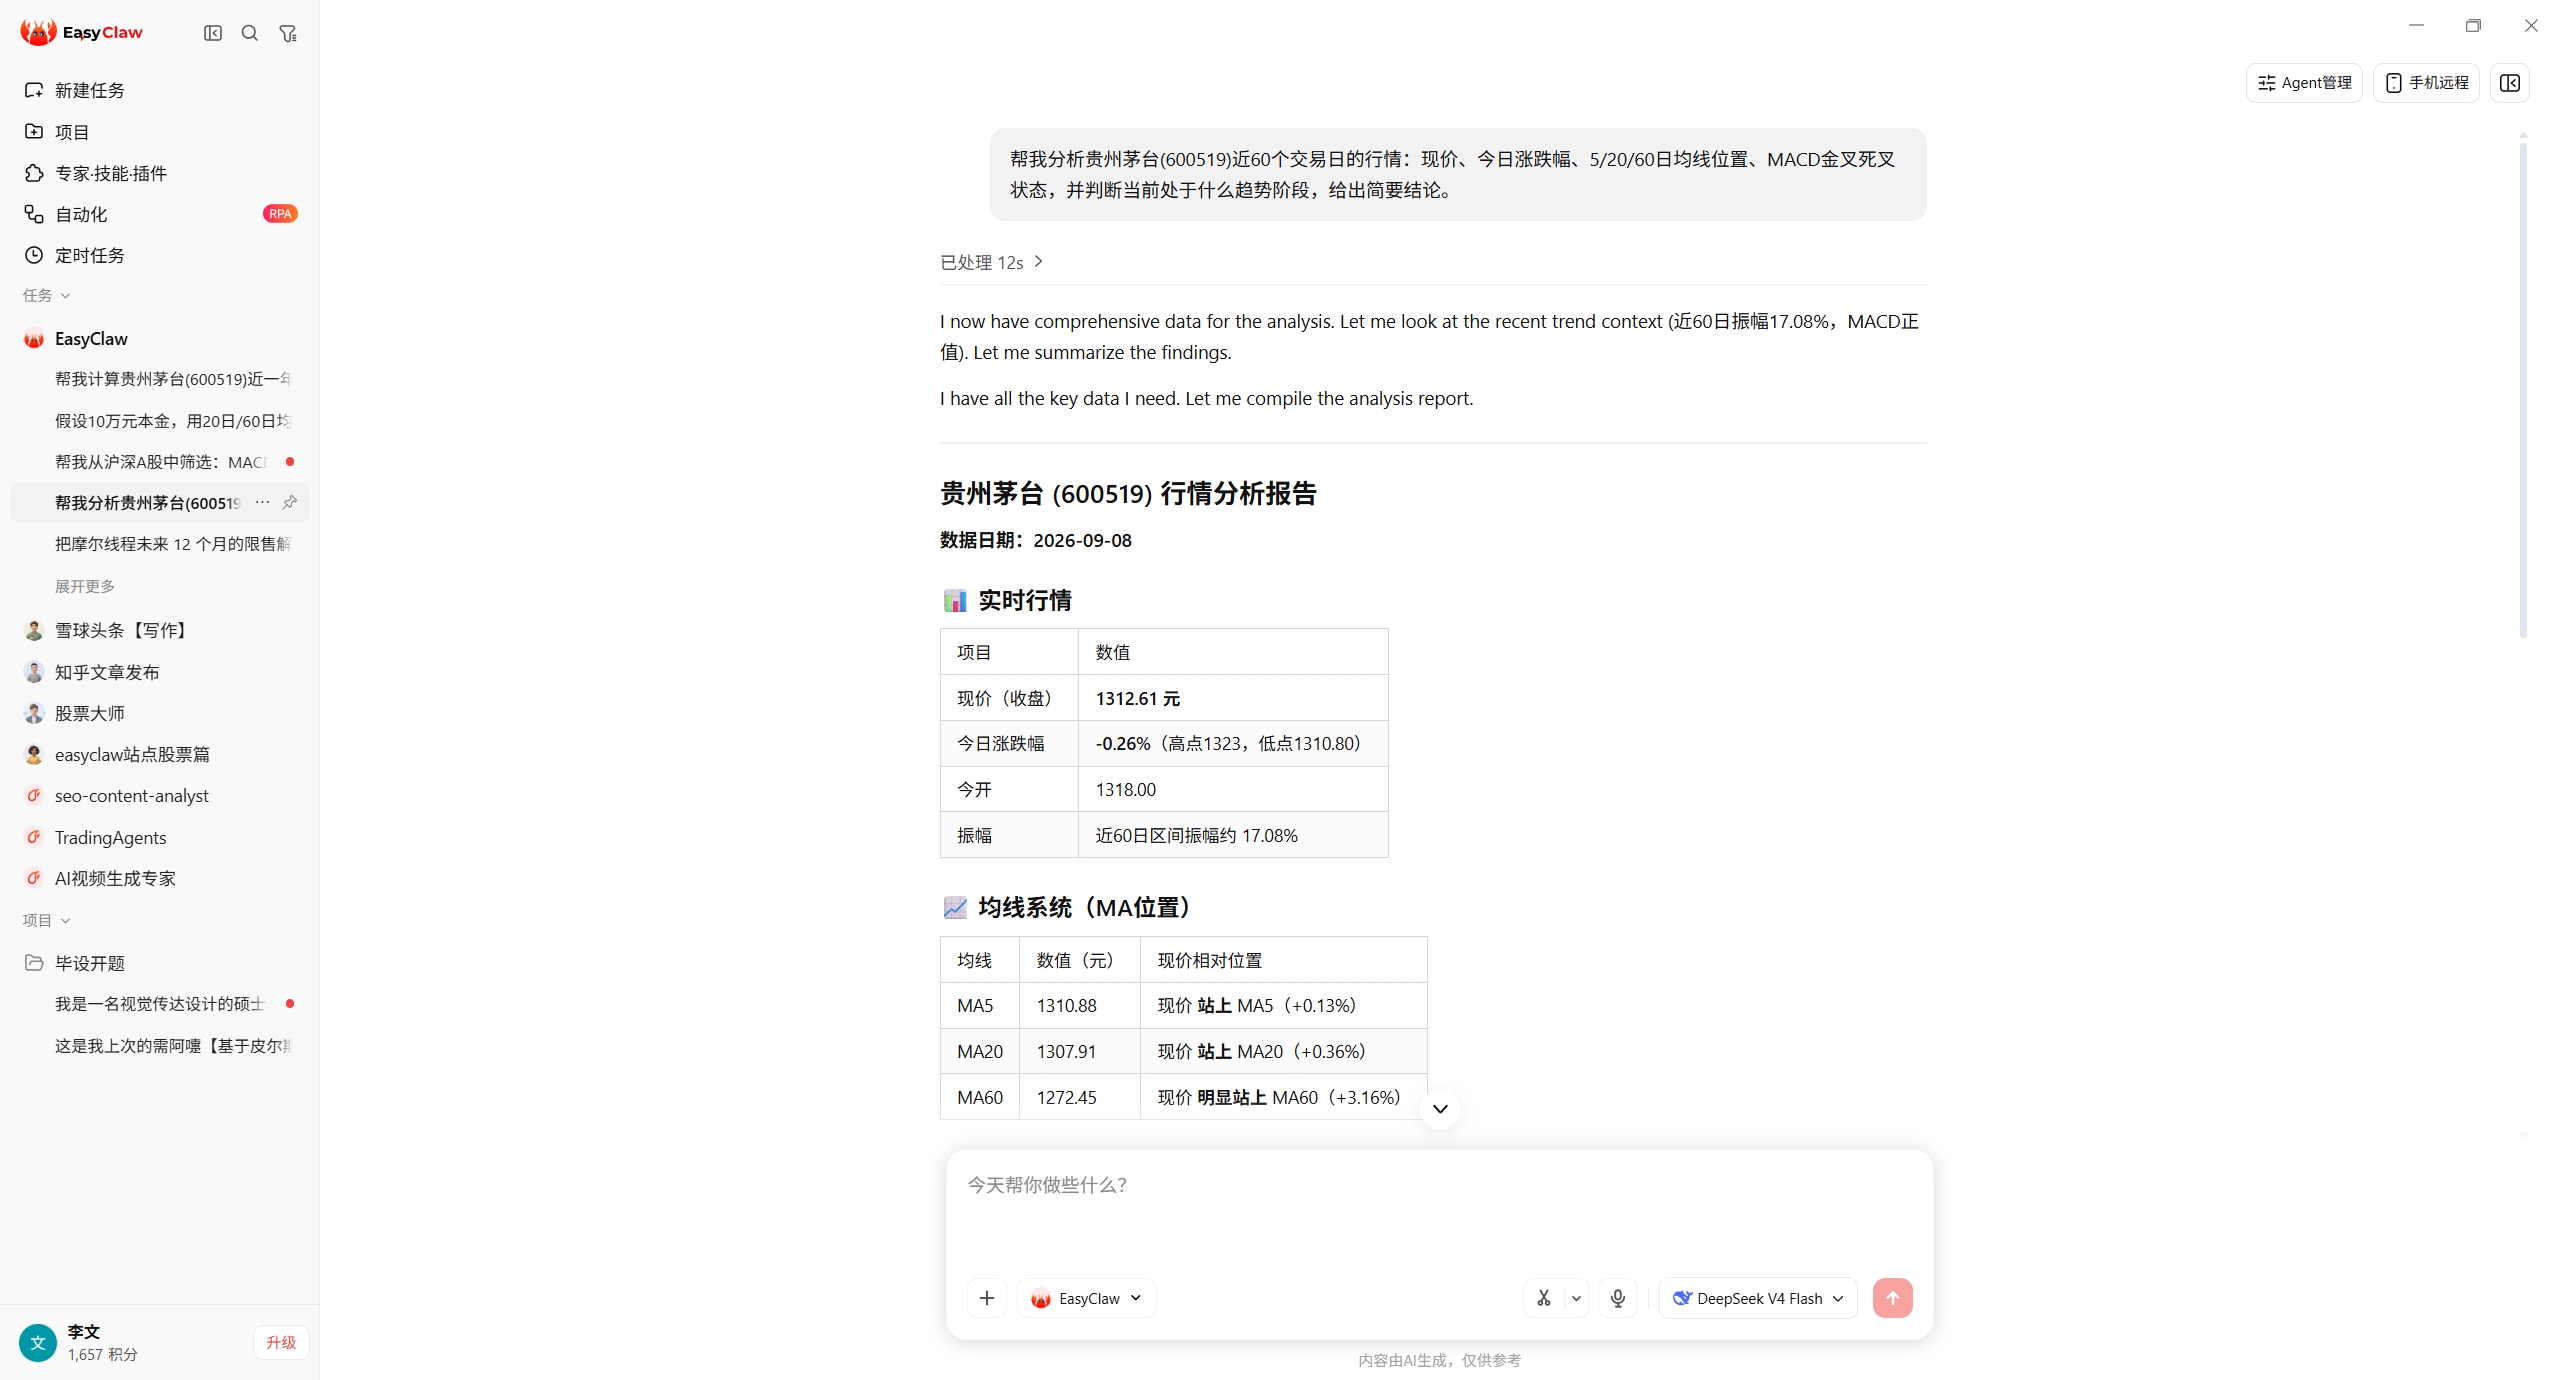
| 能替代的准备工作 | 大致覆盖方式 | 前置条件 |
|---|---|---|
| 拿一段历史行情 | 直接描述标的与区间,返回行情与涨跌统计 | 安装客户端;部分数据源需 Token 或账号 |
| 看技术面状态 | 让对话给出均线、MACD、RSI、布林带等状态描述 | 覆盖范围以该技能说明为准,部分技能仅覆盖 A 股 |
| 按条件筛股票 | 描述条件(如均线金叉、放量、市值区间)得到候选名单 | 结果需自行复核,不构成投资建议 |
| 算风险指标 | 给出年化收益、回撤、波动率等指标摘要 | 口径与区间以对话中实际使用的数据为准 |
| 先验证一个策略想法 | 用自然语言描述买卖规则,返回收益与回撤概况 | 不等于可复现回测,结论需谨慎对待 |
| 把研究固化成代码 | 不能替代:仍需自己写策略与回测脚本 | 可复现性、版本管理与成本假设都要自建 |
下面按常见目标给出推荐顺序。前三行是「把回测先跑起来」,后三行是「让结论经得起追问」,最后两行针对 A 股与选型。
| 你的目标 | 建议顺序 | 为什么 |
|---|---|---|
| 先把环境装好 | 下载部署 → 装完自检 | 版本与依赖口径不对,后面所有数字都不可比 |
| 10 分钟看到一次回测结果 | 首次运行 → 真实数据版本 | 先用内置样例跑通,再换成自己的数据 |
| 理解代码结构 | 两类 API → 策略循环 | 先分清引擎与策略的分工,再看 init/next 的调用时机 |
| 判断自己的结论可不可信 | 回测可信度审计 | 未来函数、过拟合、成本、基准与统计口径逐项自查 |
| 让策略在 A 股上不失真 | A 股规则适配 | T+1、涨跌停、整手、印花税与复权口径如何处理 |
| 搞清楚数据怎么喂进去 | 单资产数据 | 列名映射、时间索引与六项数据体检 |
| 不确定该不该用它 | 能力边界 | 与组合级框架、向量化框架的定位差异与替代路径 |
| 想先拿到结论再决定自建 | 本站「对比」页 → 本机技能路线 | 两条路线是并列的研究方式,无已证实集成 |
下面七种现象覆盖了初次使用 Backtesting.py 最容易卡住的地方,按「处理方式」逐条试;具体报错原文、依赖约束与版本差异请以官方 README、文档与本地终端提示为准。
| 现象 | 常见原因 | 处理方式 | 提前规避 |
|---|---|---|---|
| 安装时报依赖或版本冲突 | 当前环境的包版本与官方要求不一致 | 换一个干净的虚拟环境重装,再对照官方 README 核对版本要求 | 每个项目独立环境,避免与系统包混装 |
| 导入时报缺少模块 | 装到了另一个解释器,或可选依赖没装 | 确认 pip 与运行脚本用的是同一个解释器;按需补装依赖 | 安装后立即跑一次导入自检 |
| 回测报数据列或索引相关错误 | 缺 Open/High/Low/Close 列,或索引不是时间类型 | 把数据整理成「时间索引 + 开高低收量」,去掉多余列 | 取数后就做一次列名与索引检查 |
| 策略看起来跑通但收益异常高 | 用了当时还看不到的信息(前视偏差) | 检查 next 里是否引用了当前 bar 之后的数据,把决策改为只用已收盘信息 | 写完策略先用极简标的与短区间做手算抽查 |
| 参数扫描很慢或内存吃紧 | 网格过大或候选组合数增长过快 | 先粗扫再局部加密,必要时分批运行 | 扫描前先估算组合数,别一上来就全网格 |
| 优化结果换一段区间就失效 | 在样本内挑到了孤立高点 | 看参数邻域是否稳定成片,并用样本外区间复核 | 把「稳定区间」设为选参标准,而不是单点最高 |
| 图表打不开或输出很大 | 绘图需要一个可用的浏览器环境,图多时体积会膨胀 | 先确认浏览器环境与运行方式,必要时减少一次绘制的标的数量 | 批量实验阶段先不出图,只保留统计结果 |
它是给开发者用的 Python 库,不是图形界面软件:策略、数据准备与运行都由你自己写脚本完成,换来的是可复现与可版本管理。安装、依赖与接口以官方 README 与文档为准。
Backtesting.py 的官方安装方式是 pip install backtesting,README 与 PyPI 标注了 Python 版本要求与依赖(含 pandas 与 bokeh)。不同版本的要求会变,装前请以官方 README、PyPI 页面与本地终端提示为准;建议先建一个独立虚拟环境,避免与系统里已有的包互相牵制,也方便出问题时整个环境删掉重来。
Backtesting.py 采用 AGPL-3.0 许可:可自由使用与修改,但 AGPL 对分发与网络服务有传染性要求。是否可用于你的商业场景,请以官方仓库 LICENSE 原文与你的法务判断为准,本页不构成法律意见。
Backtesting.py 的官方说明不支持多资产组合与分数股交易,它面向单资产、bar 级的策略回测。若你需要组合级资金分配或跨品种对冲,应选择支持这些能力的框架;具体限制以官方 README 与文档为准。
它接受任意 OHLC(V) 蜡烛数据,只要整理成「时间索引 + 开高低收量」的表格即可。A 股数据的获取、复权口径与缺失值处理需要你自己完成,数据源与字段含义以对应数据源的官方文档为准;取数之后建议先做一次「索引是否单调递增、是否有重复日期、是否有零价或负价」的基本体检,再拿去跑回测。
不能。回测只反映历史区间表现,受数据、参数与市场环境假设影响,写库本身也不含券商下单通道。把它当成研究工具、用样本外区间与成本假设反复验证,才是稳妥的用法;本页内容不构成投资建议。
带「本站实测」字样的数字都是在 Windows + Python 3.11.9 + backtesting 0.6.6 环境下真实运行得到的,区间与成本口径写在每个表格附近,复现脚本与原始输出随本项目研究材料归档(lab/ 目录)。未实测的内容会明确标注「本站未实测」(例如幸存者偏差与冲击成本),不会用推断替代证据;具体实现仍以官方仓库与文档为准。
因为回测最常见的损失不是「算错」,而是「把历史巧合当成规律」:实测中样本内 89/98 组参数赚钱、样本外 0/98 组赚钱。早点知道这一点,比多学一个策略模板更省时间。至于优势与合适场景,见「什么时候适合、什么时候不适合」一节。